Python使用urllib2与正则表达式抓取网站图片并保存至本地
本文介绍利用Python标准库urllib2和re模块编写简单爬虫,通过正则表达式匹配网页源码中的图片链接,并使用urlretrieve函数将JPG图片批量下载至本地指定目录的完整代码示例与步骤说明。
2026-10-13
6

本文介绍利用Python标准库urllib2和re模块编写简单爬虫,通过正则表达式匹配网页源码中的图片链接,并使用urlretrieve函数将JPG图片批量下载至本地指定目录的完整代码示例与步骤说明。
本文介绍如何利用Python的urllib2和cookielib库实现网页自动登录。通过构建包含CookieJar的Opener对象,模拟浏览器发送POST请求完成身份验证,并自动保存会话Cookie。后续请求携带该Cookie即可访问需登录的页面,以人人网为例展示了具体实现逻辑。
本文提供了一段Python脚本,演示如何使用urllib2发起HTTP请求并解析返回的JSON数据。代码包含文件读取、URL拼接、请求发送及JSON字段提取等步骤,适用于需要处理接口返回数据的场景。
本文介绍使用Python编写网易网络爬虫的完整示例,通过urllib2请求页面、正则表达式提取标题及文本内容,并将结果保存至TXT文件。代码基于Python 2.7开发,涵盖页面加载、编码转换及数据存储流程,适合Python初学者参考学习网络爬虫基础实现。
本文详细介绍如何利用Python标准库中的urllib和urllib2模块发起HTTP GET和POST请求。通过具体代码示例,演示了如何构造查询字符串进行GET请求,以及如何发送JSON数据执行POST请求,并结合轻量级Web服务器boa和CGI脚本验证了请求的有效性,适合需要处理基础HTTP交互的开发者参考。
本文介绍基于Python的爬虫实现方案,核心依赖urllib2进行HTTP请求与源码获取,利用BeautifulSoup解析HTML结构。文中提供了完整的类封装代码,涵盖分页链接生成、页面内容提取及数据存储功能,适用于基础网页数据采集场景。
本文介绍在Fedora12和Python2.6.2环境下,利用urllib、urllib2及cookielib模块实现自动登录百度空间的Python代码。通过构建请求并处理Cookie,程序成功登录并获取页面内容,验证了跳转至个人主页的功能。
本文介绍在Python2.7环境下,利用淘宝开放接口查询IP地址地理位置的方法。通过urllib2发送HTTP请求并解析返回的JSON数据,可获取国家、地区、城市等信息。文中包含完整代码示例及运行结果,并推荐了相关的IP查询与网络计算工具供参考。
本文介绍如何在Python中通过自定义urllib2 Handler实现手动插入Cookie。由于标准库HTTPCookieProcessor缺乏直接设置Cookie的方法,通过继承BaseHandler并实现http_request方法,可将指定Cookie强制写入Request Header。该方法兼容现有Cookie处理流程,适用于需要客户端手动控制Cookie值的场景。
本文详解利用 Python 实现网站自动登录的原理与代码实例。针对 HTTP 无状态特性,介绍通过 Cookie 维持会话的方法。以 QZZN 论坛为例,展示如何使用 urllib2 构建 opener 并配置 HTTPCookieProcessor 自动处理 Cookie。代码解析涵盖数据编码、表单字段分析及 POST 请求发送,适用于多数 PHPWind 类型论坛,并提供 GET 方式下的操作差异说明。
本文详解Python爬虫中常见的403禁止访问错误原因,介绍通过urllib2模块添加User-Agent、Host和Referer等请求头来伪装浏览器访问的方法,并提供封装好的随机User-Agent选择函数代码,帮助开发者绕过基础反爬限制。
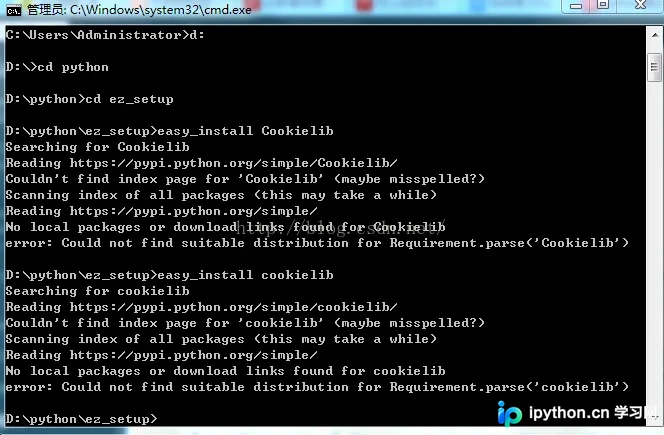
本文详解Python爬虫中利用cookielib模块实现模拟登录的方法。通过构建CookieJar及子类MozillaCookieJar,结合urllib2的build_opener,可自动捕获并保存网站Cookie。文章涵盖从获取Cookie、保存到文件(cookie.txt)再到读取Cookie访问受限页面的完整流程,帮助开发者突破游客限制,高效抓取目标网页数据。