

Python2.7中os.path.isdir处理中文路径返回False的解决方案
本文解决Python2.7环境下os.path.isdir等路径判断方法对含中文路径返回False的问题。通过对比IDE与交互式命令行执行结果,定位原因为字符串编码差异。核心解决方案是将中文路径字符串转换为Unicode对象,例如使用u前缀或unicode()函数,确保路径处理一致性与准确性。
2026-10-13
6

本文解决Python2.7环境下os.path.isdir等路径判断方法对含中文路径返回False的问题。通过对比IDE与交互式命令行执行结果,定位原因为字符串编码差异。核心解决方案是将中文路径字符串转换为Unicode对象,例如使用u前缀或unicode()函数,确保路径处理一致性与准确性。
本文介绍了在Python中统计字符串内中文字符数量的两种主要方法。第一种通过遍历字符并判断其所属类别(英文、数字、中文等)进行计数;第二种则利用Unicode编码范围(\u4e00至\u9fff)直接筛选中文字符。两种方法各有适用场景,可根据具体需求选择使用。
本文深入解析Python字符串的本质,阐述其作为Unicode码点不可变序列的定义。详细梳理ASCII、GB2312到Unicode及UTF-8的编码演进,并对比Python与Java在字符串定义、多行支持及字符处理上的差异,帮助开发者理解底层原理与跨语言特性。
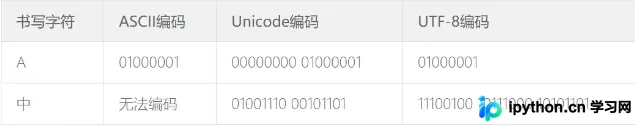
本文介绍在Python中分离中英文文本的两种常用方法。针对超短文本,可通过ASCII码值直接过滤;对于复杂混合文本,利用Unicode编码范围\u4e00-\u9fa5及正则表达式匹配英文字符与空格,实现精准提取。
本文介绍Python中将形如\\uXXXX的字符串转换为实际中文的方法。针对re库替换报错问题,推荐使用json.loads处理JSON格式字符串;针对Python3中str无decode属性,提供encode('utf-8').decode('unicode_escape')的正确写法,解决编码转换难题。
本文提供Python实现根据Unicode编码范围判断字符语言类型的完整代码。通过定义汉字、数字、英文字母及非汉字字符的判断函数,结合全角半角转换与字符串格式化功能,实现将输入字符串按中文、字母和数字进行分离处理,适用于多语言文本的基础分类场景。
本文介绍在Python中将Unicode字符串(如u'\u810f\u4e71')转换为普通字符串的方法。核心技巧是利用encode('unicode-escape')配合decode('string_escape')实现编码转换,适用于需要处理原始Unicode转义序列的场景。
本文详细解析Python中中文排序的难点,指出GB2312与Unicode编码导致的排序混乱问题。通过构建包含拼音、笔画及笔顺的字典,实现符合新华字典规范的中文排序。提供完整的Python代码示例,支持按拼音四声及笔画顺序排列汉字,解决多音字外的常规排序需求。
针对Python中正则表达式如何精准提取和匹配中文汉字的问题,本文提供两种主流实现路径。通过调用内置re模块,分别采用Unicode标准编码范围与直写字面量区间的方式,配合findall函数过滤混合文本中的非中文字符。代码已适配Python 3环境,附带完整示例与参数解析,可直接复制用于爬虫清洗或数据校验场景。

本文详细解析Python中正则表达式匹配中文的核心原理,重点讲解 `\u4e00-\u9fa5` 编码范围的使用。通过 re 模块的 `search` 和 `findall` 方法,演示如何精准提取单个中文字符、连续中文片段及所有中文内容。文章涵盖字符集范围说明及编码注意事项,帮助开发者解决跨语言文本处理中的匹配难题。
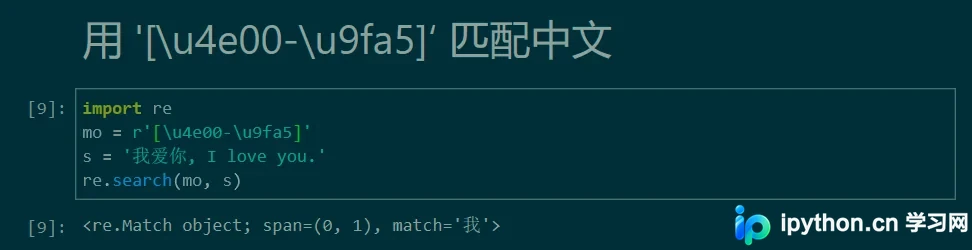
本文介绍在 Python 3.x 环境下,利用正则表达式提取中文字符的两种常见场景:读取包含中文的文本文件以及处理给定的字符串。核心在于使用 Unicode 范围 [\u4e00-\u9fa5] 进行匹配,并需注意文件读取时的编码处理及字符串转义问题。
本文介绍在Python中如何从包含多种字符的字符串中提取并保留汉字。通过定义判断Unicode范围的函数,遍历字符串并筛选出汉字字符,最终拼接成纯汉字字符串。该方法适用于需要清理文本数据或提取特定语言内容的场景。