
TensorFlow中如何查看梯度:解决不收敛问题的实用指南
本文介绍在TensorFlow中通过tf.gradients()函数查看梯度的方法。针对模型训练时Loss不收敛的情况,分析梯度消失(趋近0)和梯度爆炸(数值过大)的原因,并给出调整权重初始化或使用ResNet等结构的建议。
2026-10-13
6


本文介绍在TensorFlow中通过tf.gradients()函数查看梯度的方法。针对模型训练时Loss不收敛的情况,分析梯度消失(趋近0)和梯度爆炸(数值过大)的原因,并给出调整权重初始化或使用ResNet等结构的建议。
本文介绍TensorFlow中设置日志级别的两种主要方式:通过环境变量TF_CPP_MIN_LOG_LEVEL屏蔽C++底层日志,以及使用tf.logging模块控制Python日志输出。详细说明了环境变量的永久与临时设置方法,指出了os.system()的常见错误用法,并推荐了tf.logging.set_verbosity()的标准实现。
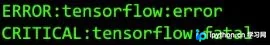
本文介绍如何在 TensorFlow 中通过设置环境变量 TF_CPP_MIN_LOG_LEVEL 来屏蔽不同级别的日志输出。该参数支持 0 至 3 四个值,分别对应输出所有信息、屏蔽通知、屏蔽通知与警告、以及屏蔽所有非错误信息。通过具体代码示例展示了各取值下的实际输出效果,帮助开发者优化控制台显示。
本文详细介绍如何使用TensorFlow构建简单的多层神经网络来解决XOR(异或)线性不可分问题。通过定义输入输出、权重初始化、ReLU激活函数及Adam优化器,逐步演示模型训练过程。文章包含完整Python代码示例,并分析学习率与迭代次数对损失函数的影响,帮助初学者理解神经网络的基本原理与调参技巧。

本文详细解决TensorFlow在CPU环境下运行时报出的AVX2指令集不支持警告。通过创建独立的Anaconda虚拟环境,从指定仓库下载预编译的whl文件并手动安装,可彻底消除警告并提升计算性能,特别适合无GPU配置的开发者。

本文介绍解决TensorFlow运行时提示CPU支持AVX/AVX2指令集但二进制未编译的两种方案。一是通过设置环境变量忽略警告,二是卸载当前版本并下载针对AVX优化的官方预编译包重新安装,确保环境兼容。

在使用 Python 和 TensorFlow 进行 GPU 模型训练时,默认配置会占用全部显存,可能导致多进程任务崩溃。本文介绍两种限制显存的方法:一是按比例预留固定显存(如 50%),二是开启自适应增长模式。通过配置 ConfigProto 对象,可有效避免显存溢出,提升多进程管理的稳定性与资源利用率。
本文总结了在TensorFlow中指定使用特定GPU及进行GPU资源分配的几种常用方法。包括通过终端环境变量和代码中tf.device指定单卡或多卡运行,以及利用ConfigProto配置允许GPU内存增长或固定分配比例,帮助开发者优化多GPU环境下的模型训练效率。
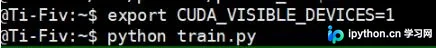
本文介绍如何在 TensorFlow 中指定使用的 GPU 并动态分配显存。通过命令行设置 CUDA_VISIBLE_DEVICES 环境变量可限制可见 GPU,使用 nvidia-smi 查看状态。在 Python 代码中,通过修改 os.environ 和配置 tf.ConfigProto 的 allow_growth 属性,实现按需分配显存,避免内存溢出。
本文详解TensorFlow默认占用全部GPU显存的机制及其潜在问题。重点介绍两种核心配置:allow_growth实现内存按需动态分配,避免初始过度占用;per_process_gpu_memory_fraction通过设定比例固定显存上限。通过ConfigProto配置,可有效缓解显存碎片并提升多进程环境下的资源利用率,适用于模型训练与部署场景。
本文介绍验证TensorFlow是否成功调用GPU的两种方法。一是通过配置log_device_placement=True查看启动日志,若显示GPU设备信息则表明已启用;二是运行高负载计算任务后,使用nvidia-smi命令监控显存占用情况。
本文详解在 TensorFlow 中通过 ConfigProto 配置 GPU 显存占用策略。涵盖按比例固定分配(per_process_gpu_memory_fraction)与自适应增长(allow_growth)两种模式,并介绍如何利用 CUDA_VISIBLE_DEVICES 环境变量在多台 GPU 环境中指定计算设备,帮助优化内存使用并避免 OOM 错误。