
TensorFlow 2.1.0 安装报错解决:setuptools、wrapt 及 CUDA 驱动配置指南
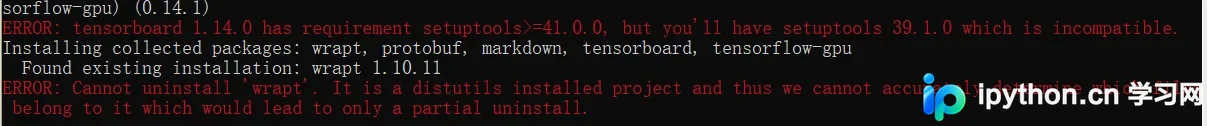
本文详细记录 TensorFlow 2.1.0 安装过程中遇到的 setuptools 版本过低、wrapt 包冲突及 CUDA 初始化失败等常见错误。通过升级 pip 和 setuptools、强制安装依赖包以及核对 NVIDIA 显卡驱动版本,提供了一套完整的错误排查与修复方案,帮助开发者顺利配置 GPU 环境。
2026-10-13
6


本文详细记录 TensorFlow 2.1.0 安装过程中遇到的 setuptools 版本过低、wrapt 包冲突及 CUDA 初始化失败等常见错误。通过升级 pip 和 setuptools、强制安装依赖包以及核对 NVIDIA 显卡驱动版本,提供了一套完整的错误排查与修复方案,帮助开发者顺利配置 GPU 环境。
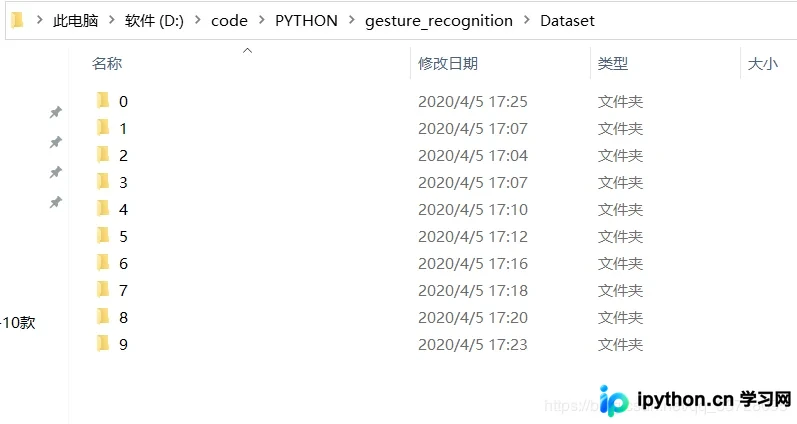
本文详细介绍如何使用 TensorFlow 2.x 构建自定义图像数据集以训练手势识别模型。内容涵盖从摄像头采集图片、整理目录结构、读取文件路径,到使用 tf.data 进行图像预处理和批量加载的全过程。通过具体代码示例,展示如何构建训练集与测试集,为后续模型训练奠定基础。
本文详细介绍在PyCharm中配置PyQt5的完整流程,特别针对Anaconda虚拟环境及TensorFlow环境用户。内容涵盖通过pip安装PyQt5和PyQt5-tools,验证安装结果,以及在PyCharm中设置QtDesigner和PyUIC外部工具。最后通过创建Demo项目,演示从UI设计到Python代码生成的实际操作,帮助用户快速掌握GUI开发环境搭建。
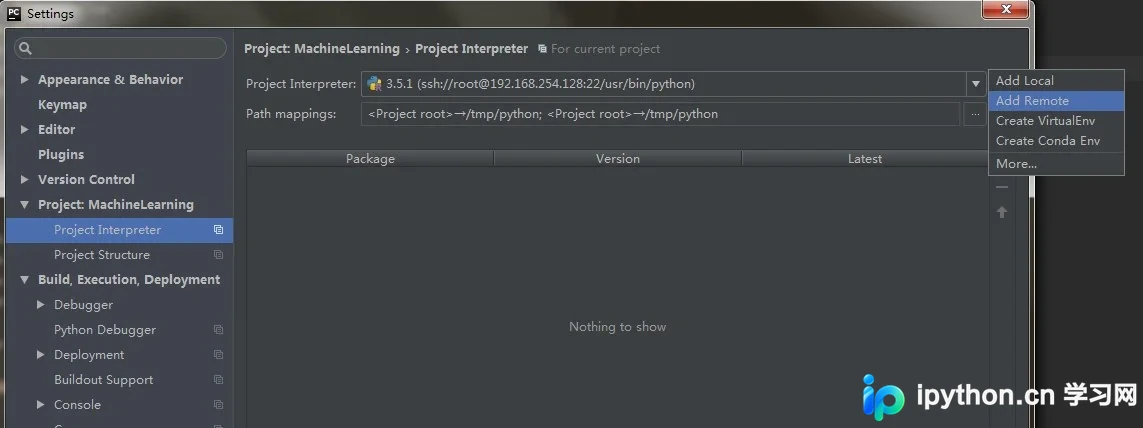
本文详解如何在 Windows 下通过 PyCharm 远程连接虚拟机中的 CentOS Python 环境。涵盖固定 IP、SSH 配置、解释器添加、SFTP 部署设置及代码同步运行步骤,适用于 TensorFlow 等 Linux 依赖库的开发调试。
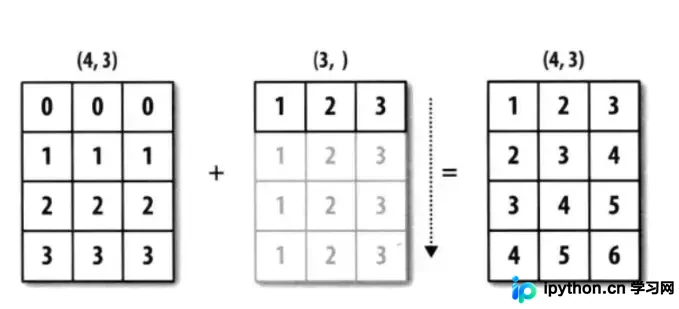
本文深入解析 NumPy 与 TensorFlow 中的 Broadcasting 广播机制。通过标量、二维及三维数组的具体案例,详细阐述后缘维度匹配规则、形状扩展逻辑及常见报错处理,帮助开发者高效进行张量运算。
本文详解TensorFlow中多分类与二分类损失函数的使用。重点解析SparseCategoricalCrossentropy与CategoricalCrossentropy在输入格式(标签编码方式)及from_logits参数上的区别,并介绍BinaryCrossentropy在二分类场景下的应用。通过代码示例说明softmax与sigmoid激活函数的搭配原则,帮助开发者正确选择损失函数以优化模型训练。
本文介绍在 TensorFlow 中通过固定随机数种子来确保神经网络训练结果可复现的方法。针对参数初始化和数据读取中的随机操作,使用 tf.set_random_seed 函数设置统一种子,从而在输入数据相同的情况下获得一致的训练输出。
本文探讨在TensorFlow中使用tfrecord存储浮点数数组时遇到的精度丢失问题。通过对比tobytes()二进制存储与直接序列化,揭示了二进制转换导致的精度损失,并提供了正确的代码实现,包括如何保存和读取浮点数组,确保数据完整性。
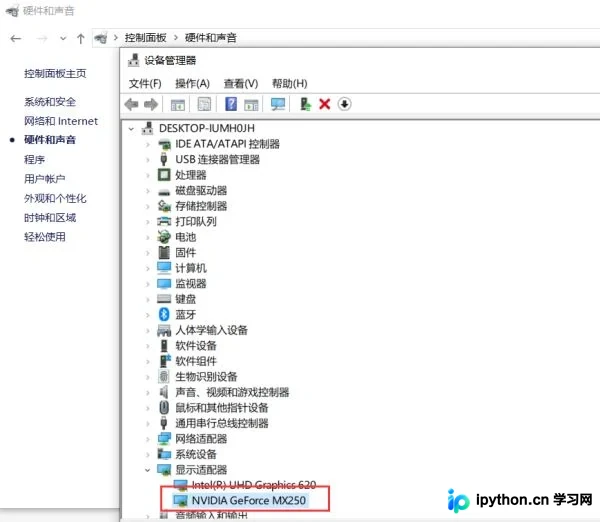
本文详细记录了在Windows 10系统中为NVIDIA MX250显卡配置TensorFlow GPU环境的全过程。针对旧版tensorflow-gpu 1.8.0,文章指导用户正确安装CUDA 9.0及对应版本的cudnn,并解决Anaconda版本兼容性问题。通过Python 3.6环境下的实际测试,展示了GPU加速训练带来的显著速度提升,为使用较老硬件进行深度学习开发提供了参考方案。
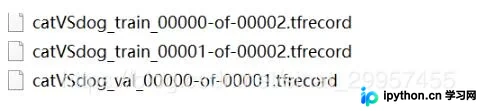
本文详细介绍 TensorFlow 中三种数据读取方式,重点讲解如何使用 TFRecord 格式保存和读取图片数据。通过 Slim 库实现高效的数据序列化与反序列化,涵盖从文件路径获取、参数配置到批量读取的完整流程,适用于大规模图像数据集的训练与验证。
本文详细介绍 TensorFlow 中实现数据类型转换的核心函数,包括 tf.to_bfloat16、tf.to_complex128、tf.to_complex64、tf.to_double、tf.to_float、tf.to_int32 及 tf.to_int64。内容涵盖各函数的参数定义、返回值类型、潜在异常处理及代码示例,帮助开发者准确进行张量类型强制转换。
本文提供使用 TensorFlow 批量生成多个 TFRecord 文件的完整代码示例。通过设定 shard 数量和每个 shard 的数据量,遍历指定目录下的图片资源,调整尺寸并序列化写入多个 TFRecord 文件,适用于大规模图像数据的模型训练准备。