Python实现文件内容正则匹配与数据提取
本文介绍如何使用Python打开文件并利用正则表达式对内容进行匹配处理。通过定义特定的正则模式,程序可以逐行读取文件,提取符合格式要求的数据字段(如16位数字和3位数值),并对提取结果进行进一步的字符串格式化处理,适用于需要批量处理结构化文本数据的场景。
2026-10-13
6

本文介绍如何使用Python打开文件并利用正则表达式对内容进行匹配处理。通过定义特定的正则模式,程序可以逐行读取文件,提取符合格式要求的数据字段(如16位数字和3位数值),并对提取结果进行进一步的字符串格式化处理,适用于需要批量处理结构化文本数据的场景。
本文介绍在Python中利用json模块将字符串转换为JSON对象的方法。通过json.loads()解析字符串获取对象,并演示如何直接提取特定字段值;同时使用json.dumps()将对象还原为字符串,涵盖常用操作示例。
本文介绍在Python中处理包含中文Key的JSON字符串的方法。通过示例展示了如何定义含中文键的字典,利用json模块进行序列化和反序列化,并演示了如何正确解码中文字符以提取对应值,确保数据处理的准确性。
本文介绍在Python中修改TXT文件特定内容的实用方法。由于Python对TXT仅有读写操作,需通过读取所有行至列表,修改目标数据后重新写入新文件的方式实现。文中提供了完整的代码示例,演示如何将视频帧数转换为时间并更新格式,供开发者参考。
本文介绍利用Python的pymysql库将TXT文档中的每行内容循环插入MySQL数据库的方法。通过正则表达式提取关键字段,结合游标执行SQL插入语句,实现数据自动化入库。
本文介绍使用Python生成XML报文的两种常见方法。第一种通过循环自增ID并拼接时间戳生成基础报文,适用于MQ接口发送场景;第二种基于预定义模板,利用列表遍历和字符串替换功能生成多行XML节点。代码包含完整实现逻辑,可直接参考用于实际开发中的报文构造需求。
本文介绍如何使用Python的re模块匹配两个指定短语之间的字符。通过open读取文件,利用re.findall配合非贪婪模式.*?提取目标内容,并遍历打印结果。
本文详细介绍如何利用Python的re模块通过正则表达式分别匹配IP地址、URL网址以及电子邮件地址。文章提供了具体的正则模式代码及测试示例,帮助开发者快速掌握网络数据格式验证的核心技巧。
本文介绍如何利用 Python 正则表达式精准匹配字符串中的 HTTP 及 HTTPS 链接。通过编译特定模式,可有效识别包含特殊字符、百分号编码及子域名的 URL。示例代码展示了从文本中提取短链接的全过程,为网络爬虫和数据清洗提供实用参考。
本文介绍如何利用Python的re模块及正则表达式,精准提取两个指定字符或字符串之间的内容。通过示例代码演示findall函数的用法,展示如何从包含特定标记的文本中获取目标子串,适用于日志解析及数据清洗场景。
本文介绍在Python中利用正则表达式清除两个特定特殊字符之间内容的实现方法。通过示例展示如何定位并移除指定范围内的文本,适用于日志清理、模板处理等场景。
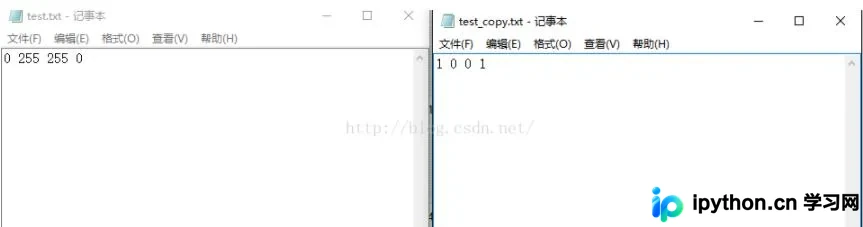
本文介绍了使用Python读取txt文件内容并修改字符的方法。通过遍历读取的每一行数据,将数值0替换为1,将255替换为0,最后将处理后的结果写入新的txt文件。虽然算法复杂度较高,但实现了预期的数据转换功能,适合需要简单文本处理场景的参考。