

Python利用BS4与正则提取HTML正文文本框
本文介绍使用Python从HTML页面中提取主要文本框的方法。通过BS4遍历所有div标签,利用正则表达式筛选并统计每个div内的中文字数,最终选取中文内容最长的div作为正文区域。文章提供了完整的requests请求、正则匹配及BeautifulSoup解析代码示例,适用于CSDN等博客类网站的正文抓取场景。
2026-10-13
6

本文介绍使用Python从HTML页面中提取主要文本框的方法。通过BS4遍历所有div标签,利用正则表达式筛选并统计每个div内的中文字数,最终选取中文内容最长的div作为正文区域。文章提供了完整的requests请求、正则匹配及BeautifulSoup解析代码示例,适用于CSDN等博客类网站的正文抓取场景。
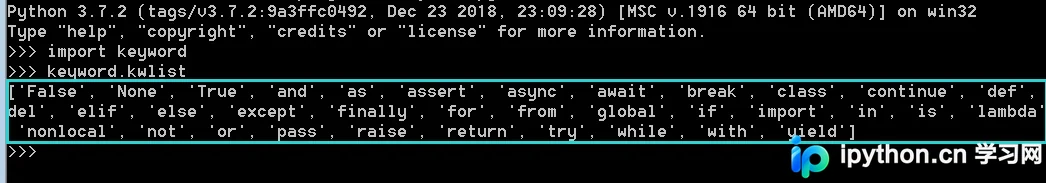
本文详细解析Python3的变量命名规则,包括保留字、标识符规范及下划线含义。深入讲解Number、String、List、Tuple、Set、Dictionary六大标准数据类型,区分不可变与可变数据特性,并重点阐述整数进制表示、字符串不可变性、索引切片及转义字符处理等核心用法。
本文详细解析Python中字符串、元组、列表和字典四种核心数据类型的相互转换方法。通过具体代码实例,展示如何将字典转换为字符串、元组或列表,以及元组和列表如何转换为字符串或其他类型。同时涵盖利用eval函数处理字符串以生成元组、列表或字典的技巧,并提供完整的转换代码参考。
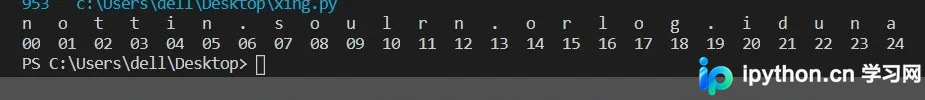
本文介绍如何在Python中直观输出字符串及其对应的下标。通过结合rfind定位与for循环遍历,实现字符与索引的对齐显示。重点讲解利用%02d进行数字格式化,确保多位数下标整齐对齐,提升代码可读性与调试效率。
本文介绍如何使用Python正则表达式验证IP地址,提供完整的代码示例。通过re模块的compile、finditer及search方法,演示如何提取IP地址及捕获分组信息,适用于网络数据处理场景。
本文详细解析Python re模块中贪婪与非贪婪模式的匹配机制。通过对比示例,说明默认贪婪模式尽可能匹配最长字符串,而非贪婪模式通过添加问号“?”实现最少匹配。文章提供具体代码案例,展示如何正确处理数字提取等场景,帮助开发者精准控制正则表达式的匹配行为。
本文详解Python中访问字符串值的三种核心方法:通过索引下标获取指定字符、利用[start:stop:step]语法进行切片截取,以及使用for循环遍历字符串。内容涵盖索引规则、切片参数含义及负数步长处理,并附带完整代码示例,帮助开发者快速掌握字符串操作技巧。
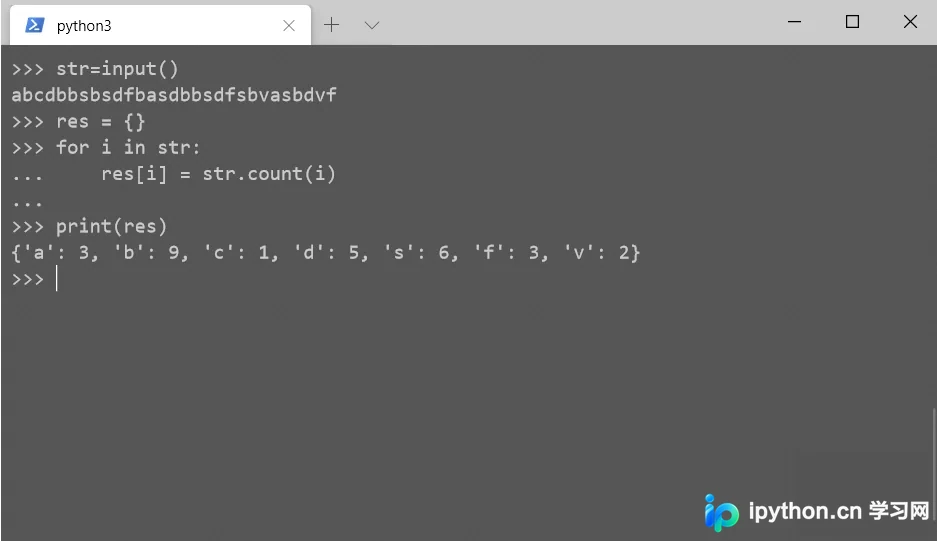
本文详细介绍在Python中统计字符串内各字符出现次数的方法。通过input获取用户输入,利用for循环遍历字符串,并结合内置的str.count()函数统计每个字符的频率。最终结果存储于字典中并输出,展示了Python处理文本数据的简洁与高效。
本文详细介绍Python中字符串count()函数的用法。该函数用于统计指定字符或子串在字符串中出现的次数,支持通过起始和结束索引限定搜索范围。文章提供了详细的语法说明、参数解释以及多个代码运行示例,帮助开发者快速掌握字符串计数技巧。
本文详解 Python 中使用 % 操作符进行字符串格式化的方法。通过 %s、%d、%f 分别处理字符串、整数和浮点数,并利用 %.nf 精确控制浮点数的小数位数。结合元组与列表的格式化示例,展示如何简化 print 函数的变量拼接操作,提升代码可读性与执行效率。
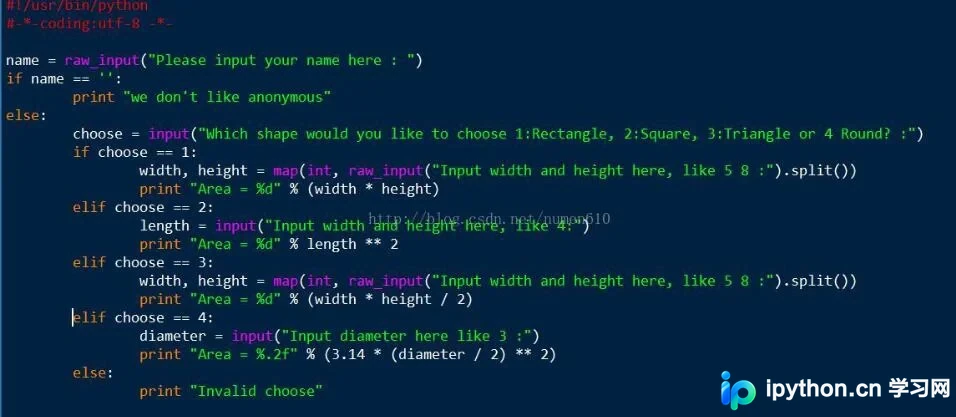
本文介绍使用Python编写程序计算长方形、正方形、三角形及圆形面积的实例。重点解析如何通过map函数处理多参数输入,以及利用%.2f格式化输出保留两位小数,帮助初学者掌握基础输入输出与数学计算逻辑。
本文解析Python中replace()函数看似替换无效的原因。由于Python字符串是不可变对象,直接调用replace()不会修改原变量,必须将返回值重新赋值给变量。通过对比错误代码与正确示例,帮助开发者理解引用机制,避免常见陷阱。