

Python字符编码演进与Python2/3差异解析
本文梳理了从ASCII到UTF-8的字符编码发展史,重点解析Python2与Python3在字符串处理上的核心差异。通过具体代码示例,展示了Python2中字节串与Unicode互转的decode/encode流程,以及Python3中字符串直接编码为字节串的新机制,帮助开发者理解不同版本下的编码转换逻辑。
2026-10-14
7

本文梳理了从ASCII到UTF-8的字符编码发展史,重点解析Python2与Python3在字符串处理上的核心差异。通过具体代码示例,展示了Python2中字节串与Unicode互转的decode/encode流程,以及Python3中字符串直接编码为字节串的新机制,帮助开发者理解不同版本下的编码转换逻辑。
本文深入解析Python中正则表达式精准匹配时间格式的方法。通过对比基础匹配与严格范围校验,详细拆解时、分、秒的正则逻辑,并提供完整代码示例及在线测试工具推荐,帮助开发者避免无效时间格式匹配,提升数据处理的准确性。
本文详细记录了使用Python编写小说爬虫的全过程。文章从确定目标网址、分析页面结构入手,重点讲解了如何使用urllib.request获取网页内容,并通过设置Headers解决403 Forbidden错误。同时,针对常见的编码乱码问题,介绍了使用chardet库检测编码及手动指定GBK编码的方法,并结合socket.timeout处理网络超时异常,最终通过正则表达式提取章节内容并写入文件,提供了完整的代码实现参考。
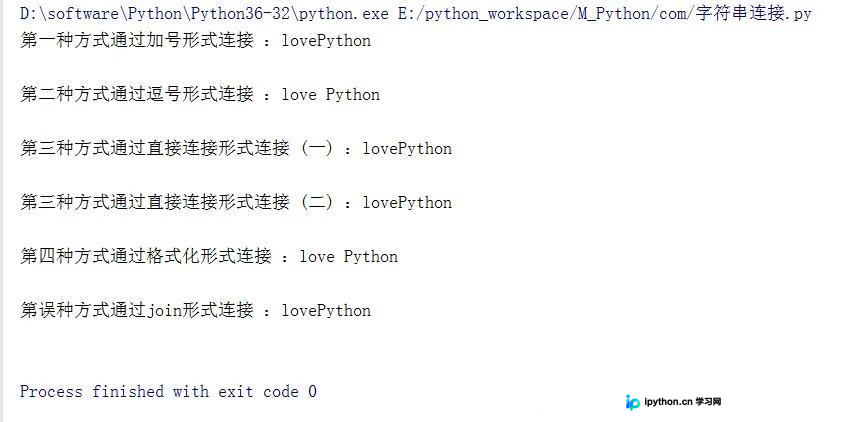
本文系统梳理了Python中实现字符串拼接的五种核心方法,包括使用加号运算符、逗号分隔符、直接相邻连接、百分号格式化以及join函数。通过具体代码示例对比各方法的语法特点与适用场景,帮助开发者根据实际需求选择最高效的字符串处理方案。
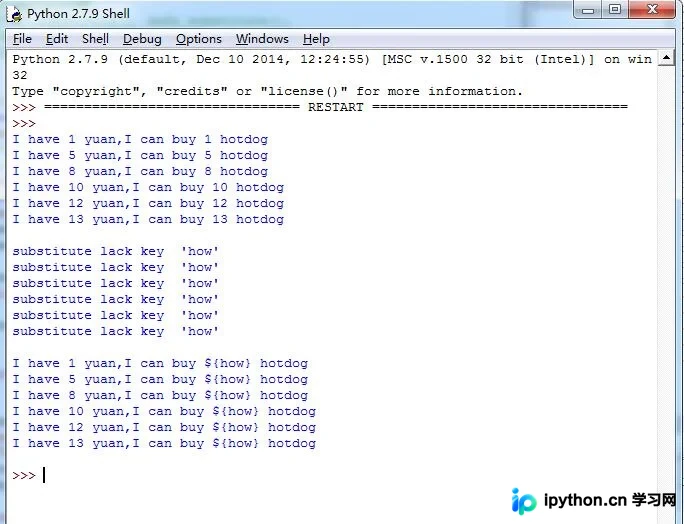
本文深入解析Python中string模块的Template类用法,重点对比substitute与safe_substitute两种格式化方法。通过代码实例展示在键值缺失时,前者抛出KeyError异常而后者保持原字符串不变的行为差异,帮助开发者根据安全性需求选择合适的数据填充策略。
本文详细解析Python中split和strip两个常用字符串处理函数的区别与用法。split用于按指定字符分割字符串,返回列表;strip用于去除字符串首尾指定字符。通过具体代码示例说明两者的行为差异及注意事项,帮助开发者准确掌握字符串操作技巧。
本文详解Python正则表达式中的分组机制,包括无名分组与命名分组的语法及提取方法。深入解析后向引用实现字符串交换,以及前向/后向肯定与否定断言在复杂匹配中的应用,附带代码实例与实用工具推荐。
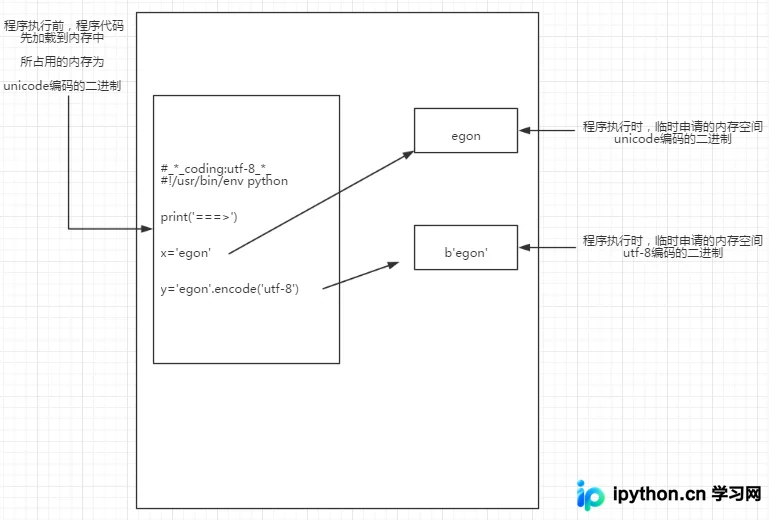
本文深入解析Python字符编码机制,阐述ASCII、GBK、Unicode及UTF-8的发展与区别。重点讲解Python解释器执行流程中文件读写与内存编码转换原理,对比Python2与Python3在字符串类型(str/bytes/unicode)及默认编码策略上的核心差异,帮助开发者避免编码错误。
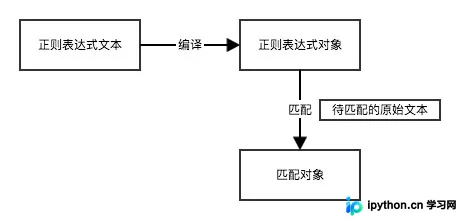
本文系统讲解Python中正则表达式的核心概念,涵盖原始字符串定义、基础与预设元字符、边界与重复匹配、逻辑分支及分组技巧。重点解析贪婪与非贪婪模式,并结合爬虫场景演示如何利用sub函数与正则表达式进行HTML标签处理与路径替换,帮助开发者高效处理文本提取与验证任务。
本文介绍在Python中计算某年某月某日是当年第几天的两种方法。第一种通过手动判断闰年并累加月份天数实现;第二种利用内置datetime模块直接格式化输出。文章还涵盖了从字符串格式如"2016-10-1"解析日期的处理技巧,并提供了完整测试代码及结果验证。
本文详细介绍Python中Beautiful Soup模块修改HTML/XML文档的方法。涵盖修改标签名称与属性、添加新标签、修改及删除字符串内容、移除节点以及使用wrap/unwrap等方法包裹或解包标签。通过具体代码示例,帮助开发者掌握动态修改网页内容的技巧。
本文详解Python标准库string模块中的字符串常量,并深入剖析Template类的用法。通过对比Template、%格式化及format()方法,展示Template类的优势。重点讲解如何通过继承Template类并重写delimiter和idpattern属性,利用正则表达式自定义变量名匹配规则,实现更灵活的字符串模板替换。