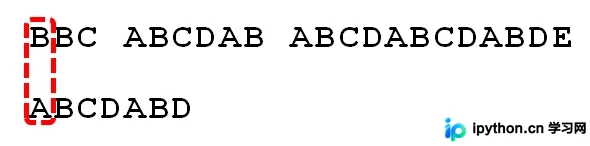
KMP字符串匹配算法原理与Python实现详解
本文深入解析Knuth-Morris-Pratt(KMP)字符串匹配算法的核心原理,重点阐述如何利用部分匹配表(Partial Match Table)优化移动步数,避免传统回溯的低效。通过具体示例演示匹配过程,并提供完整的Python代码实现,包括partial_table和kmp_match函数的逻辑解析,帮助开发者掌握这一经典算法。
2026-10-14
6

本文深入解析Knuth-Morris-Pratt(KMP)字符串匹配算法的核心原理,重点阐述如何利用部分匹配表(Partial Match Table)优化移动步数,避免传统回溯的低效。通过具体示例演示匹配过程,并提供完整的Python代码实现,包括partial_table和kmp_match函数的逻辑解析,帮助开发者掌握这一经典算法。
本文详解Python中三种字符串格式化输出方式:传统的%占位符、Python 2.6引入的format方法以及Python 3.6引入的f-string。通过对比三者的语法特点、性能差异及适用场景,帮助开发者选择最适合的格式化方案,涵盖对齐、进制转换及表达式计算等进阶用法。
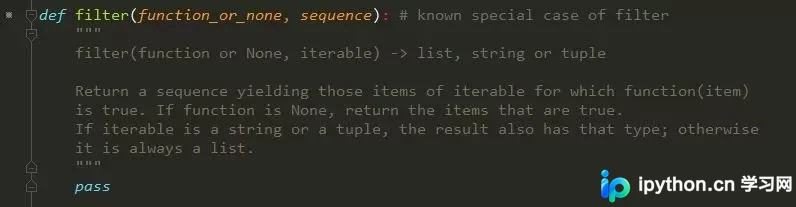
本文介绍如何在Python中实现类似Shell awk工具的多空格分割效果。默认split方法会将连续空格视为多个分隔符,导致结果包含空字符串。通过不加参数的split()或结合filter(None, ...)处理,可自动忽略多余分隔符,返回纯净的分段结果。
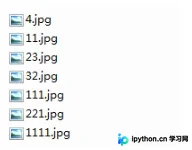
本文介绍了在Python中对文件列表进行排序的两种常用方法。首先演示使用sorted()函数按字符顺序排列文件名,适用于一般字符串排序场景;其次展示利用sort()结合lambda匿名函数,通过截取文件后缀名提取数字部分,实现按数字大小排序。文章包含具体代码示例及运行效果分析,帮助开发者处理如图片文件等需要特定排序逻辑的任务。
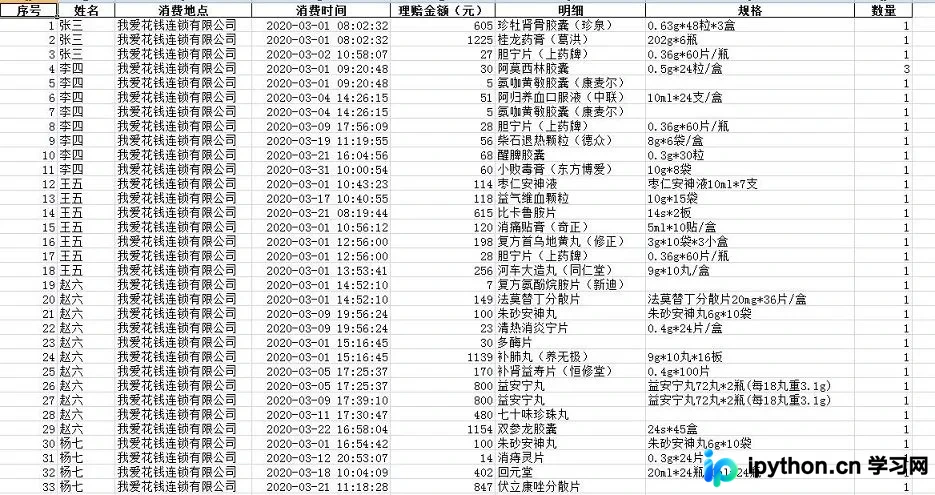
本文详细讲解Python Pandas库中extract和contains两个字符串处理方法的实际应用。通过具体代码案例,演示如何利用extract结合正则表达式从复杂字段中提取明细与规格,以及如何使用contains进行字符串模糊匹配与数据筛选,帮助开发者高效处理DataFrame中的文本数据。
本文深入解析Python中字符串搜索、替换及格式化的常用方法。重点介绍如何使用str.replace()处理简单模式,利用re.sub()结合正则表达式处理复杂文本替换,并通过re.IGNORECASE标志实现忽略大小写的匹配。此外,还涵盖了利用ljust/rjust/center及format()函数进行字符串对齐格式化的具体技巧,帮助开发者高效处理文本数据。
本文深入解析indexOf函数的核心原理,即通过遍历原始字符串并逐字符比对来定位子串下标。文章分别使用Java、JavaScript和Python三种语言实现了该算法,展示了从字符计数到索引返回的完整逻辑,适用于前后端开发场景下的字符串处理需求。
本文详解PHP中正则表达式的贪婪与非贪婪模式。通过`preg_match`实例对比,展示默认贪婪匹配会尽可能多地捕获字符,而添加问号`?`启用非贪婪模式后仅匹配最短符合部分。掌握这一特性可有效优化URL提取、标签解析等场景的正则逻辑。
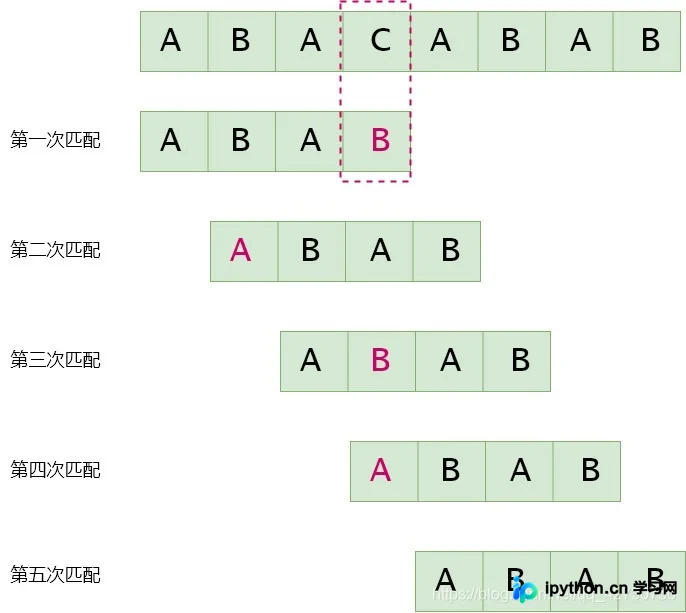
本文深入解析KMP模式匹配算法原理,通过Python代码实现基础KMP与优化版KMP。详细讲解next数组的计算逻辑及其缺陷,引入nextval数组优化策略,解决重复字符导致的无效回溯问题。包含BF算法对比、核心代码实现及匹配次数测试分析,帮助开发者掌握高效字符串匹配技巧。
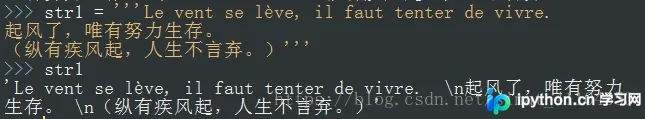
本文详细介绍在Python3中定义跨越多行字符串的三种常用方法。通过三引号保留换行符,利用反斜杠实现逻辑换行,以及使用小括号进行隐式连接。文章包含具体代码示例与f-string格式化应用,帮助开发者根据实际需求选择最合适的字符串处理方式。
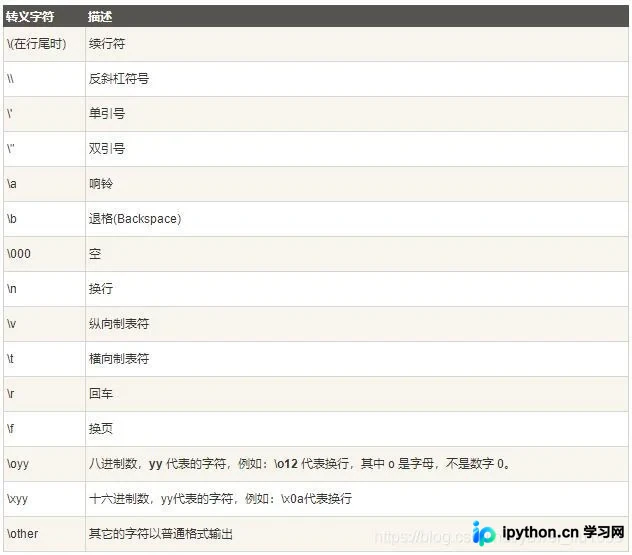
本文深入解析Python中的转义字符机制,详细讲解反斜杠\在定义换行、制表符及引号嵌套时的具体用法。通过对比直接引用与转义引用的差异,阐明如何避免语法错误。同时介绍使用双反斜杠\\表示普通反斜杠,以及利用原始字符串前缀r简化复杂转义序列的最佳实践,帮助开发者写出更清晰、健壮的字符串代码。
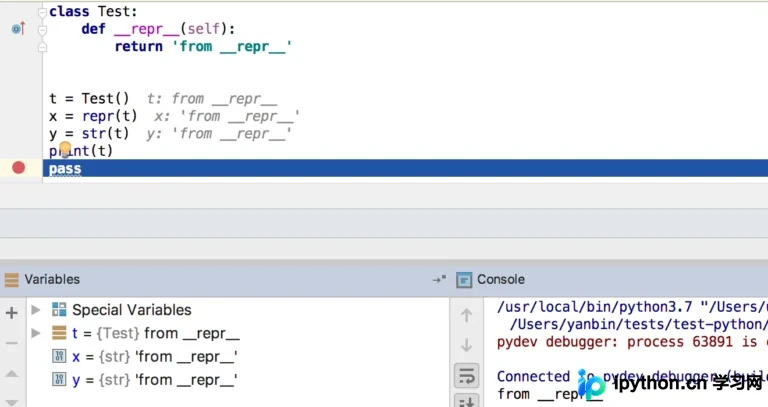
本文深入解析 Python 中 __str__ 和 __repr__ 两个魔术方法的定义与调用时机。通过对比内置类型与自定义类的行为,阐明 repr 作为正式表示在调试和交互环境中的优先级,以及 str 在用户友好输出中的作用。文章还探讨了当仅定义其中一个方法时的回退机制,以及字符串格式化、print 和调试器显示的具体调用逻辑,帮助开发者正确实现对象的可读性与可重现性。