

Python实现KMP字符串匹配算法及next数组优化详解

本文深入解析KMP模式匹配算法原理,通过Python代码实现基础KMP与优化版KMP。详细讲解next数组的计算逻辑及其缺陷,引入nextval数组优化策略,解决重复字符导致的无效回溯问题。包含BF算法对比、核心代码实现及匹配次数测试分析,帮助开发者掌握高效字符串匹配技巧。
KMP算法概述与BF算法对比
前言
本文重点阐述串的KMP模式匹配算法及其改进方案,并提供完整的Python语言实现代码。
1. BF算法
BF算法(Bruce-Force,又称暴力匹配算法)的核心思想是逐位比对。具体做法是将主串S的第一个字符与模式串T的第一个字符进行匹配,若相等,则继续比较S的下一个字符和T的下一个字符;若不相等,则将主串S的指针回溯到上一轮比较的起始位置之后的一位,同时模式串T的指针重置到头部,依次重复上述过程,直至找到匹配结果或遍历完主串。
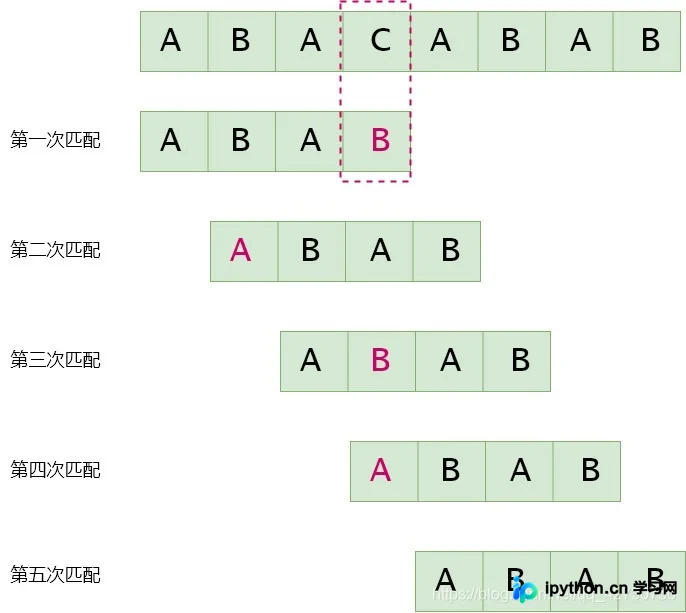
以主串S=ABACABAB,模式串T=ABAB为例,展示匹配过程。每当匹配失败,主串S的指针回溯,模式串T的指针回到起始位置,然后重新进行匹配,具体步骤如下:
def BF(substrS, substrT):
  if len(substrT) > len(substrS):
    return -1
  j = 0
  t = 0
  while j < len(substrS) and t < len(substrT):
    if substrT[t] == substrS[j]:
      j += 1
      t += 1
    else:
      j = j - t + 1
      t = 0
  if t == len(substrT):
    return j - t
  else:
    return -1
KMP算法原理与next数组计算
2. KMP算法
KMP算法由D.E.Knuth、J.H.Morris和V.R.Pratt共同提出,因此也被称为克努特-莫里斯-普拉特算法。其核心思路在于:当匹配失败时,无需将主串S的指针回溯到最近一次开始比较的位置,也无需重置模式串T的指针。相反,算法利用已经匹配成功的部分字符信息,计算出模式串T应该跳转到的下一个比较位置,从而在不改变主串S当前指针的前提下,继续进行模式匹配。
简而言之,KMP算法的关键在于确定当某次匹配失败时,模式串T应该从哪一位开始与主串S的当前字符继续比较。
BF算法虽然思路直观、易于理解,但执行效率较低。在上述匹配过程中,第一次匹配时已匹配的“ABA”部分,其前缀与后缀均为“A”。这意味着在第二次匹配中,这部分比较是冗余的。因此,我们可以跳过第二次匹配,直接进行第三次匹配,即将模式串的前缀位置移动到后缀位置,主串S指针无需回溯,直接从该位继续比较。
为了理解KMP中next数组的计算,需明确以下定义: 前缀:指除最后一个字符外,字符串的所有头部子串。 后缀:指除第一个字符外,字符串的所有尾部子串。 部分匹配值(Partial Match, PM):指字符串的前缀和后缀的最长公共前后缀的长度。 举例说明: - 字符串'a'的前缀和后缀均为空集,最长公共前后缀长度为0; - 字符串'ab'的前缀为{a},后缀为{b},最长公共前后缀为空集,长度为0; - 字符串'aba'的前缀为{a, ab},后缀为{a, ba},最长公共前后缀为{a},长度为1; - 字符串'abab'的前缀为{a, ab, aba},后缀为{b, ab, bab},最长公共前后缀为{ab},长度为2。 注意:前缀一定包含第一个字符,后缀一定包含最后一个字符。
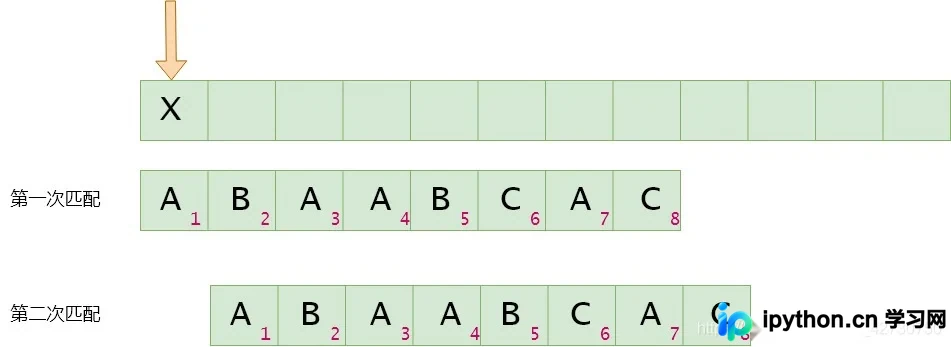
如果模式串的第1号位(索引0)与主串当前位(箭头所指位置)不匹配,则将模式串的第1号位与主串的下一位进行比较。此时next[0]=-1,这是一个特殊值,表示如果主串与模式串的第1位不相同,下次匹配时主串指针后移,模式串指针重置为第2位(索引1,但在逻辑上对应next值-1的处理)。
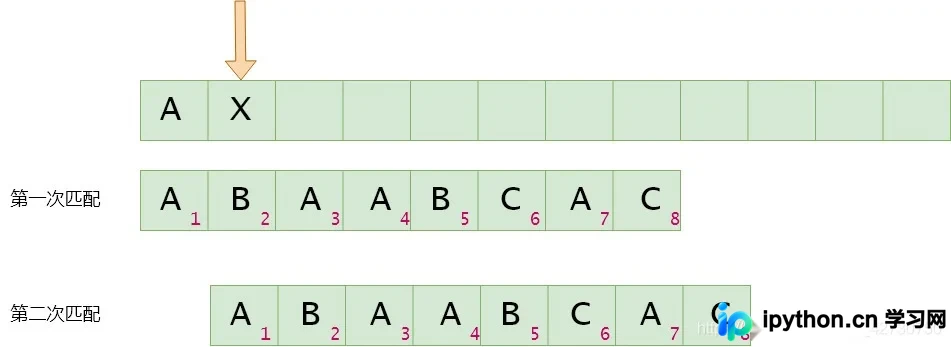
如果模式串的第2号位(索引1)与主串当前位不匹配,需查找最长公共前后缀。此时指针前面的子串为“A”,其最长公共前后缀为空集,长度为0,因此next[1]=0。下次匹配时,将模式串的第1号位与主串的当前位进行比较。
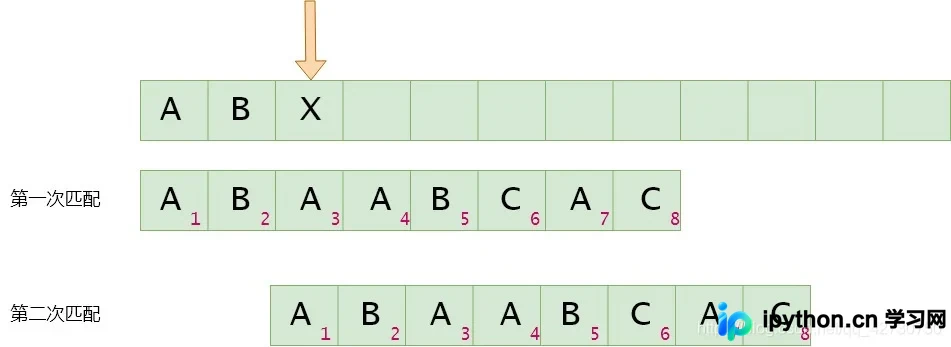
如果模式串的第3号位(索引2)与主串当前位不匹配,查找最长公共前后缀。指针前面的子串为“AB”,其最长公共前后缀为空集,长度为0,因此next[2]=0。下次匹配时,将模式串的第1号位与主串的当前位进行比较。
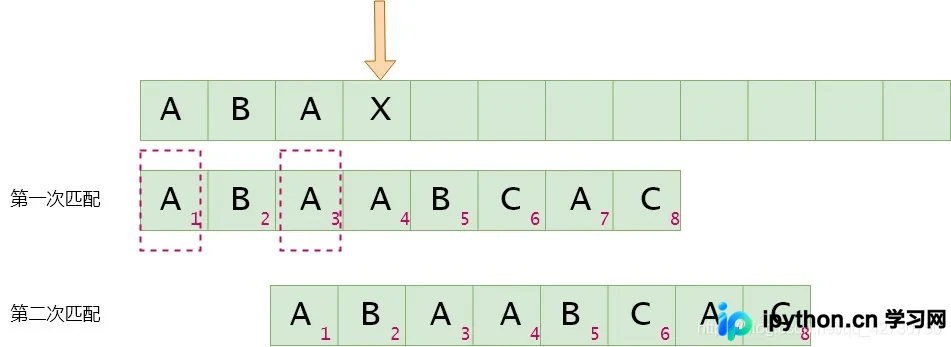
如果模式串的第4号位(索引3)与主串当前位不匹配,查找最长公共前后缀。指针前面的子串为“ABA”,其最长公共前后缀为“A”,长度为1,因此next[3]=1。下次匹配时,将前缀位置移到后缀位置,即模式串的第2号位与主串的当前位进行比较。
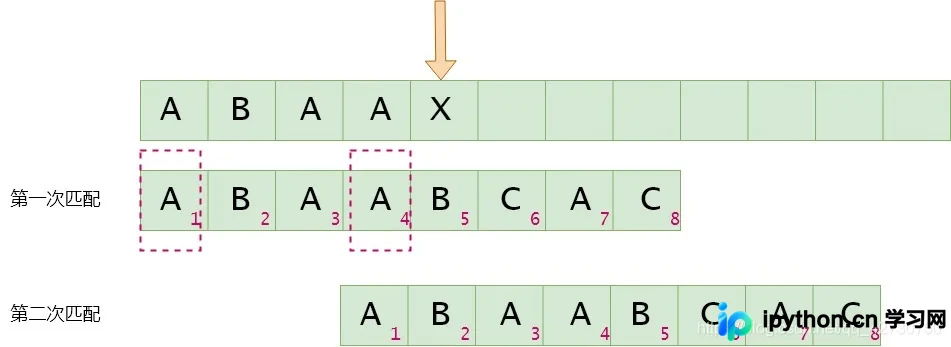
如果模式串的第5号位(索引4)与主串当前位不匹配,查找最长公共前后缀。指针前面的子串为“ABAA”,其最长公共前后缀为“A”,长度为1,因此next[4]=1。下次匹配时,将前缀位置移到后缀位置,即模式串的第2号位与主串的当前位进行比较。
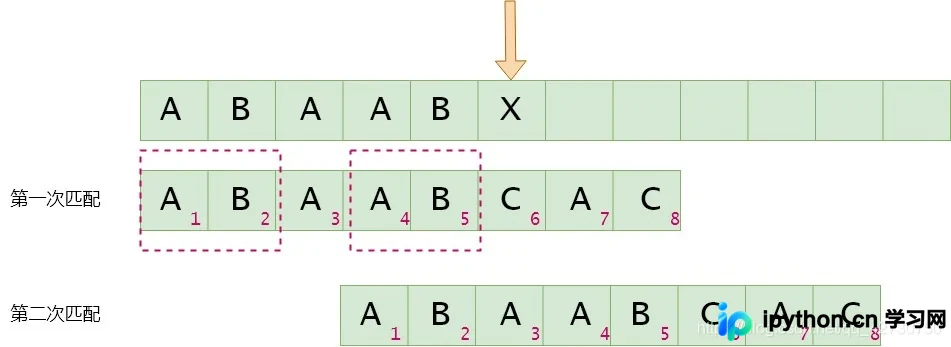
如果模式串的第6号位(索引5)与主串当前位不匹配,查找最长公共前后缀。指针前面的子串为“ABAAB”,其最长公共前后缀为“AB”,长度为2,因此next[5]=2。下次匹配时,将前缀位置移到后缀位置,即模式串的第3号位与主串的当前位进行比较。
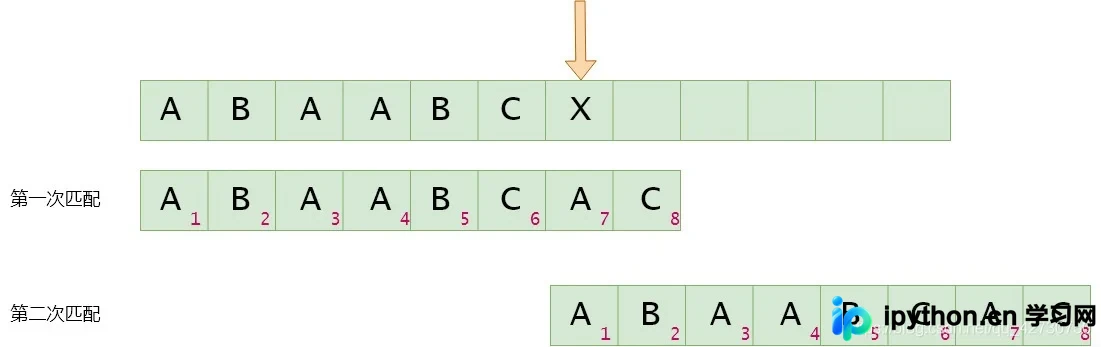
如果模式串的第7号位(索引6)与主串当前位不匹配,查找最长公共前后缀。指针前面的子串为“ABAABC”,其最长公共前后缀为空集,长度为0,因此next[6]=0。下次匹配时,将模式串的第1号位与主串的当前位进行比较。
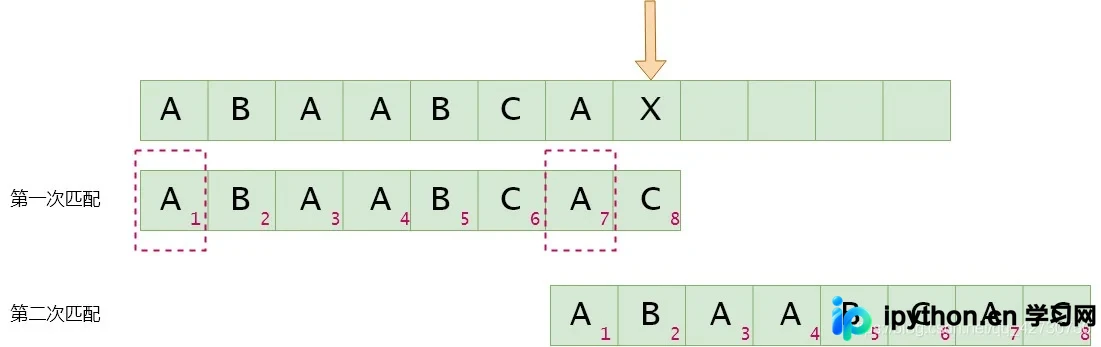
如果模式串的第8号位(索引7)与主串当前位不匹配,查找最长公共前后缀。指针前面的子串为“ABAABCA”,其最长公共前后缀为“A”,长度为1,因此next[7]=1。下次匹配时,将前缀位置移到后缀位置,即模式串的第2号位与主串的当前位进行比较。
综上所述,可以得到模式串的next数组。值得注意的是,该数组仅与模式串本身有关,与主串无关。也就是说,下次匹配时模式串向后移动的位数完全由模式串自身的结构决定。
| 位编号 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 索引 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
| 模式串 | A | B | A | A | B | C | A | C |
| next | -1 | 0 | 0 | 1 | 1 | 2 | 0 | 1 |
next数组的作用是存储每个字符匹配失败时,对应的下一次匹配时模式串开始匹配的位置索引。
如何在代码中实现上述next数组的计算流程?以下通过具体示例说明。假设蓝色方框圈出的部分为公共前后缀,且已知next[j]=t:
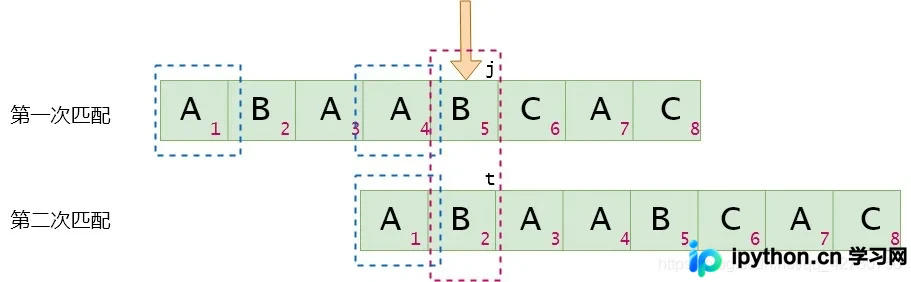
当T[j] == T[t]时,可以推导出next[j+1] = t + 1 = next[j] + 1。例如,当j=4, t=1(索引)时,满足此条件。
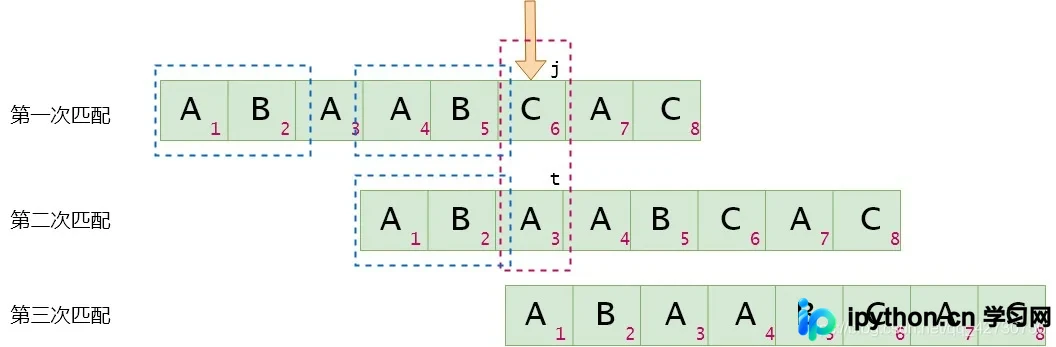
当T[j] != T[t]时,即模式串中索引为t的字符与当前比较位不匹配,则将模式串移动到next[t]位置进行比较,即更新t = next[t],直到T[j] == T[t]或t = -1。当t = -1时,next[j+1] = 0。例如,此处t = next[2] = 0,表示下次匹配时,模式串的第1位与主串当前位进行比较。
基础KMP算法的Python实现代码如下:
def getNext(substrT):
  next_list = [-1 for i in range(len(substrT))]
  j = 0
  t = -1
  while j < len(substrT) - 1:
    if t == -1 or substrT[j] == substrT[t]:
      j += 1
      t += 1
      # Tj=Tt, 则可以到的next[j+1]=t+1
      next_list[j] = t
    else:
      # Tj!=Tt, 模式串T索引为t的字符与当前位进行匹配
      t = next_list[t]
  return next_list


def KMP(substrS, substrT, next_list):
  count = 0
  j = 0
  t = 0
  while j < len(substrS) and t < len(substrT):
    if substrS[j] == substrT[t] or t == -1:
      # t == -1目的就是第一位匹配失败时
      # 主串位置加1, 匹配串回到第一个位置(索引为0)
      # 匹配成功, 主串和模式串指针都后移一位
      j += 1
      t += 1
    else:
      # 匹配失败, 模式串索引为t的字符与当前位进行比较
      count += 1
      t = next_list[t]
  if t == len(substrT):
    # 这里返回的是索引
    return j - t, count+1
  else:
    return -1, count+1
KMP算法优化:nextval数组实现
3. KMP算法优化版
前文定义的next数组在某些特定情况下仍存在缺陷。观察第一个示例图,我们发现还可以跳过第3次匹配,直接进行第4次匹配。为了更清晰地说明优化必要性,以下述情况为例优化KMP算法:假设主串S=AAABAAAAB,模式串T=AAAAB。按照原始KMP算法,匹配过程如下:
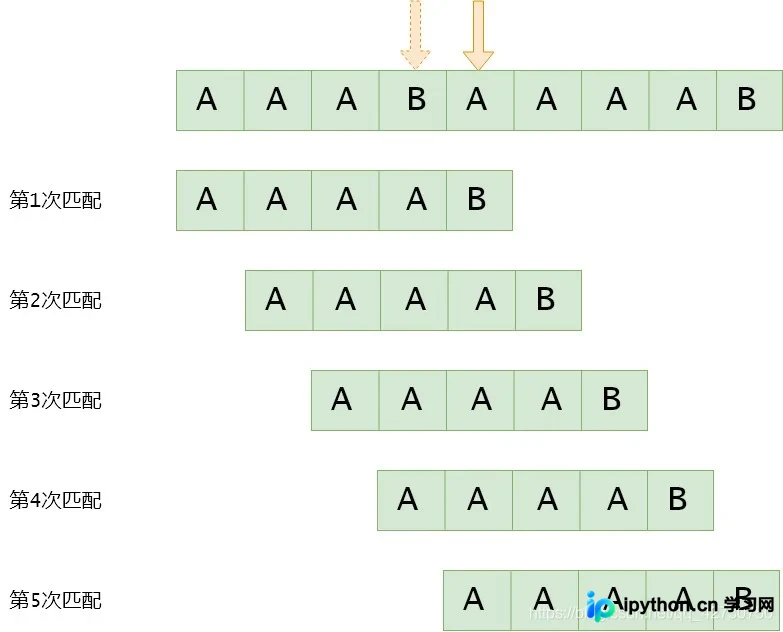
可以看到,第2、3、4次的匹配是多余的。因为在第一次匹配时,主串S的第4号位已经与模式串T的第4号位进行了比较,且T[3] != S[3]。由于模式串T的第4号位与其第1、2、3号位的字符相同(即T[3]=T[2]=T[1]=T[0]),且这些字符都不等于S[3],因此可以直接进入第5次匹配,跳过中间无效的重复比较。
那么,问题出在哪里?我们结合next数组进行分析:
| 位编号 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 索引 | 0 | 1 | 2 | 3 | 4 |
| 模式串 | A | A | A | A | B |
| next | -1 | 0 | 1 | 2 | 3 |
问题在于,当T[j] != S[j]时,下次匹配的必然是T[next[j]]与S[j]进行比较。如果此时T[next[j]] == T[j],那么这相当于再次将T[j]与S[j]进行比较。由于字符相同,这次匹配必然失败,因此是无效的。应当将next[j]的值直接修正为-1(或相应的优化值),使得主串与模式串都从下一位开始比较,避免无效回溯。
因此,我们需要对next数组进行修正。
修正流程与求解next数组类似,但增加了一个判别条件:如果在匹配过程中出现T[next[j]] == T[j]的情况,则将next[j]更新为next[next[j]],直至两者不相等为止(这相当于一种迭代优化)。在代码实现中,如果某个字符已经相等,或者next[j]数组值为-1(即t=-1),且主串和模式串指针各后移一位时的字符仍然相同,则将当前的next[j]值更新为上一个next[j]数组对应的优化值。更新后的数组命名为nextval数组。
优化版KMP算法的Python实现代码如下:
def getNextval(substrT):
  nextval_list = [-1 for i in range(len(substrT))]
  j = 0
  t = -1
  while j < len(substrT) - 1:
    if t == -1 or substrT[j] == substrT[t]:
      j += 1
      t += 1
      if substrT[j] != substrT[t]:
        # Tj=Tt, 但T(j+1)!=T(t+1), 这个就和next数组计算时是一样的
        # 可以得到nextval[j+1]=t+1
        nextval_list[j] = t
      else:
        # Tj=Tt, 且T(j+1)==T(t+1), 这个就是next数组需要更新的
        # nextval[j+1]=上一次的nextval_list[t]
        nextval_list[j] = nextval_list[t]
    else:
      # 匹配失败, 模式串索引为t的字符与当前位进行比较
      t = nextval_list[t]
  return nextval_list
对KMP的优化本质上是对next数组的优化。修正后的next数组,即nextval数组如下表所示:
| 位编号 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 索引 | 0 | 1 | 2 | 3 | 4 |
| 模式串 | A | A | A | A | B |
| nextval | -1 | -1 | -1 | -1 | 3 |
接下来进行实际测试验证优化效果。
if __name__ == '__main__':
  S1 = 'ABACABAB'
  T1 = 'ABAB'
  S2 = 'AAABAAAAB'
  T2 = 'AAAAB'

  print('*' * 50)
  print('主串S={0}与模式串T={1}进行匹配'.format(S1, T1))

  print('{:*^25}'.format('KMP'))
  next_list1 = getNext(T1)
  print('next数组为: {}'.format(next_list1))
  index1_1, count1_1 = KMP(S1, T1, next_list1)
  print('匹配到的位置(索引): {}, 匹配次数: {}'.format(index1_1, count1_1))

  print('{:*^25}'.format('KMP优化版'))
  nextval_list1 = getNextval(T1)
  print('nextval数组为: {}'.format(nextval_list1))
  index1_2, count1_2 = KMP(S1, T1, nextval_list1)
  print('匹配到的位置(索引): {}, 匹配次数: {}'.format(index1_2, count1_2))

  print('')
  print('*' * 50)
  print('主串S={0}与模式串T={1}进行匹配'.format(S2, T2))

  print('{:*^25}'.format('KMP'))
  next_list2 = getNext(T2)
  print('next数组为: {}'.format(next_list2))
  index2_1, count2_1 = KMP(S2, T2, next_list2)
  print('匹配到的位置(索引): {}, 匹配次数: {}'.format(index2_1, count2_1))

  print('{:*^25}'.format('KMP优化版'))
  nextval_list2 = getNextval(T2)
  print('nextval数组为: {}'.format(nextval_list2))
  index2_2, count2_2 = KMP(S2, T2, nextval_list2)
  print('匹配到的位置(索引): {}, 匹配次数: {}'.format(index2_2, count2_2))
运行结果如下:
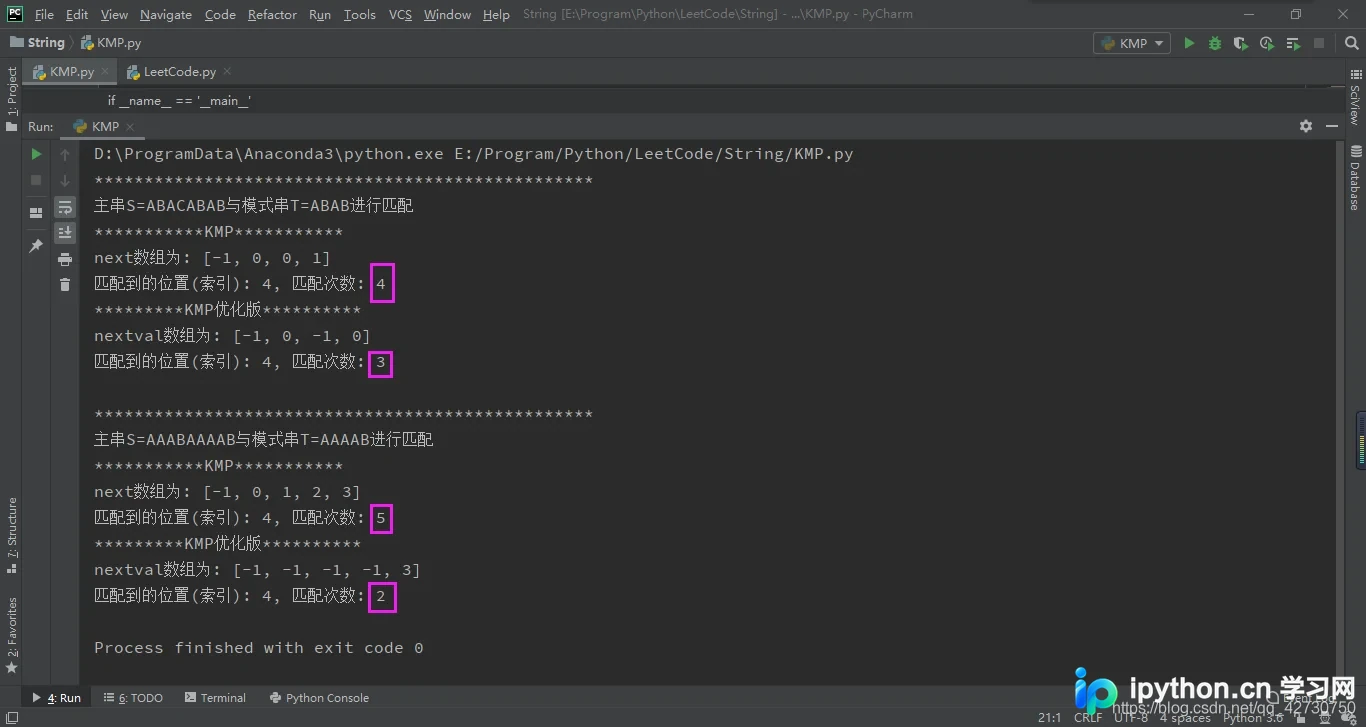
运行结果与分析一致。在未修正next数组时,主串S=ABACABAB与模式串T=ABAB匹配需要4次;主串S=AAABAAAAB与模式串T=AAAAB匹配需要5次。而在修正next数组(使用nextval)后,主串S=ABACABAB与模式串T=ABAB匹配仅需3次;主串S=AAABAAAAB与模式串T=AAAAB匹配仅需2次。优化显著减少了匹配次数。
结束语
在撰写本篇博客之前,我反复查阅了参考书籍和视频资料,通过边画图边理解的方式,并多次修改稿件,最终完成了对KMP算法的深入解析。有关字符串基础知识的复习至此基本结束,接下来的工作将是进行算法刷题实践(尽管已在LeetCode上做过几道相关题目)。
到此,这篇关于Python描述数据结构之KMP篇的文章介绍完毕。更多相关Python KMP内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









