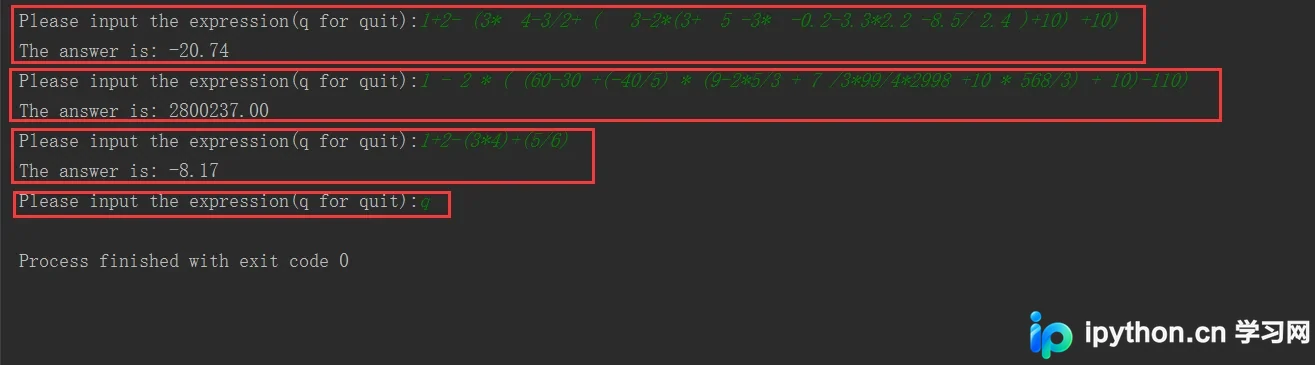
Python 正则表达式实现简易计算器
本文介绍如何使用 Python 正则表达式实现一个简易计算器。程序通过正则匹配加减乘除及括号,按优先级逐步计算表达式并输出结果。
2026-10-13
6

本文详细介绍Python中index()和seek()两个常用函数的用法。index()用于在序列中查找指定元素并返回首次出现的索引,支持通过beg和end参数指定搜索范围;seek()用于文件操作中移动读取指针,支持从文件头、当前位置或末尾进行偏移。文章通过具体代码示例演示了如何处理多次出现的情况及文件指针的移动技巧。
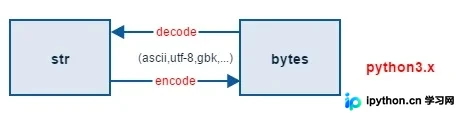
本文深入解析Python3如何解决Python2遗留的字符编码问题。通过对比Python2中ASCII默认编码及str/unicode混淆的缺陷,阐述Python3将默认编码设为UTF-8,并清晰区分str(文本)与bytes(二进制)类型。文章详细说明了bytes类型的定义、操作限制及与str的转换方法,包括encode和decode的具体应用,帮助开发者避免编码错误。
本文介绍使用Python正则表达式从网页中提取新闻标题及链接的具体实现方法。通过urllib获取页面内容,利用正则匹配特定HTML结构,并对提取结果进行字符串替换处理,最终将标题和链接保存至本地文件。
本文介绍使用Python正则表达式抓取网易新闻评论的方法。通过抓包工具定位隐藏评论接口,利用urllib2发起请求并获取HTML数据,再经正则处理提取JSON中的评论字段。代码包含分页处理、异常捕获及文件写入逻辑,适合Python初学者参考正则在爬虫中的应用。
本文详细介绍使用Python将罗马数字转换为阿拉伯数字的实现方法。文章解析了罗马数字的基本符号(I, V, X等)及其组合规则,重点讲解了利用正则表达式验证输入合法性及通过字典映射进行数值累加的算法逻辑。提供了完整的Python函数代码,可直接用于处理如MDCCCLXXXVIII等标准罗马数字字符串的转换任务。
本文介绍利用Python正则表达式从指定网页提取并保存图片的方法。通过定义匹配规则筛选图片链接,结合urllib库实现批量下载。文中附带Python代码示例及正则表达式在线测试工具链接,帮助开发者快速掌握网页图片抓取技巧。
本文详细解析Python中random模块的核心用法,涵盖种子设置、整数与浮点数随机生成、列表洗牌及字符串随机选取等场景。通过具体代码示例,展示random.seed、randint、uniform、shuffle等函数的实际效果与参数限制,帮助开发者掌握Python随机数生成的最佳实践。
本文介绍在Python中计算某年某月某日是当年第几天的两种方法。第一种通过手动判断闰年并累加月份天数实现;第二种利用内置datetime模块直接格式化输出。文章还涵盖了从字符串格式如"2016-10-1"解析日期的处理技巧,并提供了完整测试代码及结果验证。
本文介绍利用Python正则表达式按连续换行符分割大文件,并将每3个段落合并写入新小文件的完整流程。通过遍历切片列表并动态管理文件句柄,实现自动化分段存储,适用于语料处理等场景。
本文介绍了一种基于插入法的Python非递归全排列实现方案。通过遍历字符串或数组元素,利用字符串切片与合并特性,将新元素依次插入到现有排列的前、中、后各个位置,从而生成n+1个新排列。该方法代码简洁,适合Python初学者理解数组操作与递归逻辑的非递归替代方案。
本文系统梳理Python中7种高频字符串处理技巧,涵盖连接合并、切片相乘、简单与复杂分割、前后缀判断、查找匹配、普通与正则替换以及字符清理。通过具体代码示例,展示如何高效处理爬虫数据、文本清洗及文件解析等场景中的字符串操作问题。