SQL中临时表与子查询的实战技巧:分步计算与多条件聚合
本文通过两个实际业务场景,演示如何利用SQL子查询实现类似临时表的分步处理和多层级聚合。第一个案例利用DATEDIFF和AVG/MAX/MIN聚合函数,在不创建物理临时表的情况下直接计算订单平均、最大及最小交付周期;第二个案例结合IFNULL和ROUND函数,在单次查询中对同一表中不同状态(计划与实出)的数据进行分组统计并计算完成率。文章提供了完整的代码片段与参数解析,帮助开发者简化复杂逻辑,避免后端多次交互。
2026-10-16
8

本文通过两个实际业务场景,演示如何利用SQL子查询实现类似临时表的分步处理和多层级聚合。第一个案例利用DATEDIFF和AVG/MAX/MIN聚合函数,在不创建物理临时表的情况下直接计算订单平均、最大及最小交付周期;第二个案例结合IFNULL和ROUND函数,在单次查询中对同一表中不同状态(计划与实出)的数据进行分组统计并计算完成率。文章提供了完整的代码片段与参数解析,帮助开发者简化复杂逻辑,避免后端多次交互。

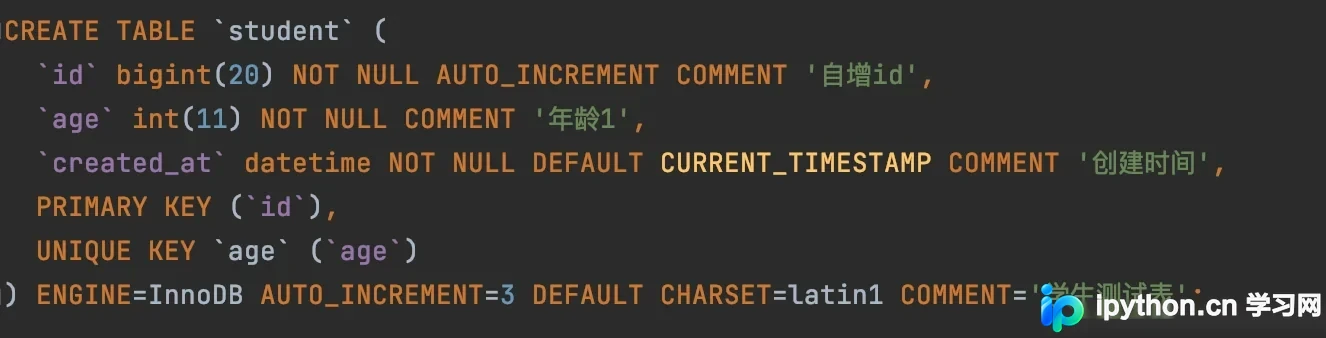
本文详解在MySQL中处理批量插入重复数据的三种核心策略:INSERT IGNORE、REPLACE INTO 以及 INSERT ... ON DUPLICATE KEY UPDATE。通过对比它们对主键和唯一键的响应机制,剖析执行逻辑差异及潜在风险(如自增ID不连续、数据丢失),并针对主从复制场景给出避坑建议,帮助开发者选择最适合的业务场景。
本文详解 MySQL 中正则表达式的用法,涵盖 REGEXP、RLIKE 和 NOT REGEXP 三大核心操作符。深入解析 ^、$、.、*、+、[] 等常用特殊字符的匹配规则,结合 BINARY 处理大小写敏感问题及转义字符注意事项,帮助开发者高效实现复杂文本匹配。
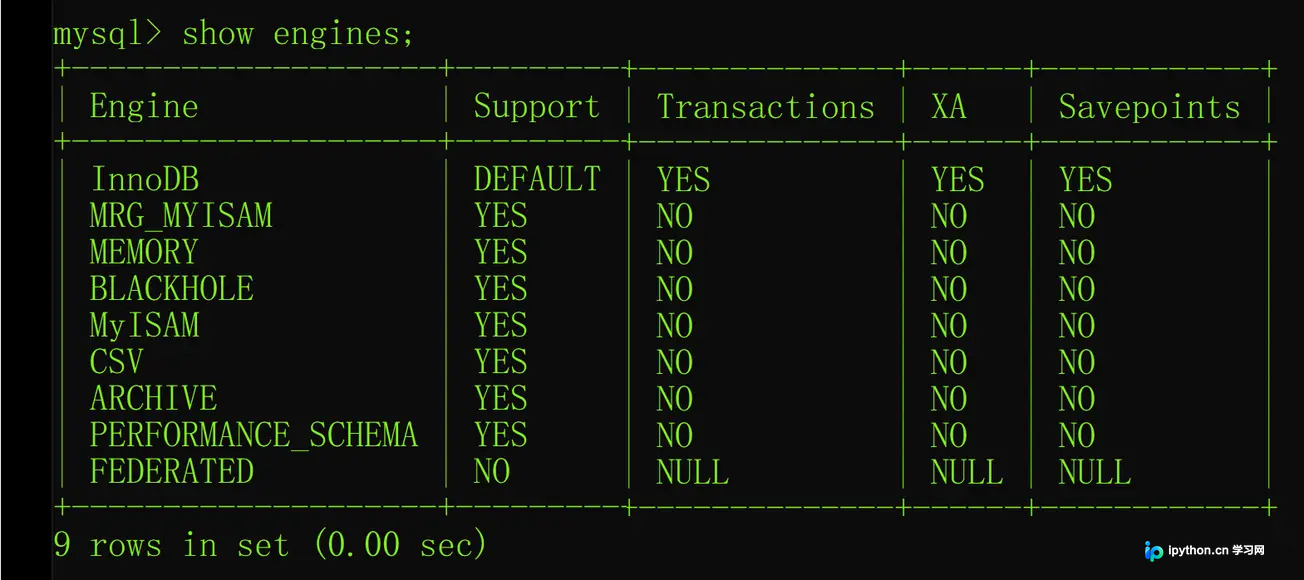
本文对比 MySQL 三大常用存储引擎:InnoDB、MyISAM 和 MEMORY。从事务支持、锁机制、读写效率及适用场景进行详细分析,并提供使用 SQL 命令查看及修改表级存储引擎的具体操作指南。
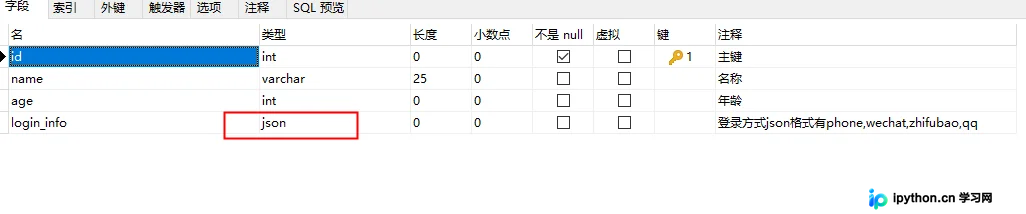
MySQL 5.7 原生支持 JSON 数据类型,适合存储结构灵活的用户画像或配置信息。本文详解如何通过 JSON_EXTRACT 提取数据、利用生成列优化查询性能,以及在 MySQL 8.0 中使用多值索引加速 JSON 数组检索,解决传统关系型字段扩展困难的问题。
在 SQL Server 中,可以利用内置的 CHARINDEX 函数快速判断一个字符串是否包含特定的单字符或子串。本文介绍了两种实用场景:基于分隔符(如逗号)拆分比对和逐字匹配。通过创建自定义标量函数,可以将这些逻辑封装,以便在复杂的表查询中直接调用,提高数据处理效率。
本文详述在 Ubuntu 系统下安装 MySQL 8.0.28 的步骤,重点讲解如何利用 debian.cnf 默认凭据重置 root 密码,并修改配置文件以启用 bind-address=0.0.0.0 从而实现远程连接。操作包含防火墙关闭及 Navicat 连通性测试,适用于需要快速搭建可外部访问的 MySQL 环境场景。
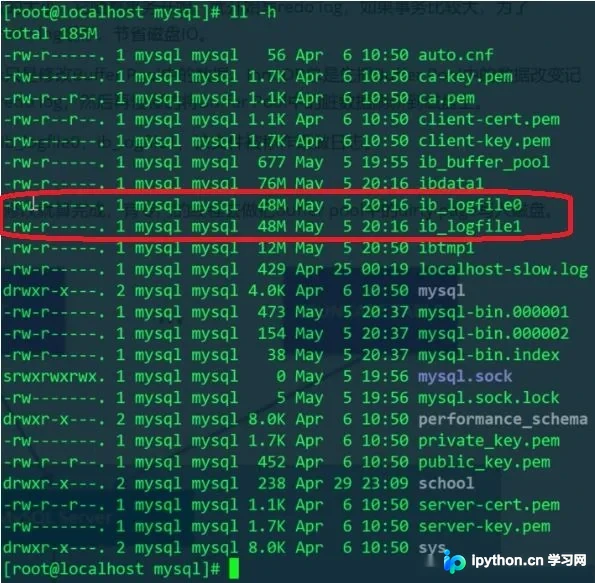
本文解析MySQL InnoDB引擎中redo log的核心作用。作为物理日志,redo log记录数据页的最终修改状态,确保事务的持久性(D)。通过先写日志(WAL)机制,事务提交时先将redo log刷盘,即使发生断电等异常,MySQL重启后也能利用redo log恢复数据,而无需等待脏页写入磁盘。
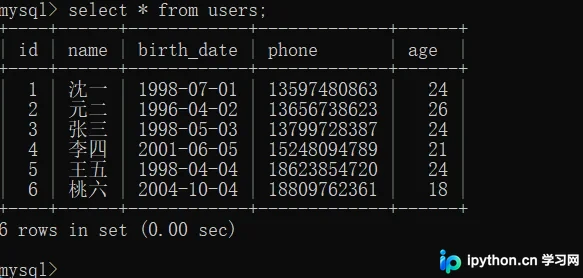
本文详解 MySQL 中如何使用 WHERE 子句进行精准数据筛选。涵盖等于、大于等比较运算符,AND/OR 逻辑组合,IN/BETWEEN 范围匹配,以及区分 NULL 与空字符串的正确写法。结合 LIKE 通配符实现模糊搜索,并说明运算优先级规则,助您高效掌握 SQL 数据提取技巧。
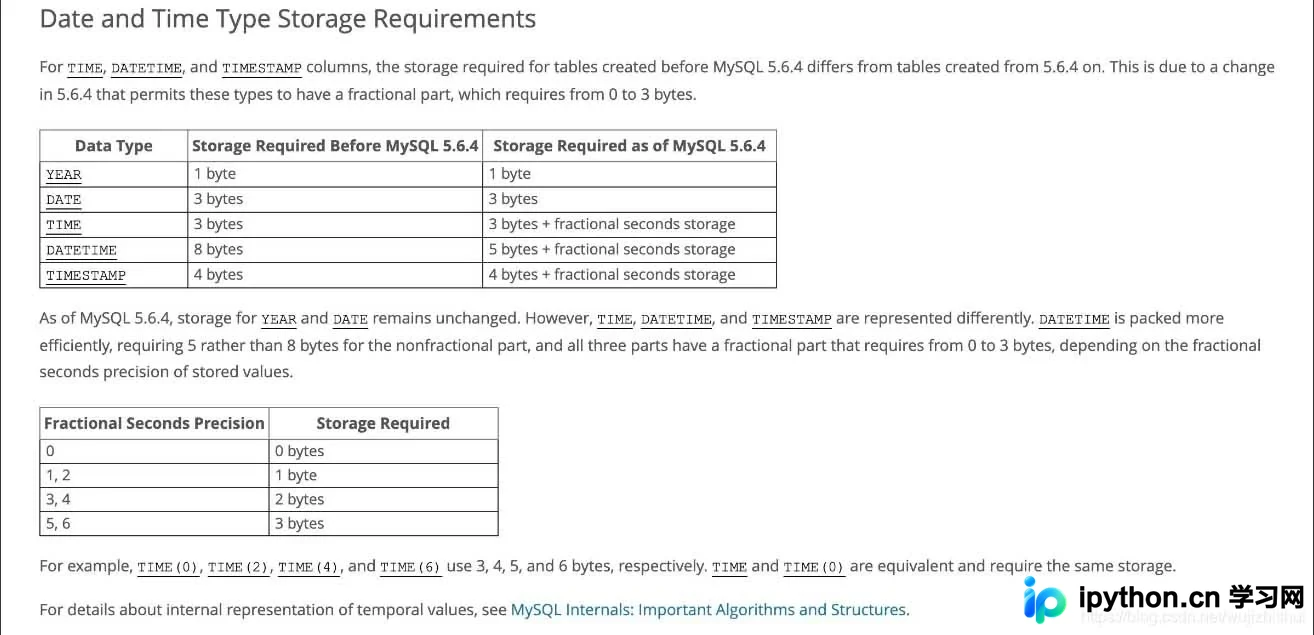
在MySQL中存储时间,严禁使用字符串。DateTime与时区无关且占用8字节;Timestamp自动转换时区且仅占4字节,适合多时区场景。整数时间戳便于跨系统传输但可读性差。本文详细对比三者的性能、空间及使用时机,助你选择最合适的存储方案。
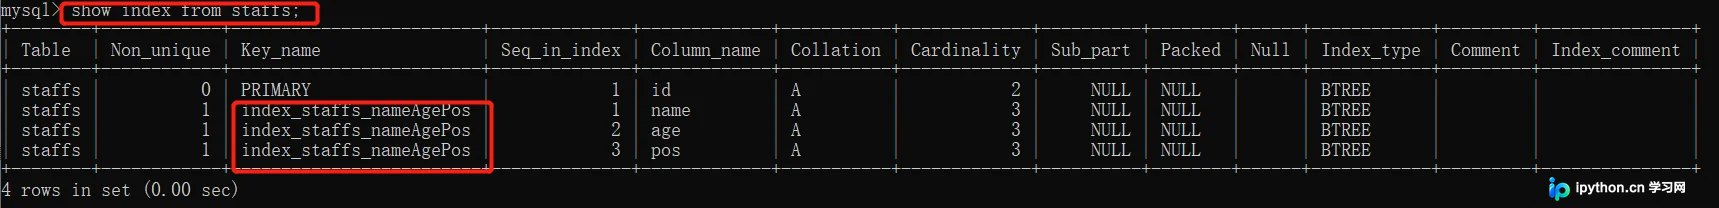
MySQL联合索引基于B+树结构构建,遵循最左前缀匹配原则。本文解析为何查询必须从索引最左侧字段开始,并深入探讨范围查询对后续索引失效的影响、乱序查询的优化器处理机制,以及通过调整列顺序来消除文件排序(Filesort)的具体实战技巧。
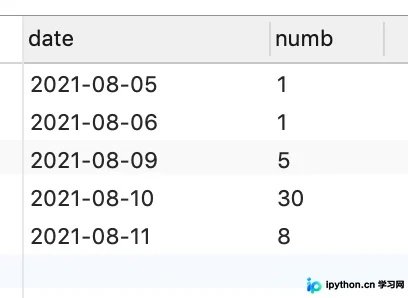
针对统计业务中数据库时间不连续导致数据缺失的问题,本文提供在MySQL中生成最近7天连续日期的方案,并演示如何通过LEFT JOIN合并结果以补全零值。同时解析会话级用户变量(@)的用法,通过预查询将部门区域编号与等级提取为变量,从而简化复杂的嵌套子查询结构,提升SQL的可读性与执行效率。