

MySQL生成连续日期与变量赋值的实操方法

解决统计报表因缺失日期而不连贯的问题,可通过MySQL内置函数结合变量生成连续时间序列;同时利用`@`符号定义的会话级变量提取固定过滤条件,可大幅精简复杂SQL语句。
结果:补齐时间序列并简化合并逻辑
在进行按日报表统计时,如果数据库中某几天没有记录,直接按日期分组查询会导致这些日期的数据缺失,无法直观反映趋势。为解决此问题,需要先生成一个包含所有目标日期的虚拟表,再通过连接查询与原业务数据关联,将未产生数据的日期填充为0或NULL。
准备条件:理解会话级变量的作用
在处理复杂的多条件统计时,部分过滤条件(如特定的部门区域代码或等级)可能在主查询中被多次使用或重复计算。MySQL支持使用`@`前缀定义用户变量,这类变量属于会话级范围,在当前连接关闭后失效。预先赋值变量可以避免在主查询中反复调用子查询,使语句结构更清晰、易于维护。
第1步:生成指定数量的连续日期
目的:创建一个仅包含目标时间段(如最近7天)的临时时间表作为主查询基准。
操作:利用MySQL的行生成技巧(UNION联合查询)结合自增变量生成数字序列,再用日期函数将其转化为具体的日期字符串。
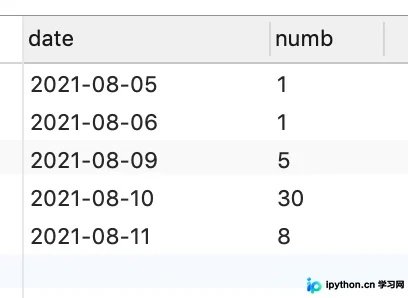
以下是生成最近7天连续日期的具体代码。其核心在于利用`(SELECT @num:=0) y`初始化计数器,并通过交叉连接或多层递归增加生成的数量。若需更多日期,可适当增加UNION的次数。
// 方法笨,但还是有效的
select DATE_FORMAT(SUBDATE(NOW(), interval (timeList.sj*1460) MINUTE),'%Y-%m-%d') as 'datetime' from
(SELECT @num:=@num+1 as sj from
            (SELECT 1 UNION SELECT 2 UNION SELECT 3 UNION SELECT 4 UNION SELECT 5 UNION SELECT 6 UNION SELECT 7) t,
           (SELECT @num:=0) y) as timeList
第2步:执行原始统计数据查询
目的:获取实际存在的业务数据及其对应的日期。
操作:从业务表中筛选符合条件的数据,按日期格式化和分组计数。
SELECT
       DATE_FORMAT( create_time, '%Y-%m-%d' ) AS date,
       COUNT(1) AS numb
FROM
   qc_task
   WHERE
   create_time>= DATE_SUB(CURDATE(),INTERVAL 1 MONTH) AND
   department_id IN ( SELECT id FROM `vigilante_jinan`.`qc_department` WHERE `area_code` = (@dep_BH) AND `status` = '1' AND dept_level >= (@dep_DJ))
   GROUP BY DATE_FORMAT( create_time, '%Y-%m-%d' )
第3步:合并数据并处理缺失项
目的:将生成的“空壳”日期表与实际数据表进行连接,确保输出结果包含每一天的数据,无数据的自动补零。
操作:以生成的时间表`f`为主表,对原数据统计结果`t`执行RIGHT JOIN(以右表即时间表为主)。如果左表`t`中没有匹配的日期,则对应列为NULL。
-- 生成后左右链接即可,但主表要为时间表
SELECT f.datetime, IFNULL(t.numb, 0) AS total_count FROM
(SELECT
       DATE_FORMAT( create_time, '%Y-%m-%d' ) AS date,
       COUNT(1) AS numb
FROM
   qc_task
   WHERE
   create_time>= DATE_SUB(CURDATE(),INTERVAL 1 MONTH) AND
   department_id IN ( SELECT id FROM `vigilante_jinan`.`qc_department` WHERE `area_code` = (@dep_BH) AND `status` = '1' AND dept_level >= (@dep_DJ))
   GROUP BY DATE_FORMAT( create_time, '%Y-%m-%d' )) t
right join
(select DATE_FORMAT(SUBDATE(NOW(), interval (timeList.sj*1460) MINUTE),'%Y-%m-%d') as 'datetime' from
(SELECT @num:=@num+1 as sj from
            (SELECT 1 UNION SELECT 2 UNION SELECT 3 UNION SELECT 4 UNION SELECT 5 UNION SELECT 6 UNION SELECT 7) t,
           (SELECT @num:=0) y) as timeList) f ON t.date = f.datetime;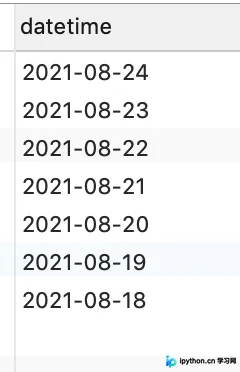
此时输出的列表将包含连续的日期,即使某天没有任务,也会显示0(配合IFNULL函数),从而保持图表数据的完整性。
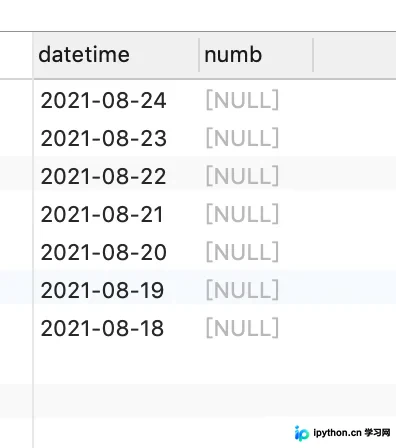
注:实际效果可能因数据库内容而异,上图仅为展示数据合并后的基本结构。
进阶:变量赋值的实际应用
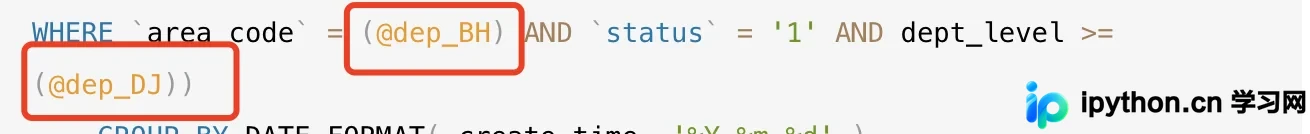
在上述查询中,可以看到大量使用了`@dep_BH`和`@dep_DJ`等变量。如果不使用变量,每次都需要重新执行子查询去匹配部门名称。通过提前赋值,可以将查询拆分为易读的步骤。
第4步:声明并获取变量
目的:根据业务规则提取固定的过滤参数并存入变量中,供后续大段SQL复用。
操作:分别查询部门区域编号和等级,并使用`:=`赋值符将结果存入对应的用户变量。
#  查询部门区域编号
SELECT @dep_BH:=(SELECT area_code FROM qc_department WHERE dept_name = "历下区");
#  查询部门等级
SELECT @dep_DJ:=(SELECT dept_level FROM qc_department WHERE dept_name = "历下区");
完成上述步骤后,在后续的复杂查询中直接使用`(@dep_BH)`和`(@dep_DJ)`即可。这种方法特别适用于需要频繁切换过滤条件或在多脚本间传递参数的场景,能有效降低主SQL的臃肿程度。
以上就是MySQL生成连续日期及变量赋值的详细内容,更多关于MySQL连续日期与变量赋值的资料请关注本站其它相关文章!免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









