

MySQL 实现 SQL 查询交集的多种方法
MySQL 原生不支持 INTERSECT 关键字,本文介绍如何通过子查询交叉连接、UNION ALL 配合 HAVING COUNT()=N 以及 INNER JOIN 等方式实现多表或多条件结果的交集查询,并简述使用 NOT IN 实现差集的方法。
2026-10-15
6

MySQL 原生不支持 INTERSECT 关键字,本文介绍如何通过子查询交叉连接、UNION ALL 配合 HAVING COUNT()=N 以及 INNER JOIN 等方式实现多表或多条件结果的交集查询,并简述使用 NOT IN 实现差集的方法。
SQL Server 2008 登录时出现“无法连接到 (local)”或错误号 2,通常因服务器名称格式变更导致。需打开服务确认状态,将服务器名改为“计算机名\实例名”,并选用 SQL Server 身份验证即可顺利连接。
本文介绍如何在PHP中开启mysqli扩展并实现数据库连接。首先指导通过修改php.ini启用扩展,随后分别演示面向过程和面向对象两种连接方式。重点展示面向对象方法的创建对象、错误检查及数据查询步骤,确保代码准确且具备可执行性。
MySQL Event是时间触发的计划任务,类似Linux Crontab。使用前需确认拥有Event权限并开启全局event_scheduler变量。通过CREATE EVENT语句可定义单次或重复执行逻辑,建议配置ON COMPLETION PRESERVE以保留元数据,并将操作封装在BEGIN...END块中。本文结合查看状态、创建及常见场景示例,解析其核心语法与应用。
MySQL中较大的Offset值会导致全表扫描并丢弃大量数据,严重影响查询性能。本文介绍一种基于“覆盖索引”结合“延迟关联”的优化策略。通过在子查询中仅返回主键ID并使用覆盖索引快速定位,再与原表进行Inner Join获取完整数据,从而避免回表操作带来的巨大开销,显著提升深分页查询效率。
MySQL 查询缓存通过可变大小的内存池块来存储结果,启动时初始化大块并随查询动态拆分。受限于 query_cache_min_res_unit 参数,数据以流式方式写入以避免浪费。需注意引用自定义函数、实时系统函数或临时表时缓存将失效;InnoDB 引擎中未提交的事务会导致相关缓存条目立即失效,确保读取一致性和性能平衡。
本文详解如何在Python中利用Pandas库高效读写MySQL数据库。通过结合pymysql和SQLAlchemy,实现从数据库读取数据生成DataFrame,以及将DataFrame写入数据库表的操作。包含完整的连接配置、查询及写入代码示例,适用于大数据处理场景。
在 SQL 查询中使用 ORDER BY 时,若仅依赖主键或单一字段排序,可能导致性能低下。本文通过一个包含视图和联合表的实际案例,展示如何在 ORDER BY 子句中增加业务关联字段(如 SendCentreID),从而利用索引加速排序过程,显著提升 large table 查询速度。
本文介绍在MySQL中如何将表的主键自增计数(AUTO_INCREMENT)重置为1。主要提供两种方法:使用 TRUNCATE TABLE 快速清空并重置,或使用 DELETE 结合 ALTER TABLE 语句手动调整自增值。同时分析了两者在数据保留、执行速度和大数据量下的性能差异,帮助开发者根据实际需求选择合适方案。
本文详细解析MySQL中FOUND_ROWS()与ROW_COUNT()函数的区别。前者用于SELECT查询匹配的行数,后者针对UPDATE/DELETE操作。关键误区在于:若UPDATE前后值未变,ROW_COUNT返回0,这与Oracle行为不同。通过代码示例说明其实际计数逻辑及注意事项。
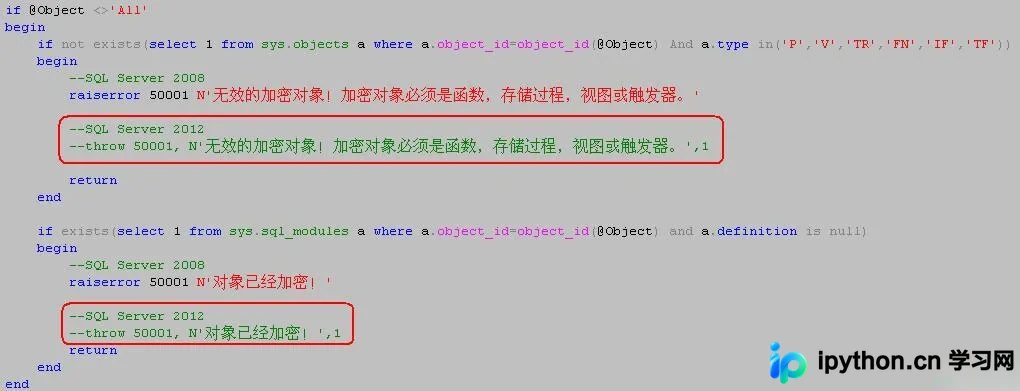
本文深入解析SQL Server存储过程加密(WITH ENCRYPTION)与解密机制,提供完整的自动加密和解密存储过程源码。详细演示如何通过查询sys.sysobjvalues表结合异或运算还原代码,并说明使用DAC(专用管理员连接)执行解密的必要步骤及测试环境搭建方法。
在使用 Sphinx 配合 MySQL 进行子域名(如 jb51.net)全文索引时,默认的以点号作为分隔符会导致搜索结果包含不相关域名。本文总结了通过将点号加入 charset_table、在数据中追加唯一后缀以及使用反引号包裹域名的方法,来实现精确且高效的子域名搜索。