

Python基于DFA算法实现内容敏感词过滤
本文详细介绍如何利用Python实现基于DFA(确定有限状态自动机)算法的敏感词过滤系统。通过构建树状查找结构,算法能高效识别文本中的违规词汇。文章包含基础匹配逻辑、通配符支持以及特殊符号绕过处理的完整代码示例,帮助开发者快速部署内容审核功能。
2026-10-15
22

本文详细介绍如何利用Python实现基于DFA(确定有限状态自动机)算法的敏感词过滤系统。通过构建树状查找结构,算法能高效识别文本中的违规词汇。文章包含基础匹配逻辑、通配符支持以及特殊符号绕过处理的完整代码示例,帮助开发者快速部署内容审核功能。
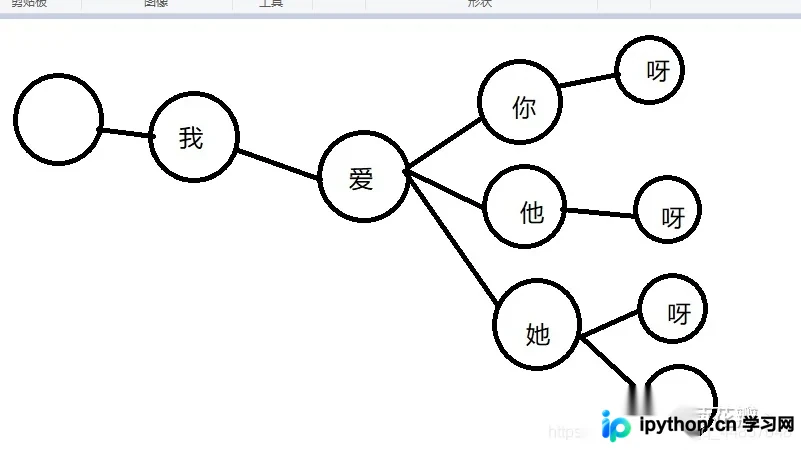
本文深入解析Python中敏感词过滤的三种实现方式。首先介绍基于集合替换的朴素过滤器,随后探讨利用反向排序映射优化替换次数的BSFilter算法,最后重点讲解利用确定有穷自动机(DFA)实现高效恒定性能过滤的DFAFilter。通过代码对比,展示不同算法在英语单词索引与逐字符匹配上的差异及性能表现。
本文详解Java中基于DFA(确定有穷自动机)算法的敏感词过滤实现。从背景分析入手,对比indexOf、SQL及Lucene方案,阐述选择DFA的理由。通过构建敏感词库树结构,展示搜索流程,并提供核心代码实现。最后针对符号干扰和拼音替换等常见绕过手段提出优化思路,旨在提升过滤系统的准确性与扩展性。
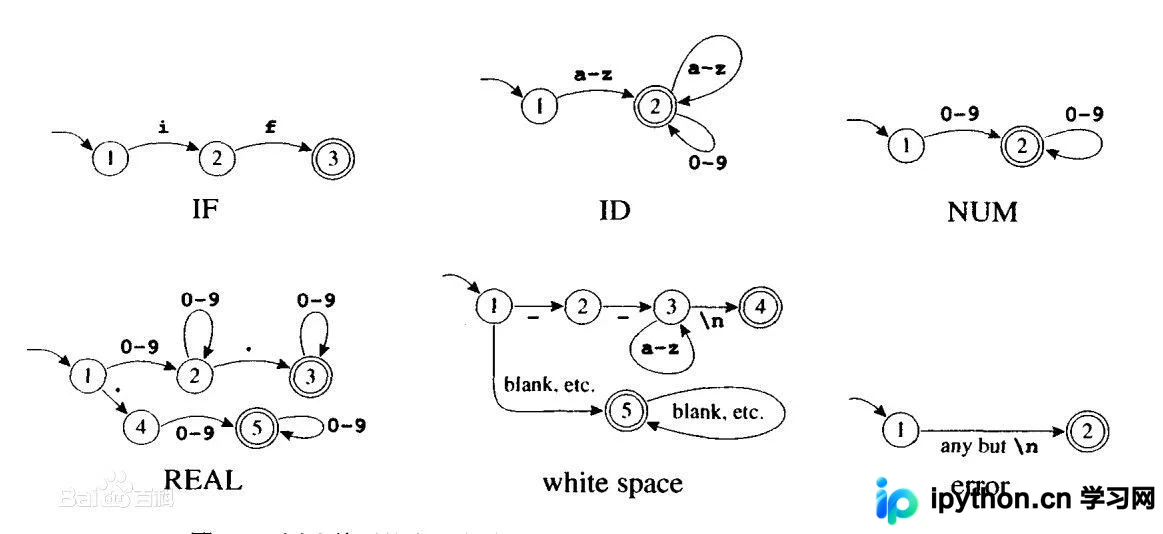
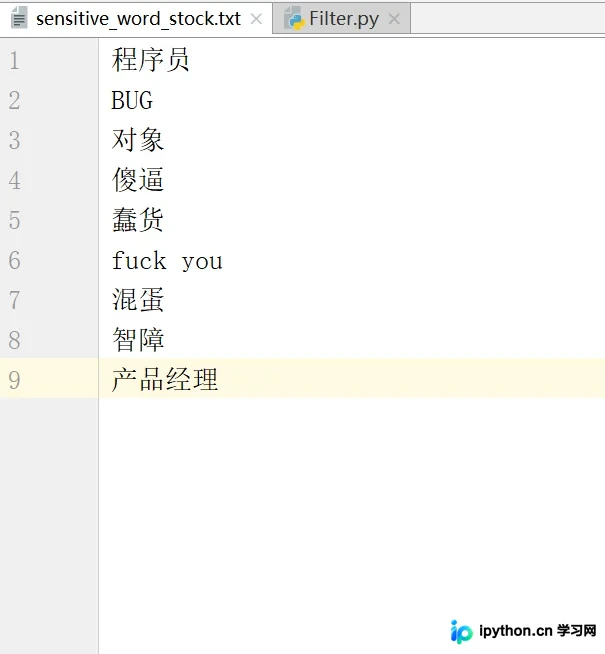
本文介绍如何使用Python类封装敏感词过滤功能,重点解决替换后新生成敏感词的嵌套问题。通过递归调用替换方法,持续处理字符串直到结果不再变化。文章包含敏感词库构建、核心代码实现及运行流程,适合需要文本内容安全过滤的开发者参考。
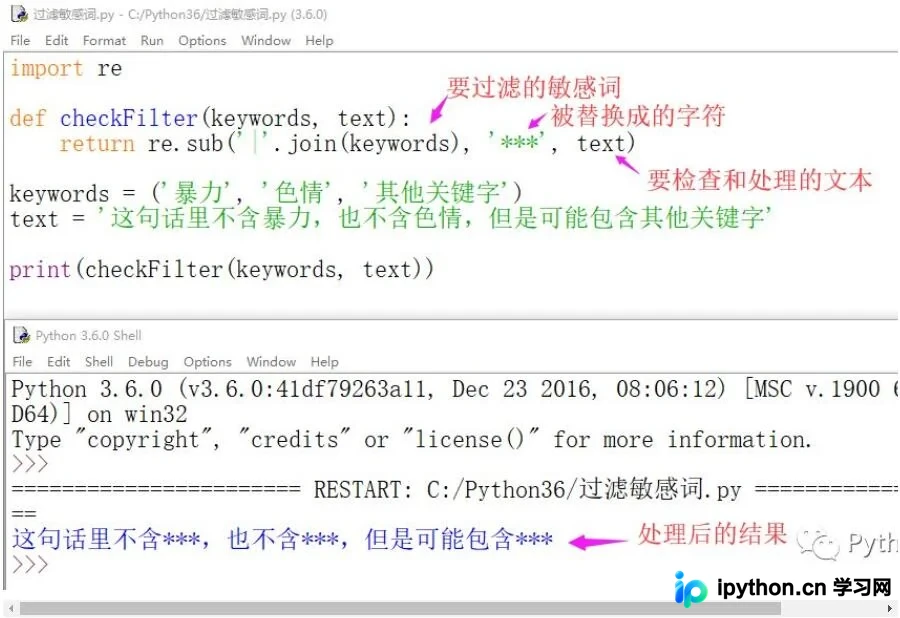
本文介绍如何利用Python的re模块sub()函数结合正则表达式中的竖线“|”语法,实现对用户发帖内容中敏感词的自动检测与字符替换。通过具体代码示例,展示如何高效构建过滤规则,适用于网站内容安全审核场景。
本文通过Python代码实测对比了DFA(确定有限状态自动机)算法与普通循环查找算法在敏感词过滤场景下的性能差异。实验结果显示,当敏感词数量较少(如100个)时,普通算法效率更高;而当敏感词库扩大至1000个时,DFA算法的优势显现。文章进一步从理论上推导了两种算法的时间复杂度,指出DFA算法的处理时间与敏感词数量基本无关,主要取决于文本长度和词长,从而明确了DFA算法在大规模敏感词库中的适用场景。
本文介绍如何使用Python实现类似王者荣耀的敏感词过滤功能。通过定义敏感词元组,接收用户输入并进行替换处理,最终输出过滤后的消息。该示例帮助初学者理解字符串操作与条件判断在实际场景中的应用。