

Java实现敏感词过滤:DFA算法原理与代码详解

本文详解Java中基于DFA(确定有穷自动机)算法的敏感词过滤实现。从背景分析入手,对比indexOf、SQL及Lucene方案,阐述选择DFA的理由。通过构建敏感词库树结构,展示搜索流程,并提供核心代码实现。最后针对符号干扰和拼音替换等常见绕过手段提出优化思路,旨在提升过滤系统的准确性与扩展性。
1.背景
在项目开发中,我们需要对敏感词汇进行过滤处理。针对这一需求,目前主要有以下几种可行的技术路线供选择:
- 方案一:将敏感词列表拼接为字符串,直接调用indexOf方法进行匹配查询。
- 方案二:将敏感词存入数据库,通过执行SQL查询语句来筛选。
- 方案三:利用Lucene搜索引擎构建分词索引,通过索引机制进行查询。
- 方案四:采用DFA(确定有穷自动机)算法进行匹配处理。
首先,项目中积累的敏感词数量已达数千条,若采用方案一(indexOf),其性能瓶颈明显,显然不可行。其次,为了降低对数据库的依赖并便于后续扩展,方案二(SQL查询)被排除。再次,虽然Lucene可作为本地索引使用,但敏感词增加时需触发索引更新,且本着系统轻量化的原则,不愿引入额外的重型库,因此方案三也被放弃。最终,我们确定以方案四(DFA算法)作为研究目标。
2.DFA算法简介
DFA的全称是Deterministic Finite Automaton,即确定有穷自动机。其核心特征包括:拥有一个有限状态集合,以及连接这些状态的边,每条边上标注有一个特定的符号。其中,存在一个初始状态,以及若干个终止状态。与不确定有限自动机(NFA)不同,DFA的关键限制在于:从同一状态出发,不可能有两条边标注相同的符号。
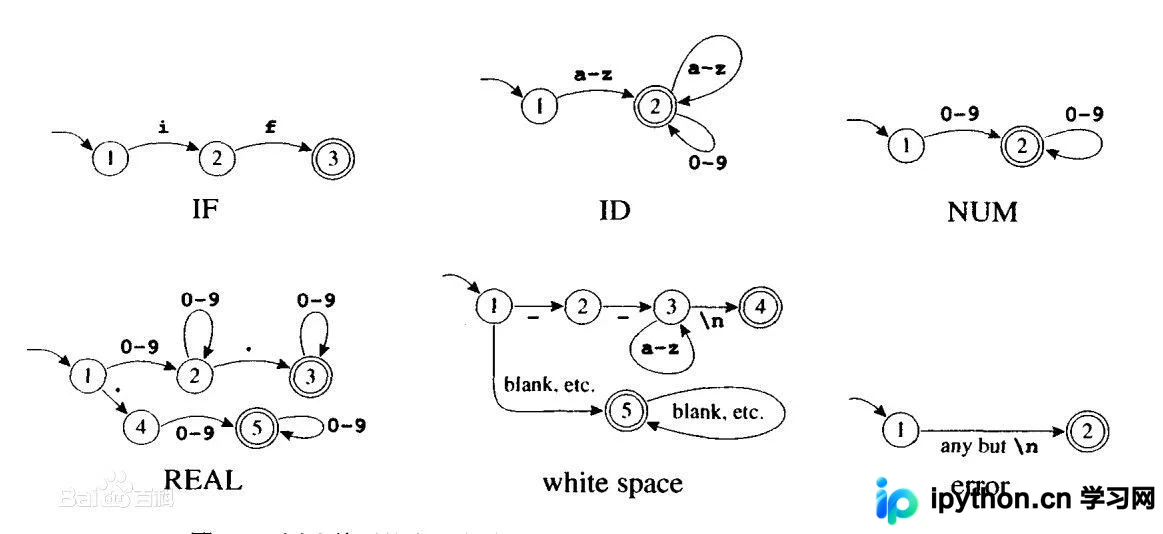
通俗理解,DFA是通过当前的“事件”(event)和“状态”(state)来确定“下一个状态”(next state),即遵循 event + state = next state 的逻辑。可以将其想象为系统中存在多个有限节点,通过传入的事件来确定路由走向,从而跳转到下一个节点。
3.敏感词搜寻中的DFA算法
3.1敏感词库构造描述
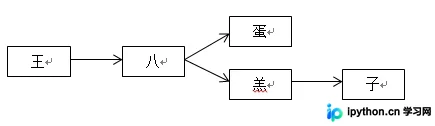
以“王八蛋”和“王八羔子”这两个敏感词为例,首先构建名为SensitiveMap的敏感词库。这两个词对应的二叉树结构如下所示:
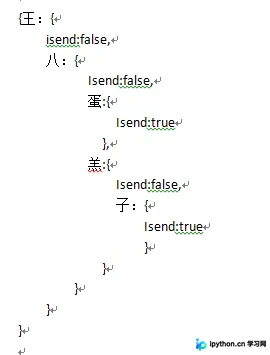
若使用哈希表(Hash Table)来构造该结构,示意如下:
3.2基于敏感词库搜索算法的描述
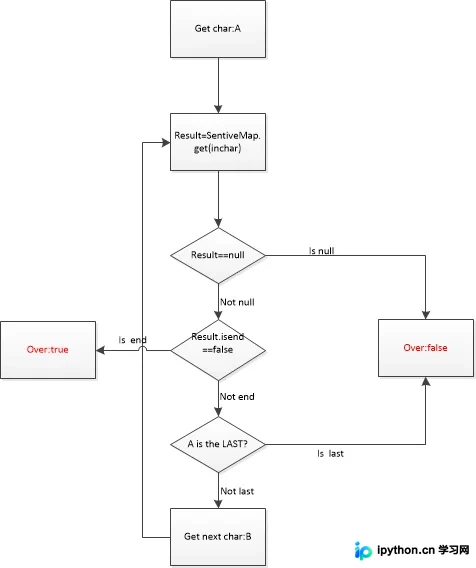
以上述构造的SensitiveMap作为敏感词库,假设输入的关键字为“王八不好”,其搜索流程图如下:
4.代码编写
4.1构造敏感词实现代码
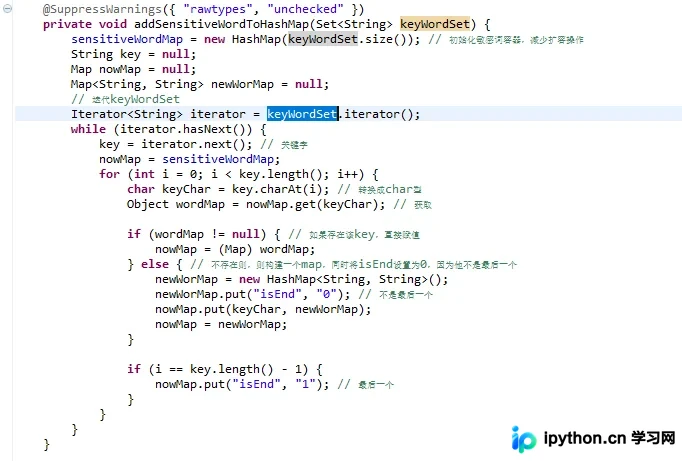
4.2实现敏感词查询代码
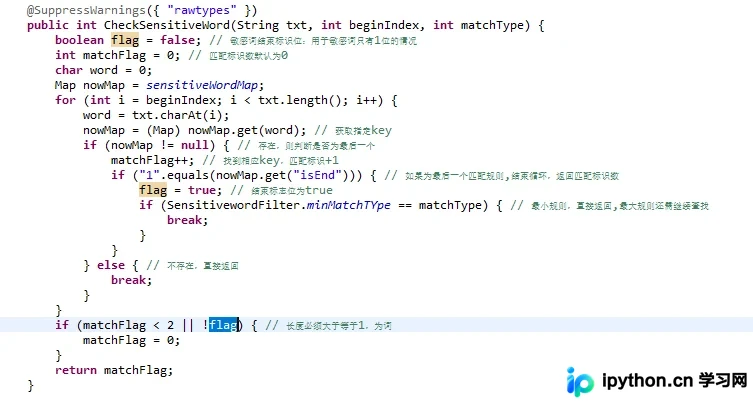
5.优化思路
5.1敏感词中间填充无意义字符问题
针对如“王*八&&蛋”这类在敏感词中间插入无意义字符以混淆视听的情况,我们在执行敏感词搜索时,应当增加对无意义字符的过滤机制。当循环遍历到这类字符时,直接跳过,从而避免其对匹配过程造成干扰。
5.2敏感词用拼音或部分用拼音代替
解决此类问题主要有两种思路:第一种是最直接的方法,即扩充敏感词库,将常见的变体加入其中,以快速解决问题;第二种方法是在判断过程中,将敏感词转换为拼音后再进行对比匹配。
然而,目前这两种方案均无法彻底完美地解决该问题,此类绕过手段仍需进一步深入研究。
至此,关于Java DFA算法案例的详细介绍已完成。如需了解更多Java DFA相关内容,欢迎查阅本站过往文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









