

Python递归遍历目录提取文件中文字符代码示例
本文提供一段Python代码,演示如何递归遍历指定目录下的所有文件,利用正则表达式提取其中的中文字符并保存至结果文件。代码包含字符编码处理、文件读取及递归逻辑,供开发者参考使用。
2026-10-13
6

本文提供一段Python代码,演示如何递归遍历指定目录下的所有文件,利用正则表达式提取其中的中文字符并保存至结果文件。代码包含字符编码处理、文件读取及递归逻辑,供开发者参考使用。
本文介绍如何利用Python的re模块,通过一行正则表达式代码高效过滤文本中的中英文标点符号及特殊字符。详细解析了\W匹配规则及自定义字符集的方法,提供完整代码示例与测试结果,帮助开发者快速实现文本清洗功能。
本文详解使用Python提取Bilibili视频弹幕的完整流程。核心在于通过手机User-Agent请求视频页面,利用正则表达式从响应JavaScript中提取弹幕接口所需的cid参数,拼接生成以.xml结尾的弹幕URL。随后发起二次请求获取XML数据,借助lxml库解析并提取文本内容,最终保存至本地文件。

本文系统梳理Python中正则表达式模块re的核心用法。详细解析了re.I、re.S等修饰符及^、$、.等基础模式,深入讲解re.compile、re.match、re.search、re.split、re.findall、re.finditer和re.sub等关键函数的参数与返回值特性,结合代码示例说明分组捕获、非贪婪匹配及替换函数的实际应用,帮助开发者高效掌握正则处理技巧。
本文深入解析Python中re模块的核心用法,涵盖findall、match、search、finditer等匹配类方法,以及sub和split等修改类方法。详细讲解编译优化、大小写忽略、非贪婪匹配及括号分组机制,通过具体代码示例展示如何处理版本字符串、文本分割及复杂模式匹配,帮助开发者高效利用正则表达式进行文本处理。
本文介绍在Python中使用正则表达式匹配以https?://开头、以jpg/png/jpeg结尾的字符串,并排除空格及引号等干扰字符的方法。通过实例演示从基础表达式到优化表达式的过程,展示如何利用[^ ",]排除特定字符,实现精准匹配。
本文详解Python中re模块的match()函数,通过百度视频网页源码实例,演示如何编写正则表达式提取电影名称与链接。涵盖文件读取、逐行匹配、分组提取及代码封装,帮助开发者掌握基础爬虫数据抓取技巧。
本文介绍在 Python 中利用正则表达式判断字符串是否包含简体中文或非简体中文的方法。通过定义匹配 Unicode 汉字范围的编译对象,结合 search 方法实现检测,并提供了完整的代码示例供参考。
本文详解在Python中处理Windows文件名的三种正则表达式策略,对比全转义、部分转义及最佳实践写法。重点解析方括号内特殊字符的处理规则,并补充文件名首尾空格、点号及空白符的清理方法,确保文件命名合规。
本文详细介绍如何使用Python的正则表达式(re模块)来匹配和提取IPv4及IPv6地址。内容涵盖简单与精确的IP验证方法,以及从长文本中高效提取IP地址的技巧,并提供完整的代码示例供参考。
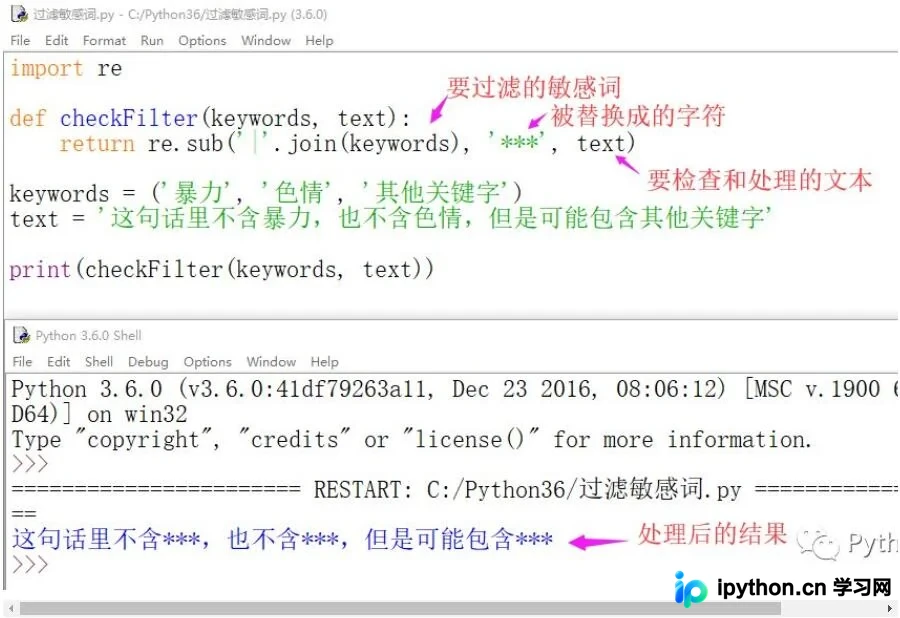
本文介绍如何利用Python的re模块sub()函数结合正则表达式中的竖线“|”语法,实现对用户发帖内容中敏感词的自动检测与字符替换。通过具体代码示例,展示如何高效构建过滤规则,适用于网站内容安全审核场景。
本文介绍在Python文本预处理中,利用re模块的正则表达式功能,将字符串中的连续多个空格合并为单个空格,以及将连续数字替换为特定符号(如num)的方法。通过具体代码示例展示了re.sub函数的实际应用,适用于自然语言处理前的数据清洗场景。