C#利用正则表达式提取网页超链接URL及文本
本文介绍在C#中如何利用强大的正则表达式功能,从一段包含HTML标签的字符串中精准提取超链接(href)及其对应的显示文本(text)。通过定义匹配模式并处理命名组,可以快速实现网页内容的结构化数据抽取。
2026-10-13
6

本文介绍在C#中如何利用强大的正则表达式功能,从一段包含HTML标签的字符串中精准提取超链接(href)及其对应的显示文本(text)。通过定义匹配模式并处理命名组,可以快速实现网页内容的结构化数据抽取。
本文详解如何利用Python正则表达式编写一个抓取内涵段子的爬虫程序。内容涵盖使用urllib2获取网页源码、通过正则表达式匹配特定HTML标签提取段子内容、处理中文编码乱码问题,以及将结果保存至本地文件。通过分步代码示例,展示从数据获取、筛选到持久化存储的完整流程。
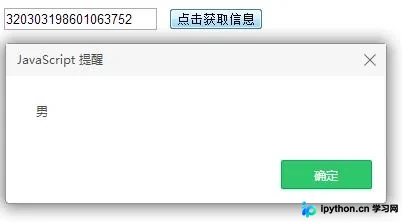
本文介绍如何利用 JavaScript 代码根据用户输入的18位身份证号码,自动提取出生年月并计算当前年龄,同时依据第17位数字奇偶性判断性别。包含完整的 HTML/JS 示例代码及逻辑解析。
本文介绍在Python中同时替换多个字符或字符串的两种常用方法。第一种通过链式调用replace函数实现,直观简单;第二种利用正则表达式re模块,构建模式并配合lambda函数进行批量替换,适用于复杂场景。
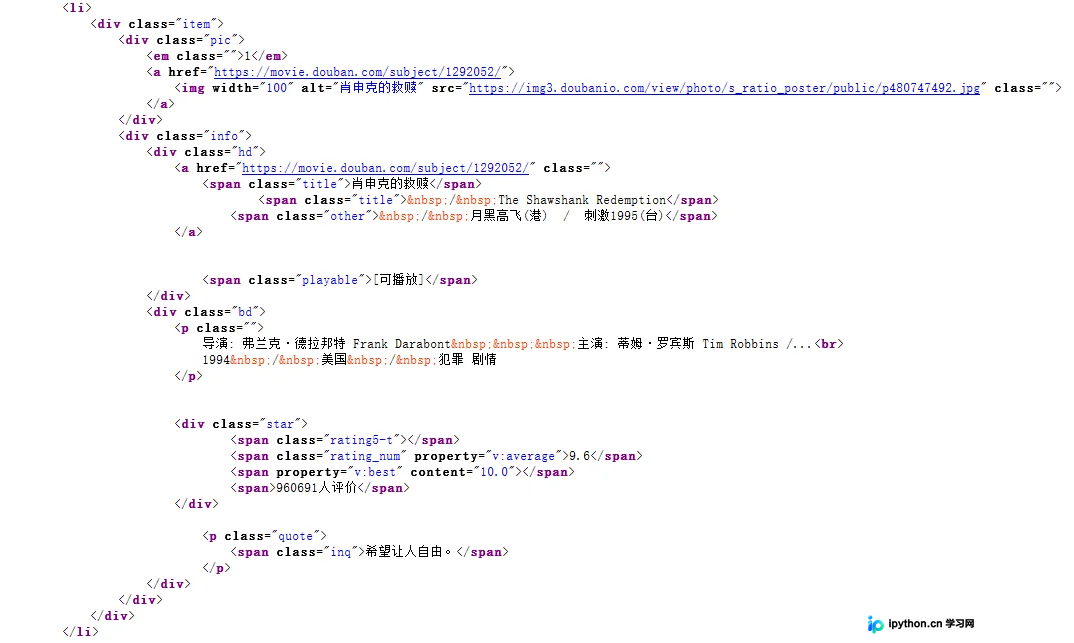
本文详解使用Python requests库与正则表达式爬取豆瓣电影Top250的完整流程。涵盖获取页面源码、解析电影序号、名称、评分及经典台词,并将结果以字典形式追加写入TXT文件。此外,文章对比了常规循环与多线程Pool的实现方式,提供高效获取电影数据的代码示例。
本文深入解析Django路由映射机制,重点讲解URL中^和$符号对路径匹配的限制作用及自定义路由规范。介绍Django APP模块化开发流程,包括独立url.py配置与项目注册。同时涵盖ORM聚合函数使用、多表关系建立方法,以及基于jQuery的Ajax局部刷新实例,帮助开发者掌握从路由分发到数据交互的核心技能。
本文介绍利用Python脚本在自动化测试前全局批量为页面元素添加ID的方法。针对重构导致元素层级变化或定位困难的问题,通过正则表达式匹配特定标签(如el-button)并注入唯一ID属性。文章涵盖Python环境配置、环境变量设置及核心脚本逻辑,帮助测试人员快速优化元素定位稳定性。
本文深入解析Python中反斜杠在不同语境下的行为。在普通字符串中,反斜杠用于转义字符;在原生字符串中其特殊含义被剥夺,但仍受限于不能以奇数个结尾的规则。重点阐述在正则表达式中,反斜杠作为元字符的双重身份:既需转义Python字符串中的特殊字符,又需转义正则元字符。通过对比普通字符串、原生字符串及正则表达式中的写法,阐明匹配纯反斜杠的正确方式及常见陷阱。
本文提供一段Python代码,演示如何递归遍历指定目录下的所有文件,利用正则表达式提取其中的中文字符并保存至结果文件。代码包含字符编码处理、文件读取及递归逻辑,供开发者参考使用。
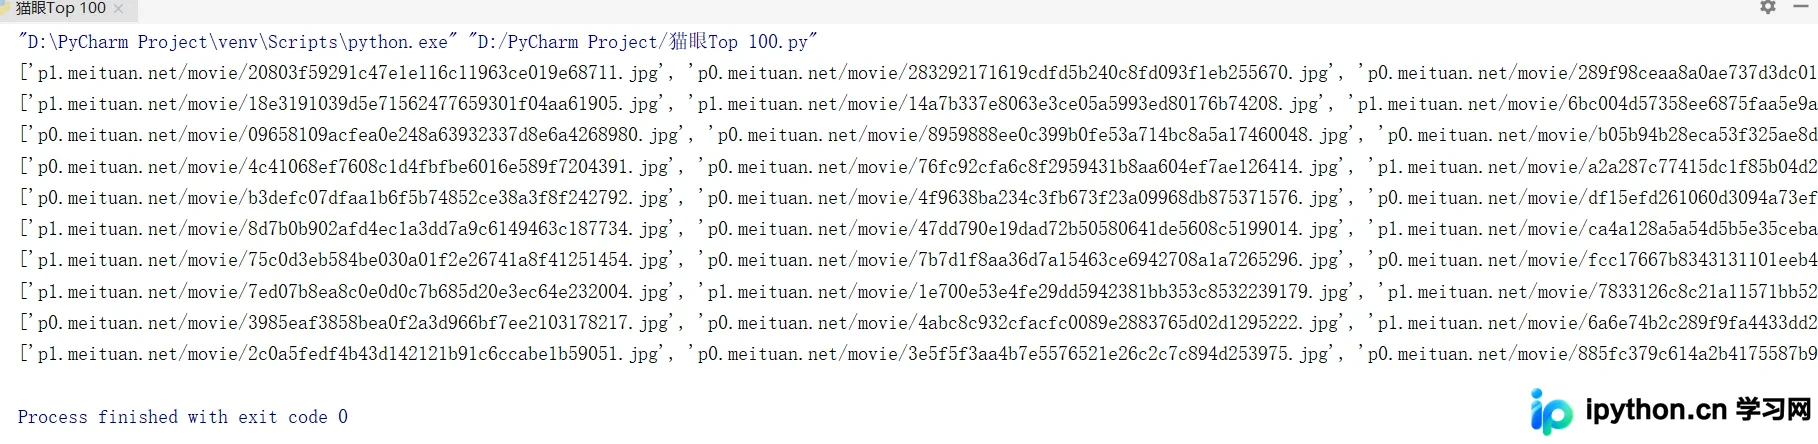
本文通过Python爬虫实战,演示如何使用正则表达式从猫眼电影Top100榜单批量下载电影封面图。文章详细解析了页面元素分析、URL规律观察及正则匹配策略,结合requests与re模块实现数据提取,并探讨该方法的优缺点及与其他爬虫技术的对比。
本文介绍利用Python的docx库结合正则表达式,实现同时批量修改多个Word文档中特定内容的自动化方法。通过遍历段落并执行替换操作,可将指定关键词批量转换为不同目标文本,生成多个新文档,有效提升办公效率。
本文介绍如何使用Python合并多个TXT文件并统计出现频率最高的单词。通过读取指定目录下的文本文件,统一写入新文件后,利用正则表达式提取英文单词并排除常见无意义词汇,最终按频次排序输出前10名。此外,还展示了利用collections.Counter模块简化统计过程的更简洁方法,适用于Windows 10及Python 3.7.4环境。