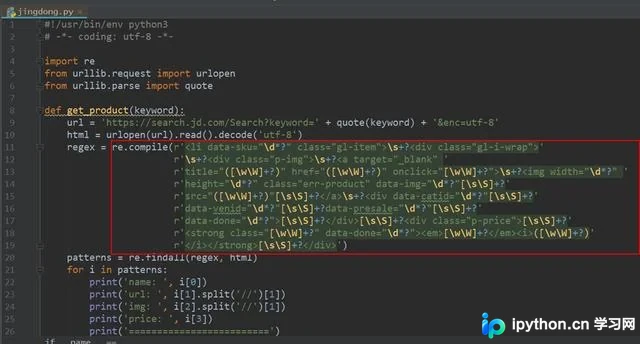
Python3实现B站视频弹幕抓取教程
本文介绍如何使用Python3和requests模块抓取B站视频的历史弹幕数据。通过Chrome开发者工具分析网络请求,定位rolldate和dmroll接口,获取弹幕ID及时间戳。利用正则表达式解析返回的XML数据,按日期保存弹幕内容至本地文件,为后续词云或情感分析提供数据支持。
2026-10-14
5

本文介绍如何使用Python3和requests模块抓取B站视频的历史弹幕数据。通过Chrome开发者工具分析网络请求,定位rolldate和dmroll接口,获取弹幕ID及时间戳。利用正则表达式解析返回的XML数据,按日期保存弹幕内容至本地文件,为后续词云或情感分析提供数据支持。
本文详细介绍如何使用Python的urllib和re模块抓取网页图片。通过获取HTML源码,利用正则表达式过滤图片URL,并实现本地保存功能。代码以百度贴吧为例,演示了从获取源码、解析链接到创建文件夹保存多张图片的完整流程,适合Python初学者参考学习。
本文介绍如何在Python中使用re.subn()函数进行正则表达式替换。该函数不仅返回替换后的字符串,还同时返回实际发生替换的次数。通过compile编译正则对象,结合命名分组语法,可高效处理文本替换任务并获取操作统计信息。
本文介绍Python中正则表达式的后向搜索肯定模式(Lookbehind Assertion)。该模式用于在匹配内容前检查特定条件,但匹配结果不包含该前缀。通过Python代码示例,展示如何利用此模式提取Twitter用户名,并解析相关语法结构及运行结果。
本文介绍在 PHP 中通过正则表达式或内置函数 strip_tags() 清除 HTML 标签、脚本、样式表及注释的方法。提供完整的 preg_replace 数组配置示例,涵盖去除 script/style、过滤实体字符及空白处理,帮助开发者快速实现字符串内容净化。
本文详细记录了使用Python编写小说爬虫的全过程。文章从确定目标网址、分析页面结构入手,重点讲解了如何使用urllib.request获取网页内容,并通过设置Headers解决403 Forbidden错误。同时,针对常见的编码乱码问题,介绍了使用chardet库检测编码及手动指定GBK编码的方法,并结合socket.timeout处理网络超时异常,最终通过正则表达式提取章节内容并写入文件,提供了完整的代码实现参考。
本文详解Python正则表达式中的分组机制,包括无名分组与命名分组的语法及提取方法。深入解析后向引用实现字符串交换,以及前向/后向肯定与否定断言在复杂匹配中的应用,附带代码实例与实用工具推荐。
本文深入解析Python正则表达式中的贪婪与非贪婪匹配机制。通过具体代码示例,详细阐述默认贪婪行为导致的匹配偏差,并介绍使用问号?实现非贪婪匹配的方法。此外,还探讨了利用零宽断语(?=)和(?!解决字符消耗问题的技巧,帮助开发者更精准地控制正则表达式的匹配行为。
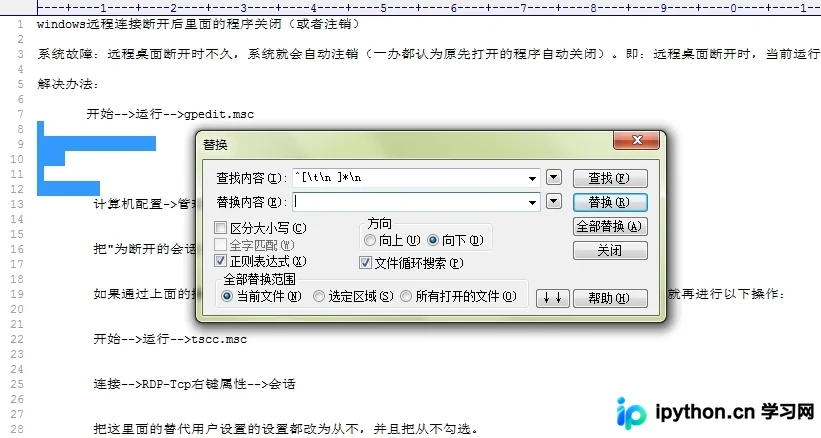
本文介绍如何在PHP和EditPlus中使用正则表达式高效去除字符串中的空白行。在PHP中,可通过特定正则模式清理行内连续空行或全盘清除所有空行;在EditPlus编辑器中,利用行首尾匹配规则即可快速替换多出的换行符,提升代码整洁度。
本文介绍 JavaScript 中正则表达式的基础知识与核心方法。通过对比传统循环与正则提取数字的示例,阐述正则的高效性。详细解析了 re.test()、str.search()、str.match() 和 str.replace() 四个常用方法的语法、参数含义及 flags(如 i, g)的使用场景,帮助开发者掌握字符串模式匹配与处理技巧。
本文系统梳理Python爬虫的核心知识点,涵盖从Python基础语法、urllib/urllib2网络请求库,到正则表达式数据提取,再到Scrapy高级框架的完整学习路径。同时解析爬虫背后的HTTP请求、DNS解析及服务器响应机制,帮助初学者建立完整的爬虫知识体系。
本文系统总结Python网络爬虫中常用的四种数据提取工具:正则表达式、BeautifulSoup、Lxml及CSS选择器。通过对比分析各模块的安装方式、解析原理、代码构造难度及运行性能,指出Lxml因C语言底层实现而在速度与健壮性上占优,而BeautifulSoup适合轻量级场景。文章提供各选择器的典型用法示例,帮助开发者根据实际需求选择最合适的数据抓取方案。