Python3使用python-redis-lock解决Redis高并发读写冲突
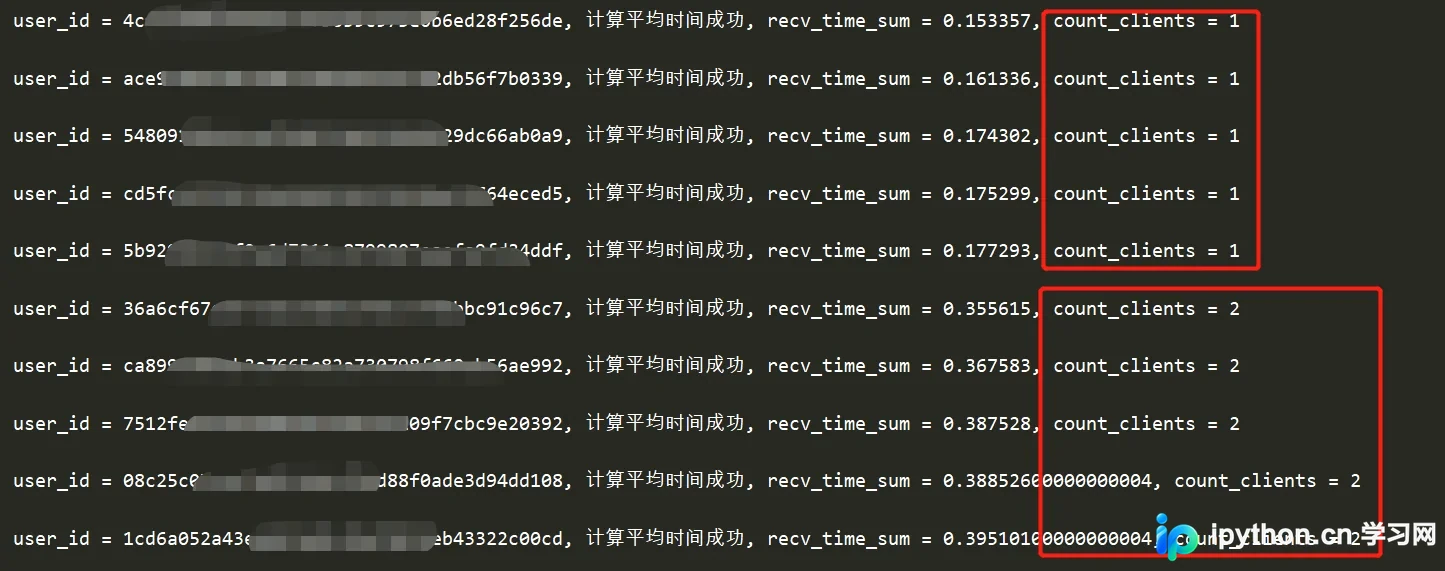
本文针对Redis高并发场景下客户端读写数据相互覆盖的问题,介绍使用python-redis-lock库实现分布式锁的方法。通过示例代码演示如何获取锁、执行业务逻辑并释放锁,有效避免多客户端同时读取同一数据导致的计算错误,确保数据一致性。
2026-10-14
6

本文针对Redis高并发场景下客户端读写数据相互覆盖的问题,介绍使用python-redis-lock库实现分布式锁的方法。通过示例代码演示如何获取锁、执行业务逻辑并释放锁,有效避免多客户端同时读取同一数据导致的计算错误,确保数据一致性。
本文详细介绍如何在Django项目中集成Celery实现异步发送短信验证码。涵盖Celery核心组件(Beat、Worker、Broker)的工作原理,以及从创建Celery应用、配置Redis中间件、定义异步Task到在视图层调用的完整代码示例。通过实例演示如何启动Celery服务并处理高并发场景下的短信发送需求。
本文详细介绍Python3中操作Redis List列表的常用命令,包括LPUSH、RPUSH、LRANGE、LPOP、RPOP等核心API的使用方法与参数说明。通过具体的代码实例演示了列表的增删改查、阻塞操作及元素插入删除等常见场景,帮助开发者快速掌握Redis列表在Python中的应用。
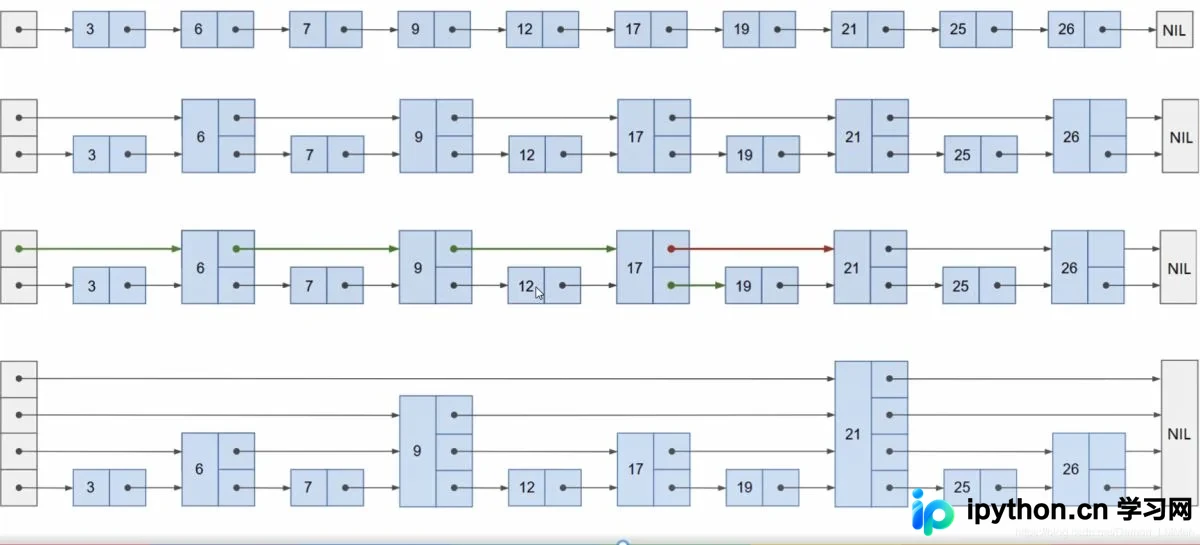
本文介绍跳表(SkipList)这一高效的数据结构,其初衷为替代红黑树。详细解析了跳表在Redis SortedSet和LevelDB MemTable中的应用,并通过Python完整代码展示了节点定义、查找、插入及删除操作的实现逻辑,平均时间复杂度为O(logn)。
本文详细介绍在Django项目中配置Memcached和Redis作为缓存后端的完整步骤,涵盖Windows与Linux系统的安装、服务启动及Django settings.py配置方法。通过对比数据结构、键值上限、持久化支持等核心特性,分析两者差异,并给出针对中大型网站的选型建议,帮助开发者提升网站性能。
本文详细介绍在Python3爬虫项目中安装RedisDump的方法。由于RedisDump基于Ruby实现,需先配置Ruby环境及rvm工具。文章涵盖通过gem命令安装redis-dump的详细步骤,包括国内源配置、版本验证及命令测试,帮助开发者顺利完成Redis数据迁移工具的部署。
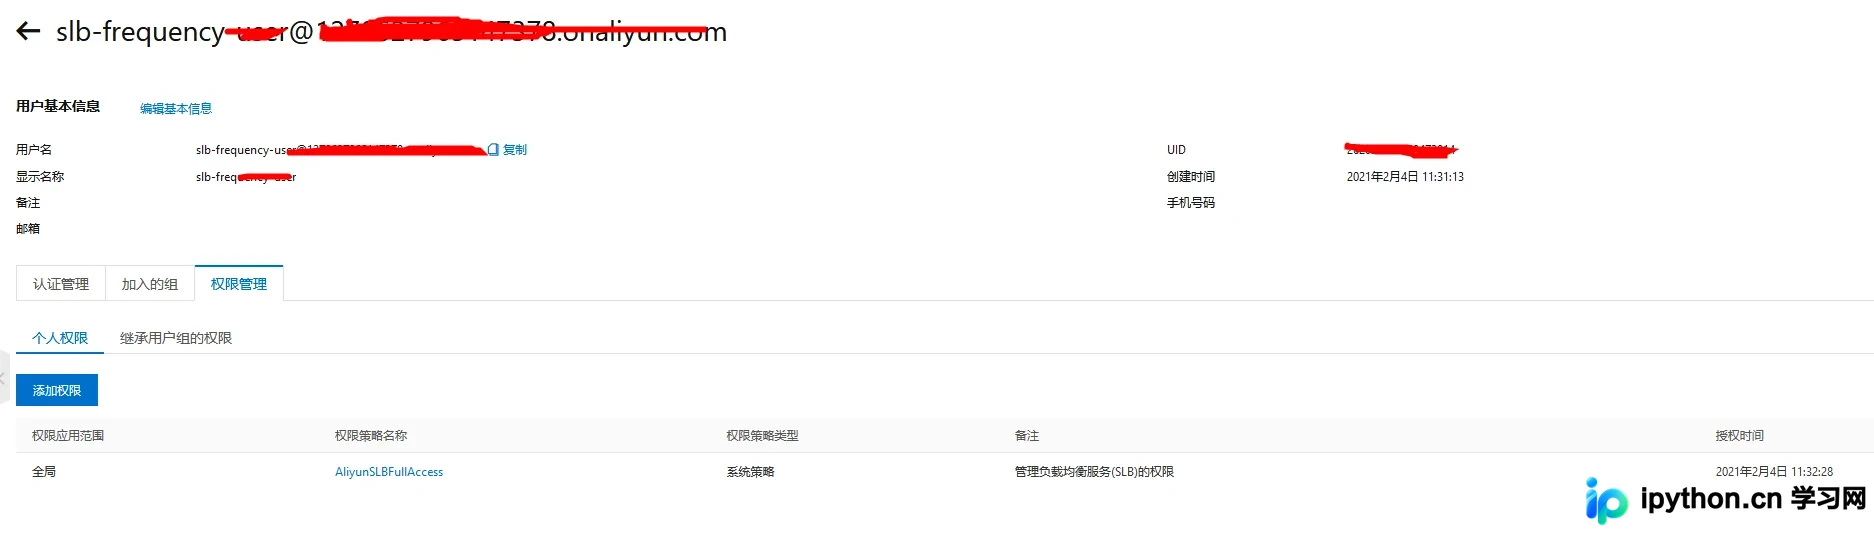
本文介绍如何使用Python脚本结合阿里云SLB访问控制策略与Redis缓存,实现针对恶意攻击IP的自动封堵。通过解析Nginx日志识别高频访问IP,利用SLB API动态添加黑名单,并借助Redis设置过期时间以管理封禁时长,有效解决SLB封禁数量限制问题。
本文详细解析Python分布式爬虫中消息队列的核心作用,通过生活化类比阐释其去重与任务分发机制。重点介绍如何利用Redis队列构建生产端,实现多爬虫节点对URL任务的有序获取与高效处理,避免重复爬取,为构建高性能分布式爬虫系统提供实践参考。
本文提供Python调用Redis的完整示例代码,通过封装MyRedis类实现服务器连接、有序集合添加与计数等常用操作。代码包含详细的参数配置说明,适用于需要快速集成Redis功能的Python项目,帮助开发者掌握基础连接与数据结构交互方法。
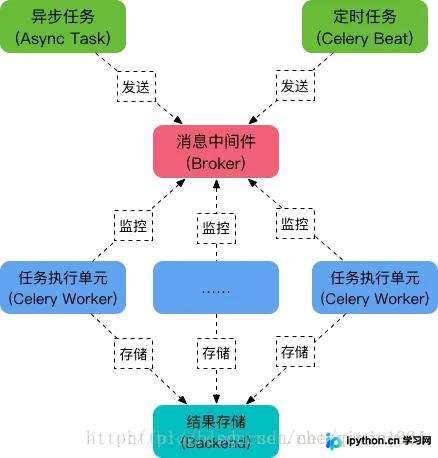
本文详细介绍如何在Django项目中集成Celery以实现异步和定时任务。涵盖Celery架构模块、环境配置(Django、Redis版本建议)、Broker与Worker设置,以及通过django-celery创建和调用异步任务的具体步骤。
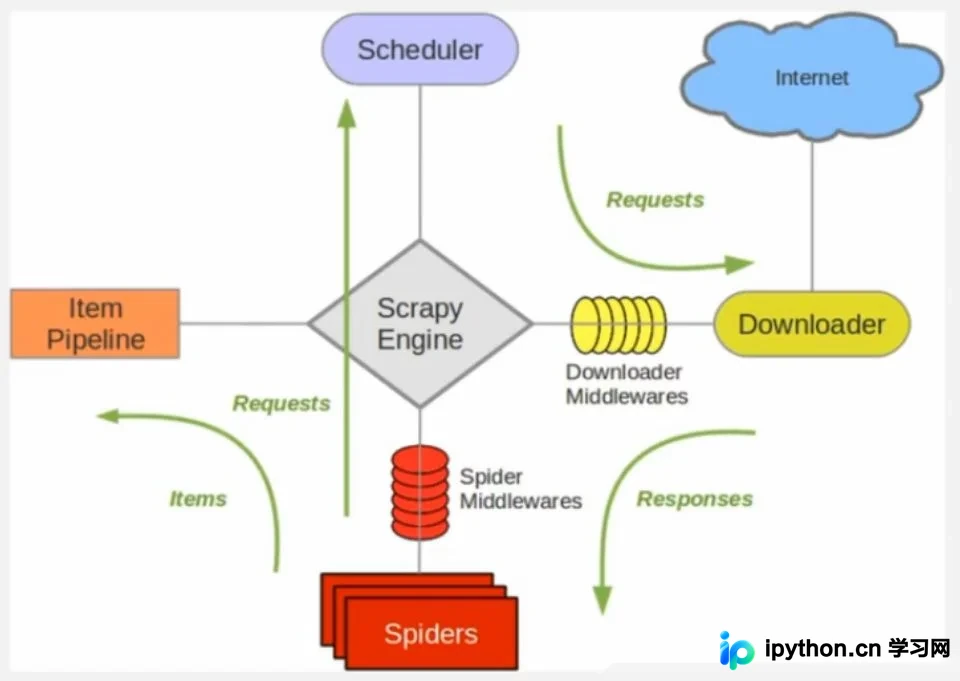
本文深入解析Scrapy-Redis分布式爬虫的核心原理与搭建流程。通过对比Scrapy与Scrapy-Redis的架构图,详细阐述Master端与Slaver端的协作机制,包括URL指纹判重、Request分配及数据存储策略。同时提供从环境配置、依赖安装到代码编写的完整实操指南,帮助开发者高效构建高性能分布式数据采集系统。
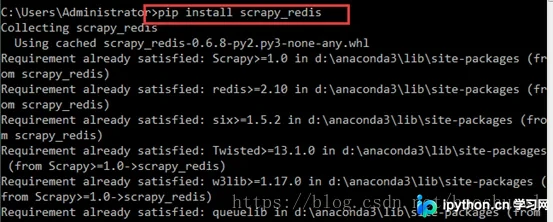
本文详细介绍如何利用scrapy_redis库将Scrapy爬虫升级为分布式架构。内容涵盖环境准备、Settings配置修改、Spider类重写以及Redis数据源注入等关键步骤,帮助开发者实现多台服务器共享URL去重与数据存储,提升爬取效率。