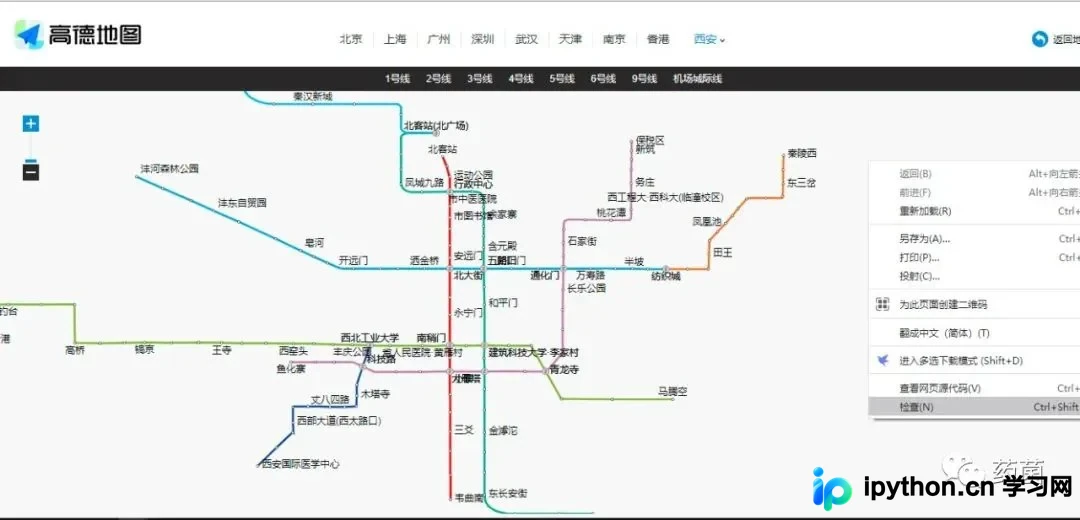
Python爬虫爬取高德地图数据制作高清无水印地铁线路图
本文介绍如何利用Python爬虫从高德地图获取地铁站点经纬度数据,并通过Arcpy生成Shapefile文件,最终制作出高清无水印的个性化地铁线路图。
2026-10-15
3

本文介绍如何利用Python爬虫从高德地图获取地铁站点经纬度数据,并通过Arcpy生成Shapefile文件,最终制作出高清无水印的个性化地铁线路图。
本文介绍基于Python3和Windows环境的爬虫开发基础,涵盖Anaconda与Jupyter工具使用。详细解析Robots协议规范、动态页面处理及反爬策略。同时展望Python在数据分析、人工智能、运维自动化及Web开发领域的核心应用与实战价值。
本文详细解析Python中urllib标准库与第三方库urllib3的区别。urllib包含request、parse、error和robotparser四个模块,适用于基础网络请求。urllib3功能更强大,支持连接池、线程安全、代理及SSL验证。文章通过代码示例对比两者在GET/POST请求、Cookie处理、代理设置、文件上传及超时处理上的具体用法,帮助开发者根据需求选择合适的库。
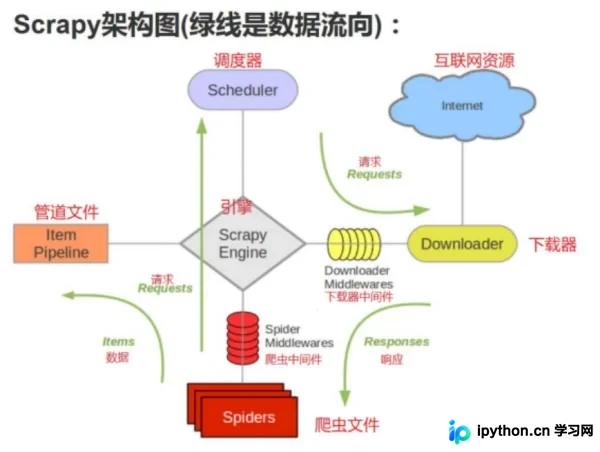
本文深入解析Scrapy爬虫框架的核心结构,详细阐述引擎、调度器、下载器、蜘蛛及管道等关键组件的功能与交互机制。通过梳理项目目录结构与数据流动路径,帮助开发者理解Scrapy为何被视为完整框架而非简单库,并掌握其高效处理网络请求与数据提取的工作原理。
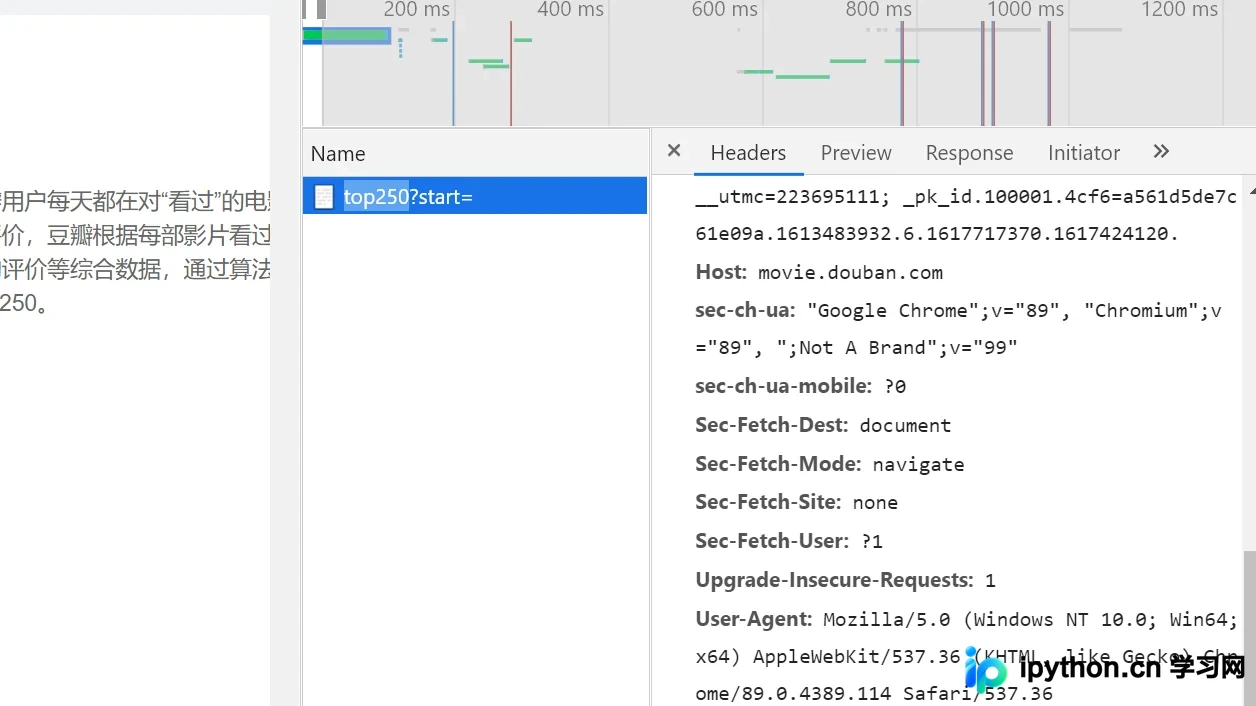
本文详细介绍如何使用Python爬取豆瓣电影Top250数据。通过urllib.request获取HTML源码,利用BeautifulSoup和正则表达式解析电影名称、评分及链接,最后使用xlwt库将结果保存为Excel文件。教程涵盖反爬处理、分页逻辑及数据清洗,适合Python初学者学习网络爬虫基础。
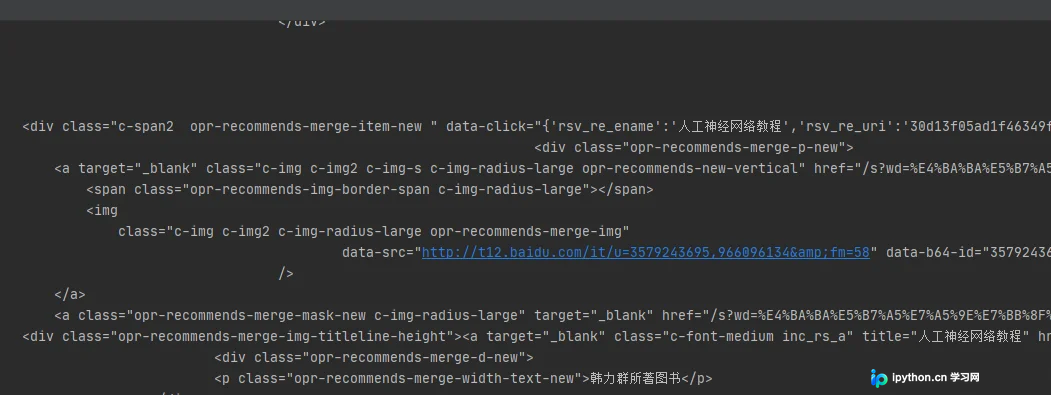
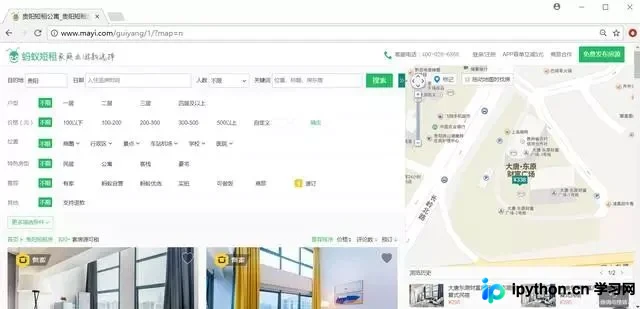
本文详细介绍如何使用Python爬虫应对网站反爬机制。针对蚂蚁短租的访问拦截,通过浏览器开发者工具获取Cookie和User-Agent,并在Python代码中通过urllib2设置Headers提交请求。结合BeautifulSoup解析HTML节点,成功获取贵阳地区短租房的名称、价格、评分及链接等详细信息,并存储为CSV文件。
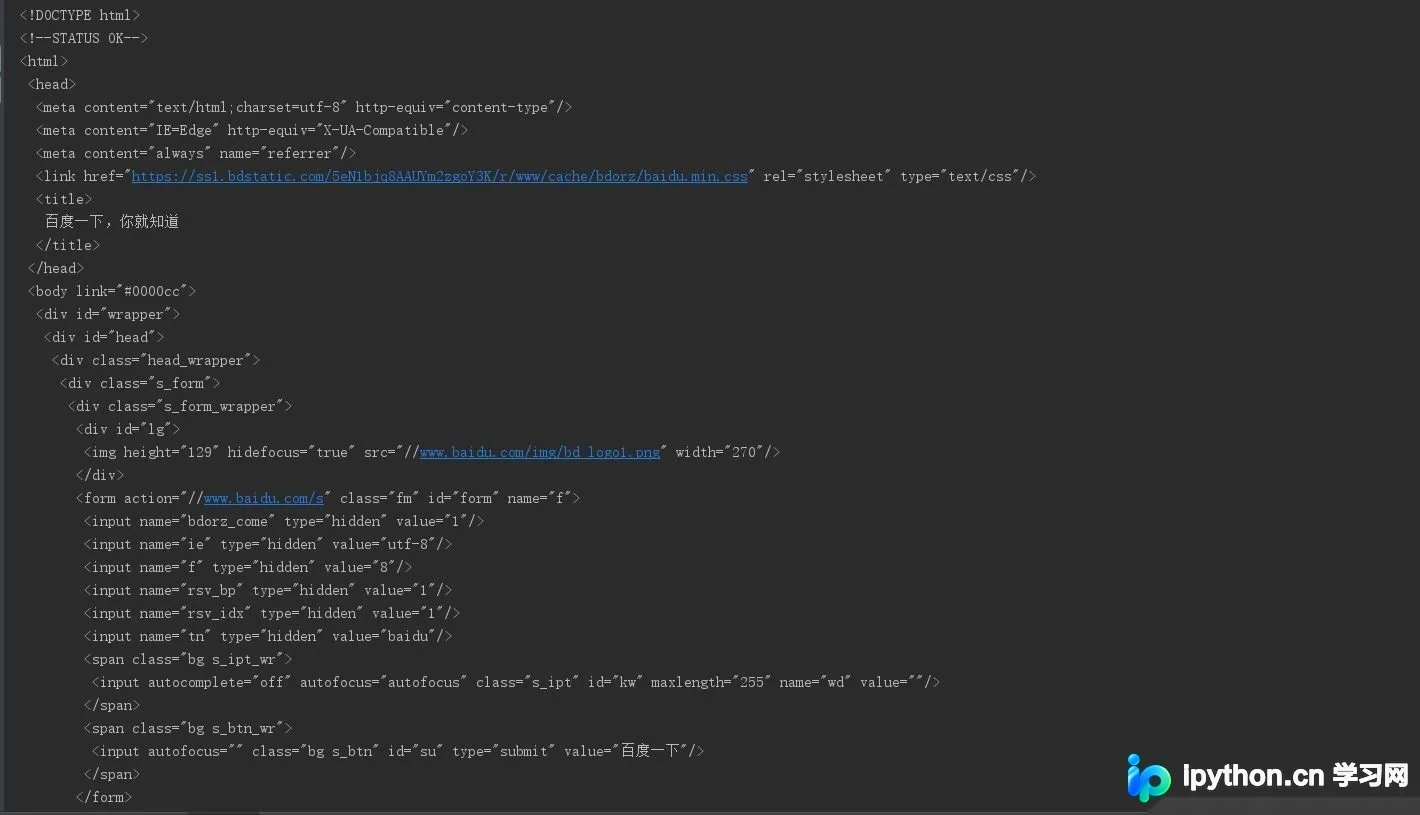
本文详解Python中BeautifulSoup库的核心用法,涵盖从安装配置到解析器选择(html.parser、lxml等)。深入解析Tag、NavigableString、Comment三大基本元素,系统讲解下行、上行及平行遍历技巧,并演示如何利用find_all结合正则表达式精准提取网页数据,助力爬虫开发入门。
新版Selenium已不再支持PhantomJS,本文详细介绍如何在Python爬虫项目中安装并配置ChromeDriver以支持动态网页抓取。内容涵盖安装必要性、官方资源链接,以及针对Mac系统的Homebrew安装方法(含备用方案)和Windows环境下的版本验证步骤,帮助开发者顺利实现Headless Chrome自动化测试与数据采集。
本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。
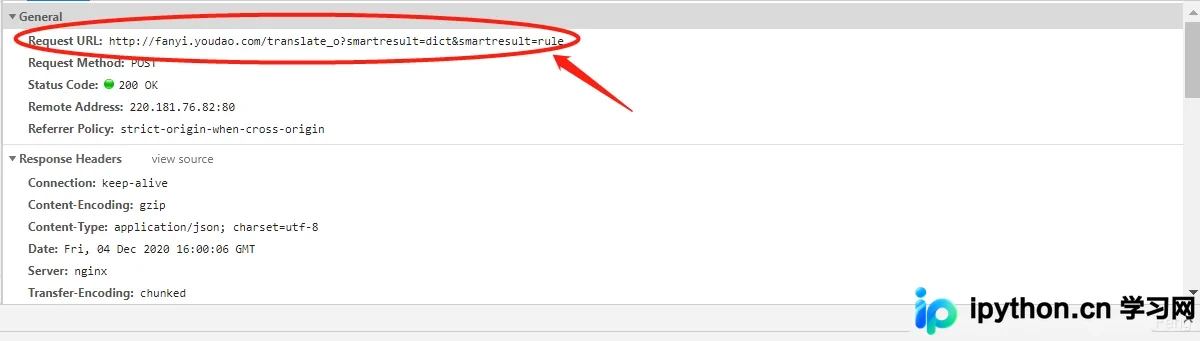
本文详细介绍如何使用Python爬取有道词典的翻译结果。通过Chrome开发者工具分析网络请求,获取翻译接口的URL、参数及Header信息,并利用urllib库构建POST请求。文中提供了完整的Python代码示例,演示如何伪装用户代理、提交翻译内容并解析返回的JSON数据,帮助开发者掌握基础爬虫技巧。
本文详细介绍Python Selenium中处理网页下拉框的方法。通过Select类提供的select_by_value、select_by_index等函数,结合鼠标悬停、点击及警告框处理,实现自动化操作。文章包含完整代码示例与HTML结构解析,帮助开发者灵活定位并操作下拉选项。
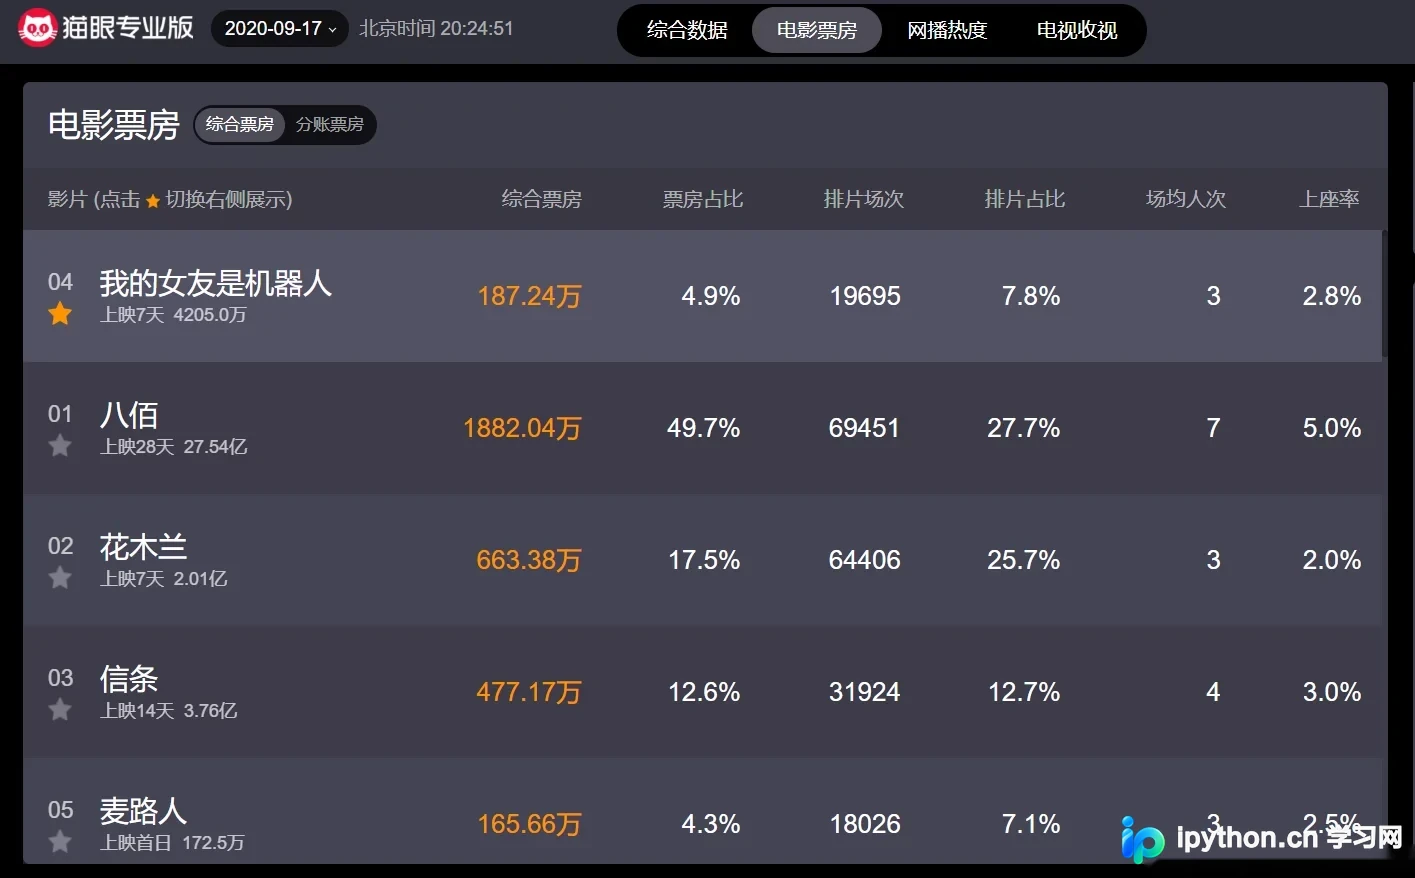
本文详细介绍如何使用Python抓取猫眼电影最近上映电影的票房信息。通过配置Python 3.6环境,利用requests模块发送HTTP请求获取JSON数据,解析电影名、票房、排片占比等关键字段,并最终将结果保存至CSV文件。适合Python初学者进行数据抓取实战练习。