Python爬虫urllib异常处理详解:URLError与HTTPError实战
本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
2026-10-15
2

本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
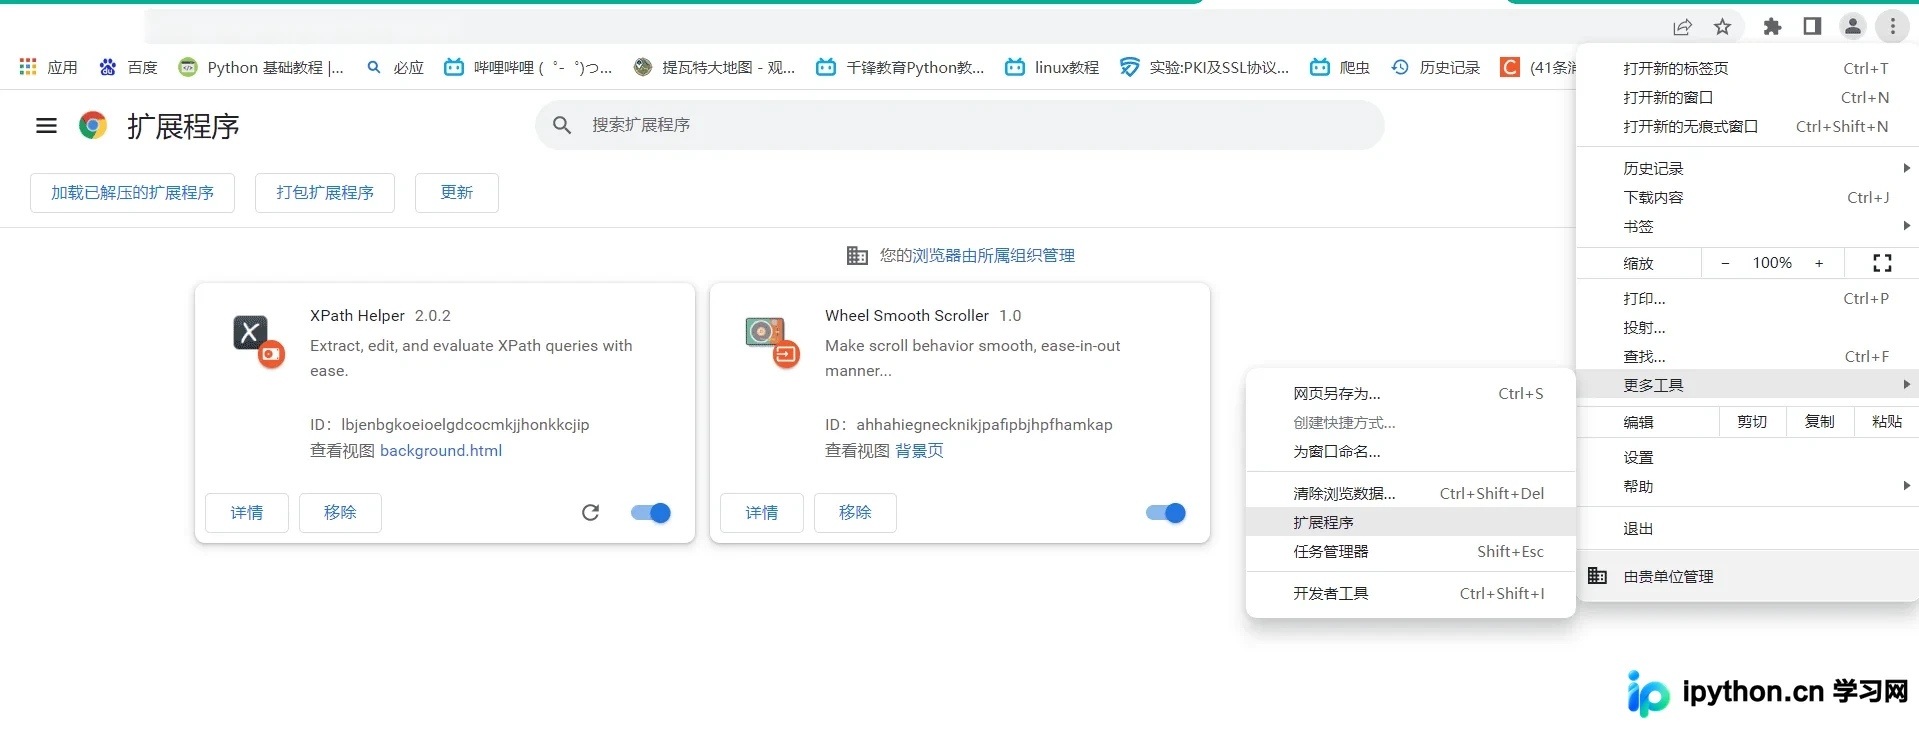
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。
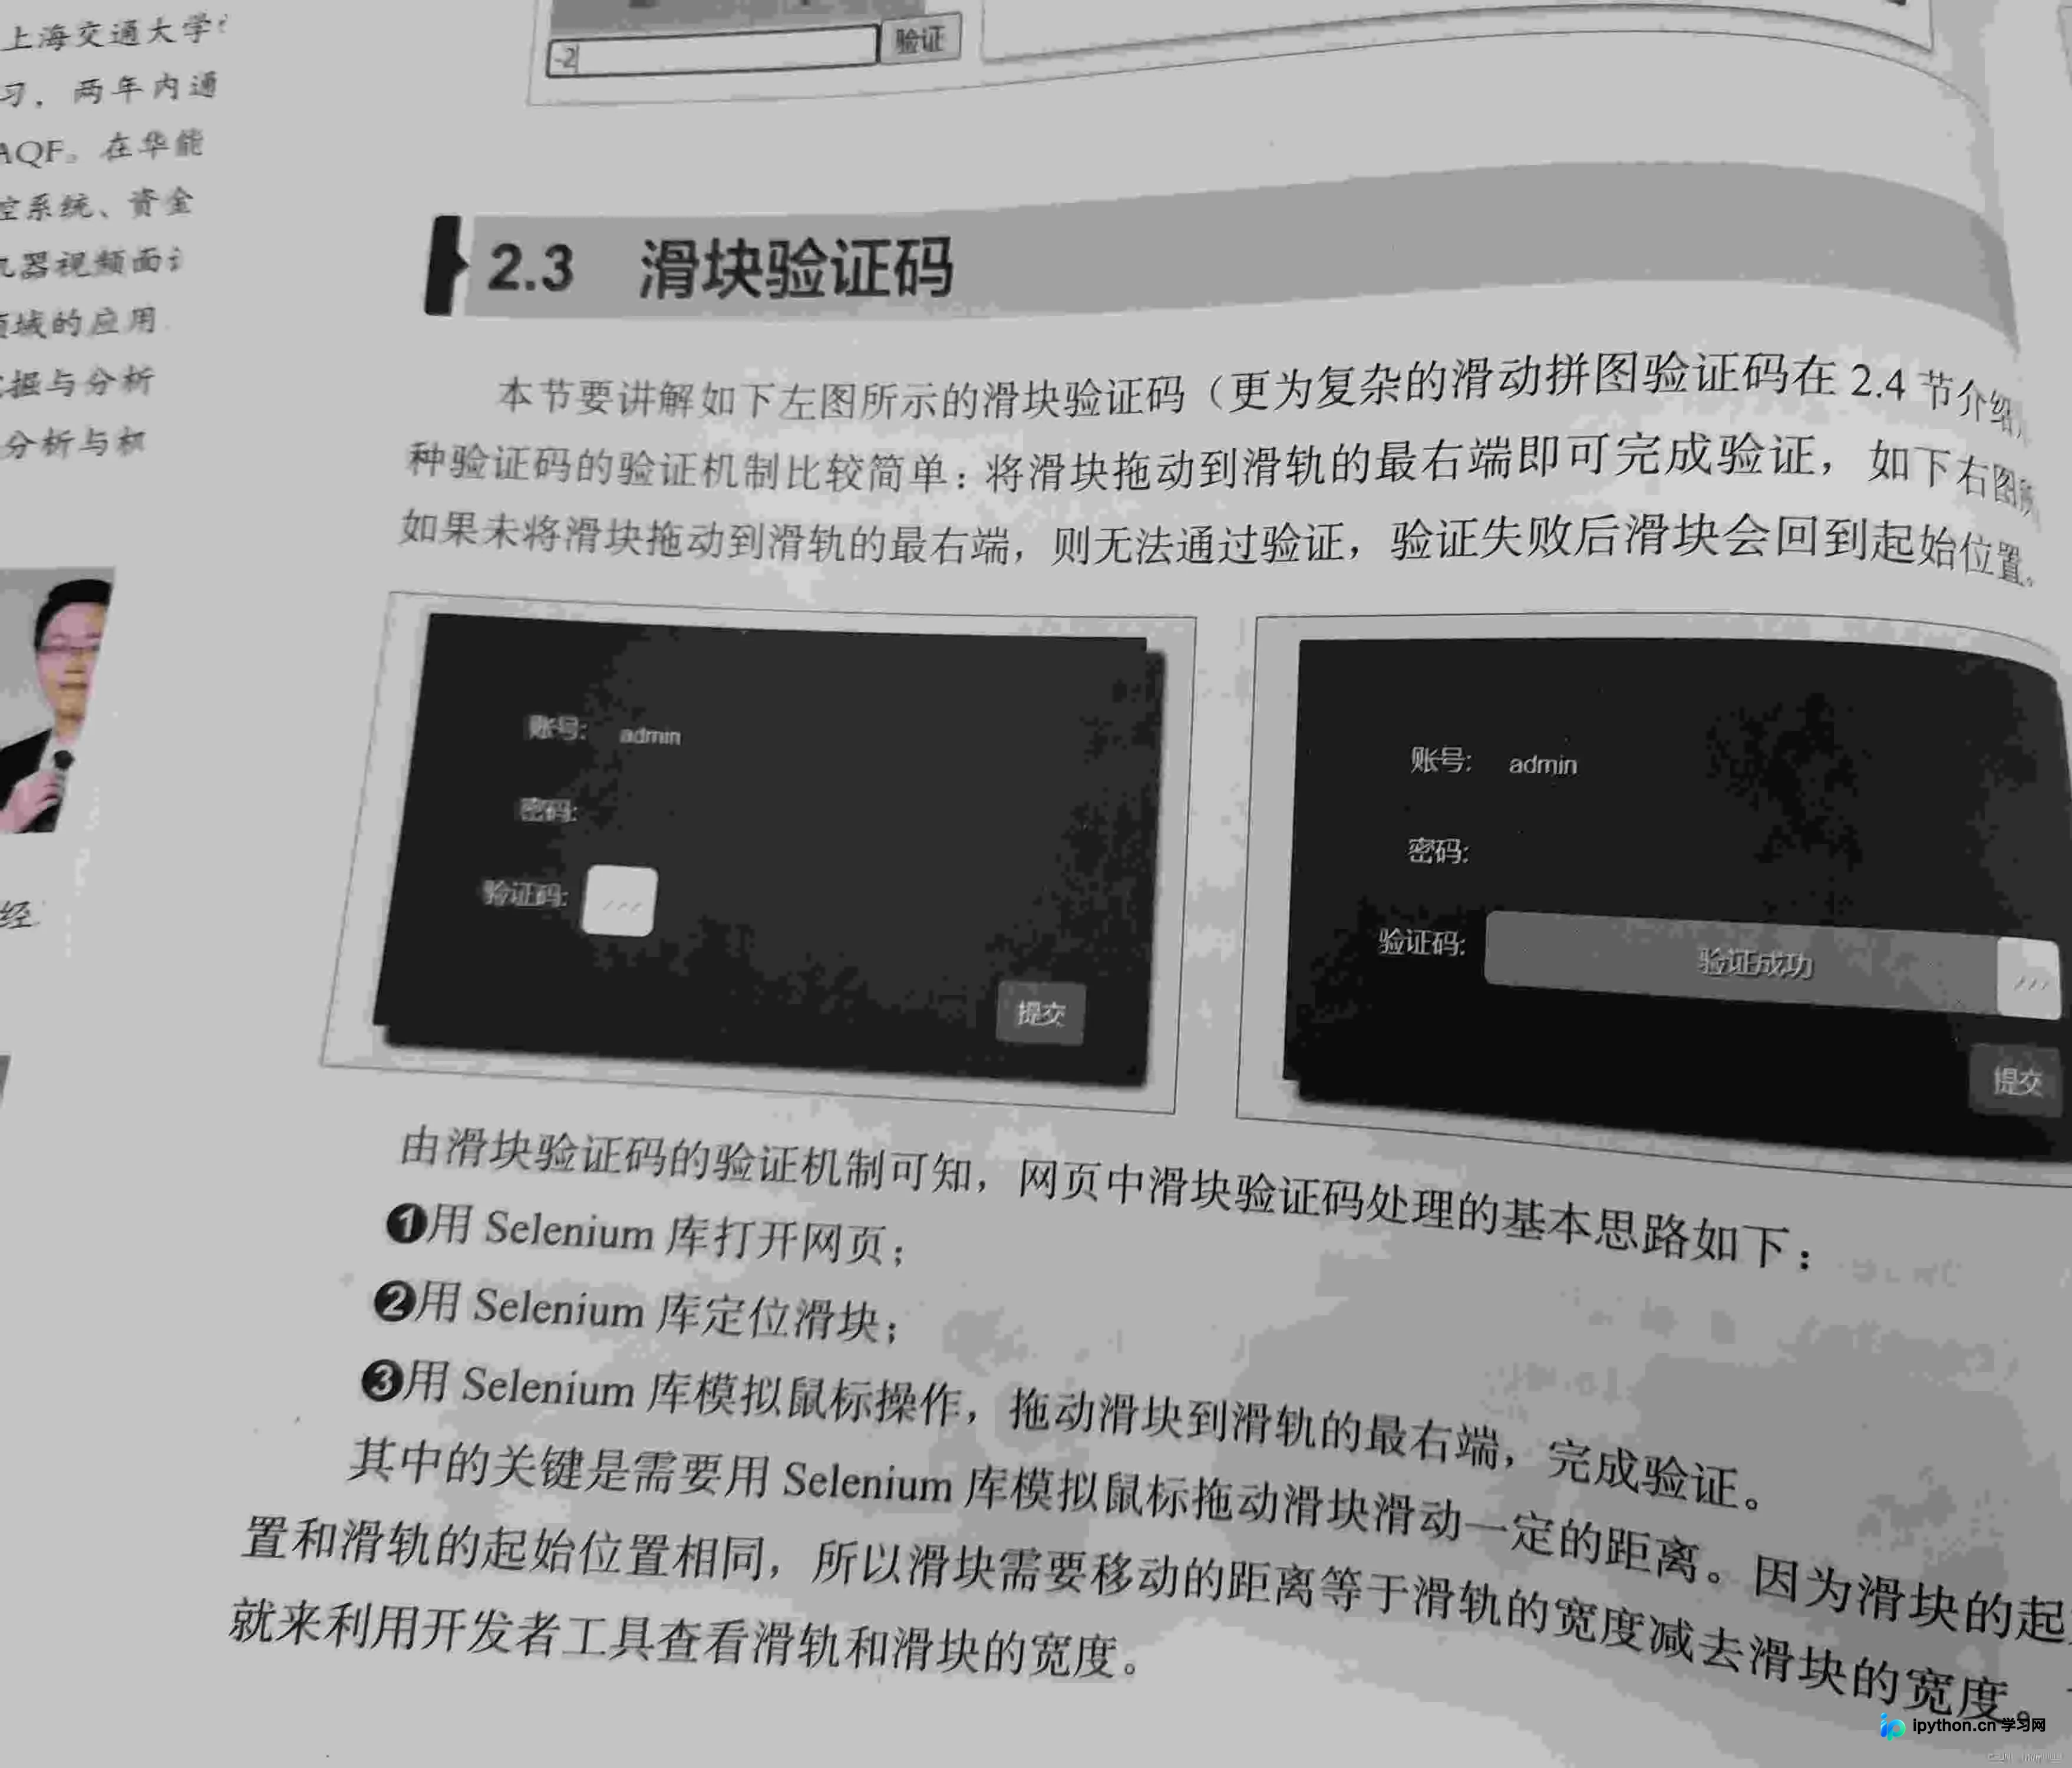
本文详解如何使用Python Selenium库模拟滑块验证码。通过开发者工具获取滑轨与滑块尺寸,计算需移动的距离(如260像素),并利用ActionChains模块的click_and_hold、move_by_offset及release方法模拟鼠标拖拽动作。此外,还介绍了针对webdriver检测的反爬应对策略,包括手动登录配合Selenium继续爬取的方案。
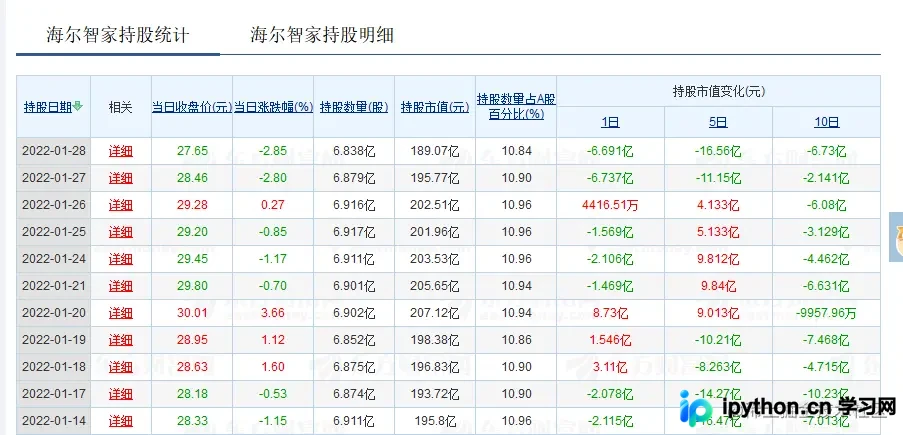
本文详细介绍如何使用Python爬虫技术抓取东方财富网北上资金逐日持仓数据。通过逆向分析API接口参数,利用requests库获取JSON数据,并结合prettyTable进行格式化展示。此外,文章还构建了一个简单的线性筛选模型,用于识别近期连续加仓且幅度超过流通股份1%的股票,为量化分析提供基础参考。
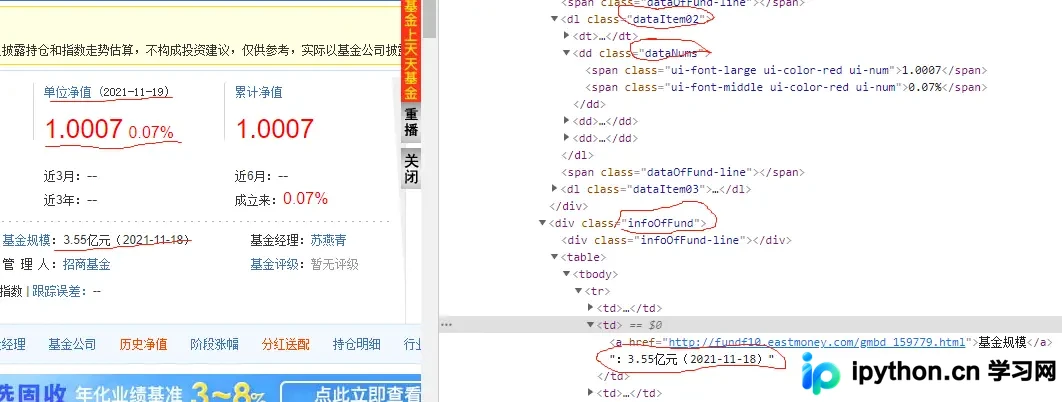
本文详解如何使用Python爬虫获取基金最新交易日的单位净值、涨跌幅及基金规模数据。通过解析HTML标签定位关键信息,并结合pymysql库进行数据库连接配置与SQL操作,实现数据的结构化存储,为后续基金分析与投资决策提供数据支持。
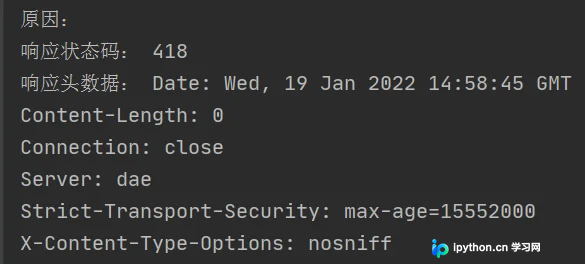
本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
本文详解Scrapy框架中下载中间件的编写方法。涵盖process_request、process_response及process_exception三大核心函数的实现逻辑,演示如何通过中间件进行UA伪装、响应数据篡改(结合Selenium处理动态加载)以及代理IP设置,并说明在settings.py中启用中间件的具体配置步骤。
本文详细介绍如何使用Python编写一个简单的爬虫程序,批量下载电脑壁纸。通过结合Requests进行HTTP请求、XPath解析HTML结构以及Pinyin库处理中文路径,实现从指定类型和页码中自动抓取高清壁纸。文章涵盖工具准备、核心代码逻辑解析及完整可运行代码,旨在提供技术交流参考,非商业用途。
本文详细介绍Python第三方库requests的基本用法,涵盖安装配置、GET与POST请求、参数传递、JSON解析、文件保存、代理设置、Cookie维持及异常处理等核心功能,帮助开发者快速掌握HTTP客户端操作。
本文深入解析Python爬虫中XPath的核心用法。从lxml库的安装与etree对象实例化入手,详细讲解子节点、属性、索引及文本提取等XPath表达式语法。通过本地HTML测试与58同城二手房信息抓取实战,演示如何定位节点并提取关键数据,帮助开发者掌握高效的数据抓取技巧。
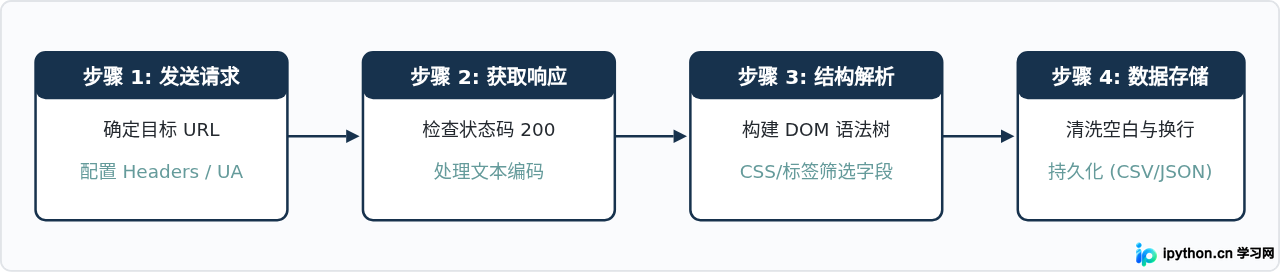
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
本文介绍如何使用Python编写一个简单的爬虫程序,从特定图片网站批量下载图片。通过Requests发起HTTP请求获取页面源码,利用Lxml结合XPath定位封面链接及高清图片地址,最后将图片保存至本地文件夹。文章包含完整代码示例及优化建议。