

Python正则表达式匹配中文的完整指南
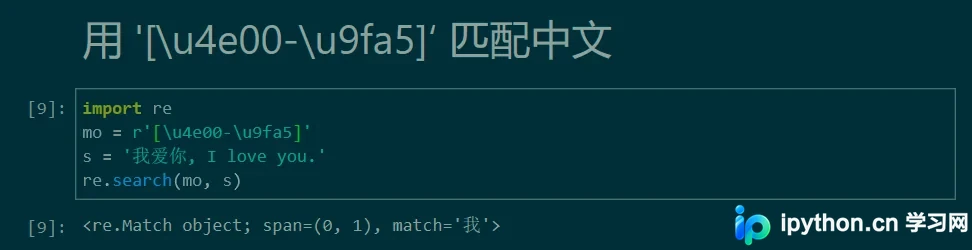
本文详细解析Python中正则表达式匹配中文的核心原理,重点讲解 `\u4e00-\u9fa5` 编码范围的使用。通过 re 模块的 `search` 和 `findall` 方法,演示如何精准提取单个中文字符、连续中文片段及所有中文内容。文章涵盖字符集范围说明及编码注意事项,帮助开发者解决跨语言文本处理中的匹配难题。
2026-10-11
3

本文详细解析Python中正则表达式匹配中文的核心原理,重点讲解 `\u4e00-\u9fa5` 编码范围的使用。通过 re 模块的 `search` 和 `findall` 方法,演示如何精准提取单个中文字符、连续中文片段及所有中文内容。文章涵盖字符集范围说明及编码注意事项,帮助开发者解决跨语言文本处理中的匹配难题。
本文介绍Python中使用re模块进行数字匹配的方法。通过\d+可提取字符串中的数字片段,但会包含嵌入数字。若需识别纯数字,应使用\b\d+\b结合单词边界(空格、标点等)进行精确匹配,避免误识别字符串内的数字部分。
本文介绍如何使用Python内置的re模块进行正则表达式操作。通过导入模块、编译模式字符串、使用search()和split()方法,您可以高效地搜索、匹配和分割文本数据。文章涵盖基础语法、特殊字符处理及常见应用场景,帮助开发者掌握Python文本处理的核心技能。
本文系统梳理Python3标准库中高频使用的核心模块,涵盖文件与目录操作(os、shutil、glob)、系统交互(sys)、文本处理(re、string)、数学与随机数(math、random)、网络通信(urllib、smtplib)、时间处理(datetime)及数据压缩(zlib等)。通过具体代码示例展示各模块的关键用法,并介绍性能测试(timeit、profile)与自动化测试(doctest、unittest)的最佳实践,帮助开发者高效利用内置资源。
本文详解Python中正则表达式处理字符串的核心方法。重点介绍使用re.subn进行替换并获取次数,利用re.split进行拆分,以及通过re.match和re.search判断匹配状态。同时展示如何编译正则对象并提取匹配细节,帮助开发者高效处理文本数据。
针对头歌实训平台中Python re模块的评测痛点,梳理核心函数区别、贪婪与非贪婪量词、捕获分组与转义细节,提供体系化的解题流程与调试技巧。
本文详细解析Python中re.search()函数的使用方法,对比其与find()函数的异同。通过逐步构建正则表达式,演示如何从简单字符查找进阶到复杂IP地址(0-255范围)的精准匹配,涵盖分组、量词及边界处理等核心技巧,帮助开发者掌握正则表达式在字符串处理中的实际应用。
本文深入解析Python中正则表达式的贪婪与非贪婪模式。通过代码实例说明默认贪婪模式会匹配尽可能多的字符,而在量词后添加问号可启用非贪婪模式,匹配最少字符。文章结合源码分析,解释*?、+?等忽略优先量词的工作原理,帮助开发者准确控制正则匹配行为。
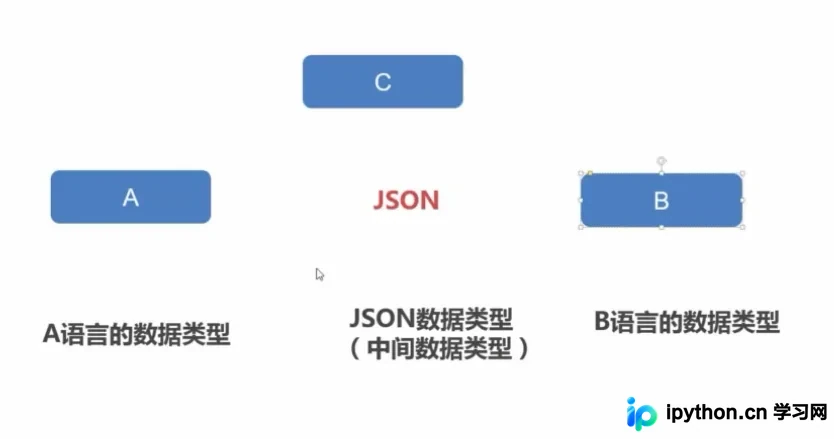
本文详细介绍Python中正则表达式的基本用法,涵盖元字符、字符集、数量词、贪婪模式及分组匹配等核心概念,并结合re模块函数进行实战演示。同时深入解析JSON数据交换格式,对比XML优势,讲解JSON字符串与对象的区别,以及Python中json模块的序列化与反序列化操作,帮助开发者掌握文本处理与数据交互的关键技术。
本文详解Python中re模块的正则表达式应用,涵盖match、search、findall及split函数的具体用法。通过对比各函数在匹配位置、返回结果形式上的差异,结合完整代码示例,帮助开发者快速掌握字符串处理技巧,提升代码简洁性与执行效率。
本文通过三道Python正则表达式面试题,详细演示了如何使用re模块处理常见文本清洗任务。内容涵盖利用sub方法去除HTML标签、从URL中提取域名,以及通过split或findall方法提取字符串中的单词。每道题均提供完整代码示例与运行结果,帮助开发者掌握正则表达式在数据预处理中的实际应用技巧。
本文系统介绍Python中正则表达式的基础语法、匹配原理及re模块的核心方法。详细解析贪婪与非贪婪模式的区别,列举compile、match、search、findall等常用函数的参数与返回值,并通过代码示例展示匹配对象的使用,帮助开发者高效处理字符串匹配任务。