Python实现strip()函数的正则表达式方法解析
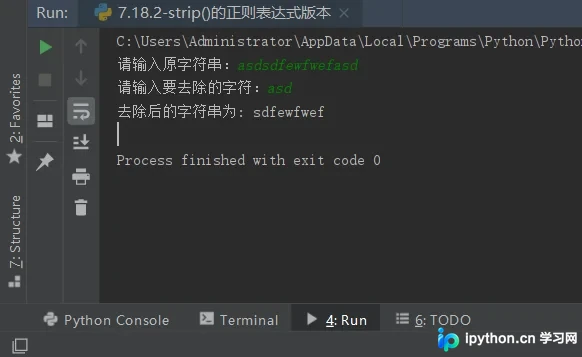
本文详细解析了如何使用Python的正则表达式模块re来模拟内置strip()函数的功能。通过构建包含首尾匹配符^和$的正则模式,结合format方法动态传入待去除字符,实现了灵活的字符串首尾清理。代码演示了如何处理默认空白字符及自定义字符的去除逻辑,为理解正则表达式在字符串操作中的应用提供了具体案例。
2026-10-13
2

本文详细解析了如何使用Python的正则表达式模块re来模拟内置strip()函数的功能。通过构建包含首尾匹配符^和$的正则模式,结合format方法动态传入待去除字符,实现了灵活的字符串首尾清理。代码演示了如何处理默认空白字符及自定义字符的去除逻辑,为理解正则表达式在字符串操作中的应用提供了具体案例。
本文介绍如何利用Python的re模块结合正则表达式来检测字符串中是否包含英文字母。通过编译匹配规则并遍历字符串,示例代码清晰展示了判断逻辑与输出结果,适用于需要处理文本内容的开发场景。
本文介绍如何使用Python正则表达式验证IP地址,提供完整的代码示例。通过re模块的compile、finditer及search方法,演示如何提取IP地址及捕获分组信息,适用于网络数据处理场景。
本文详细解析Python re模块中贪婪与非贪婪模式的匹配机制。通过对比示例,说明默认贪婪模式尽可能匹配最长字符串,而非贪婪模式通过添加问号“?”实现最少匹配。文章提供具体代码案例,展示如何正确处理数字提取等场景,帮助开发者精准控制正则表达式的匹配行为。
本文深入解析Python中正则表达式的应用,涵盖字符匹配、预定义字符、数量限定及断言等核心语法。重点讲解re模块中compile、match、search、findall、split和sub六大常用方法,结合代码示例演示如何高效进行数据验证与字符串处理,帮助开发者掌握正则表达式在爬虫及数据处理中的实战技巧。
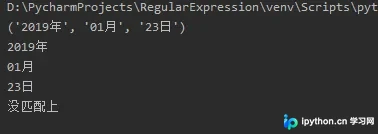
本文深入解析Python中正则表达式的贪婪与非贪婪模式。通过代码实例说明默认贪婪模式会匹配尽可能多的字符,而在量词后添加问号可启用非贪婪模式,匹配最少字符。文章结合源码分析,解释*?、+?等忽略优先量词的工作原理,帮助开发者准确控制正则匹配行为。
本文介绍如何利用Python的re模块,通过一行正则表达式代码高效过滤文本中的中英文标点符号及特殊字符。详细解析了\W匹配规则及自定义字符集的方法,提供完整代码示例与测试结果,帮助开发者快速实现文本清洗功能。
本文系统梳理Python中正则表达式模块re的核心用法。详细解析了re.I、re.S等修饰符及^、$、.等基础模式,深入讲解re.compile、re.match、re.search、re.split、re.findall、re.finditer和re.sub等关键函数的参数与返回值特性,结合代码示例说明分组捕获、非贪婪匹配及替换函数的实际应用,帮助开发者高效掌握正则处理技巧。
本文深入解析Python中re模块的核心用法,涵盖findall、match、search、finditer等匹配类方法,以及sub和split等修改类方法。详细讲解编译优化、大小写忽略、非贪婪匹配及括号分组机制,通过具体代码示例展示如何处理版本字符串、文本分割及复杂模式匹配,帮助开发者高效利用正则表达式进行文本处理。
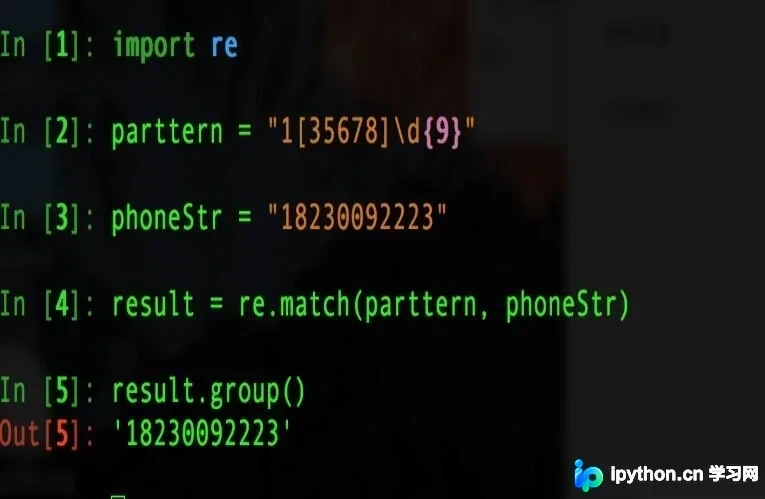
本文详细总结Python3中正则表达式模块re的核心用法。涵盖单字符与数量匹配规则、原始字符串raw在避免转义冲突中的应用、边界匹配技巧,以及分组、分组引用和命名分组的实战案例。通过手机号验证、数字范围匹配及HTML标签提取等示例,帮助开发者掌握正则表达式在爬虫与数据清洗中的关键技能。
本文详解Python中re模块的match()函数,通过百度视频网页源码实例,演示如何编写正则表达式提取电影名称与链接。涵盖文件读取、逐行匹配、分组提取及代码封装,帮助开发者掌握基础爬虫数据抓取技巧。
本文详细介绍Python中正则表达式的基本用法,涵盖元字符、字符集、数量词、贪婪模式及分组匹配等核心概念,并结合re模块函数进行实战演示。同时深入解析JSON数据交换格式,对比XML优势,讲解JSON字符串与对象的区别,以及Python中json模块的序列化与反序列化操作,帮助开发者掌握文本处理与数据交互的关键技术。