

Flask框架中单例模式的四种实现方式详解
本文详细解析在Flask框架下实现单例模式的四种方法:文件导入、类封装、__new__魔法方法及元类机制。重点对比了各方式在多线程环境下的表现,提供了支持线程安全的代码示例,帮助开发者根据实际需求选择最优方案。
2026-10-13
6

本文详细解析在Flask框架下实现单例模式的四种方法:文件导入、类封装、__new__魔法方法及元类机制。重点对比了各方式在多线程环境下的表现,提供了支持线程安全的代码示例,帮助开发者根据实际需求选择最优方案。
本文详细介绍如何使用Python的Tkinter库结合多线程技术实现一个图形界面倒计时工具。通过threading和Queue模块处理时间逻辑,避免界面卡顿,并展示了完整的代码实现与窗口交互细节,适合Python初学者参考学习。
本文详解Python中实现自定义超时异常的三种实用方案。首先介绍基于threading结合join()阻塞时间的线程超时机制,其次讲解Linux环境下利用signal.alarm()触发SIGALRM信号的方法,最后提供封装Thread类以获取函数返回值并捕获异常的完整实现。内容涵盖代码原理、执行流程及注意事项,帮助开发者灵活处理第三方接口调用或耗时操作中的超时问题。
本文深入探讨Python中多线程与多进程的数据共享差异。多线程下标准类型与自定义对象均共享同一内存ID,需注意线程安全;多进程间数据默认隔离,仅小整数可能复用ID。文章通过示例演示如何利用multiprocessing.managers.BaseManager实现跨进程对象共享,并介绍Value、Manager等标准库工具的使用场景与局限性。
本文详细介绍Python中如何利用threading和queue模块实现经典的生产者消费者模型。通过包子制作与食用的生动案例,演示线程间的数据传递与同步机制,解决资源等待与状态通知问题,帮助开发者掌握并发编程核心技巧。
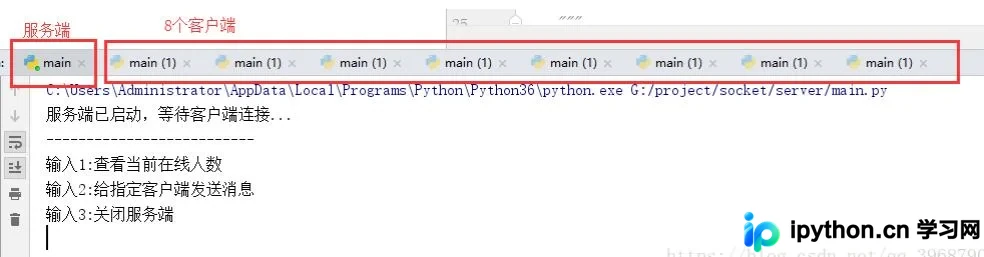
本文详细介绍如何使用Python的Socket和Threading模块构建支持多客户端连接的服务端程序。通过为每个新连接分配独立线程,实现异步消息接收与主动发送功能,并包含控制台交互命令以查看在线人数或向特定客户端发送消息。
本文深入解析 Python 多线程编程的关键概念。涵盖线程的两种创建方式、共享全局变量引发的数据竞争问题,以及使用互斥锁(Lock)解决并发冲突的方法。同时探讨死锁的成因与银行家算法、超时等待等解决方案,并重点剖析 GIL 对 Python 多线程性能的影响及其规避策略,帮助开发者理解 CPython 解释器的线程执行机制。
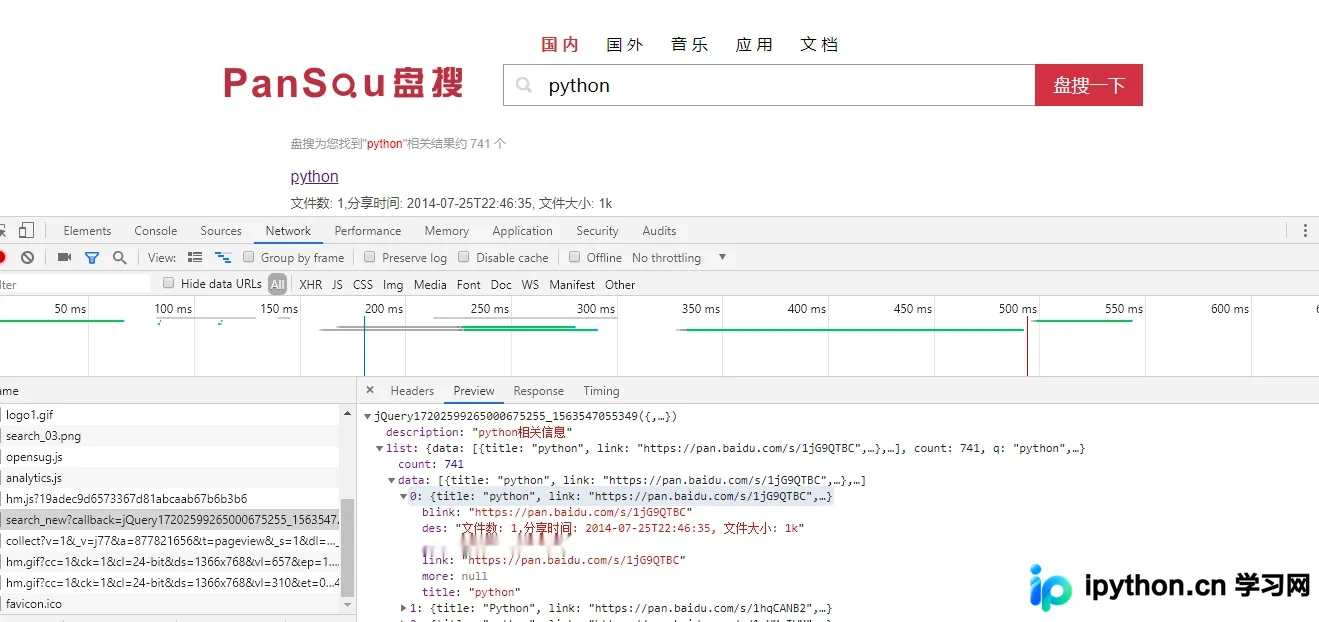
本文介绍如何使用Python编写爬虫,从盘搜网站筛选出有效的网盘链接。通过解析接口获取JSON数据,结合多线程技术提高爬取效率,并保存结果至CSV文件。代码包含详细的请求头设置、异常处理及文件写入逻辑,适合初学者练习网络爬虫开发。
本文介绍如何在Python中使用Tomorrow库简化多线程编程。通过@threads装饰器,开发者可以无需手动管理线程对象即可实现函数的异步并发执行。文中提供了完整的代码示例,展示了如何并发请求多个URL并计算总耗时,帮助读者快速掌握基于装饰器的并发处理技巧。
本文详解Python中多进程间共享数据的方法,包括使用Value共享数值、Array共享数组,以及通过Manager实现字典和列表的跨进程共享。同时简述多线程环境下全局变量的使用方式,帮助开发者解决进程间数据同步问题。
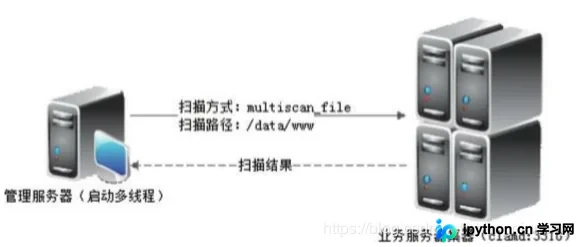
本文详解如何使用Python实现集中式病毒扫描管理。通过ClamdNetworkSocket建立与业务服务器的Socket连接,利用多线程技术对不同IP集群执行指定路径和模式的扫描。文章提供了完整的代码实现及无病毒和有病毒两种场景下的测试结果分析,帮助开发者掌握基于Clamd的自动化安全扫描方案。
本文深入解析 Python 中 time.sleep() 函数的底层机制。通过查看 CPython 源码及多线程测试代码,证实 time.sleep() 会释放 GIL 允许其他线程运行,即它睡眠的是当前线程而非整个进程。文章附带了验证该行为的 Python 示例代码及休眠函数的基本用法总结。