

Python使用ElementTree修改XML文件指定节点内容
本文介绍如何使用Python标准库xml.etree.ElementTree修改XML文件中的特定节点数据。通过解析XML文档、定位目标节点并更新文本内容,最后保存文件,实现高效的数据处理。
2026-10-15
7

本文介绍如何使用Python标准库xml.etree.ElementTree修改XML文件中的特定节点数据。通过解析XML文档、定位目标节点并更新文本内容,最后保存文件,实现高效的数据处理。
本文介绍Python项目中requirements.txt的作用及生成方法。对比了pip freeze(生成全量依赖,推荐配合虚拟环境使用)与pipreqs(仅扫描项目实际引用,更精准)两种工具。重点讲解pipreqs的安装与参数用法,并辨析setup.py与requirements.txt的共存关系,帮助开发者优化依赖管理流程。
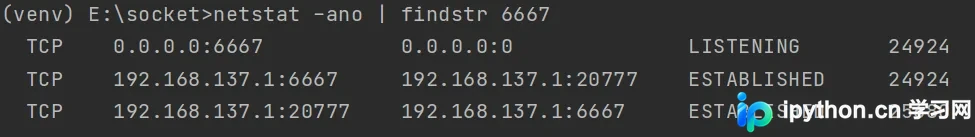
本文介绍基于Python Socket的TCP/IP网络通信基础,涵盖UTF-8与UTF-16编码的空间效率对比及适用场景。通过服务端与客户端代码示例,演示如何建立连接并执行远程系统命令,包括文件查看、目录管理及弹窗调用等具体操作,旨在提供技术层面的原理说明。
本文详细解析Python Pandas中DataFrame的索引机制,涵盖行索引与列索引的定义及自定义方法。重点介绍通过方括号、.loc()及.iloc()进行单列、多列及特定行数据的选取技巧,区分Series与DataFrame返回类型,帮助开发者高效处理表格数据。
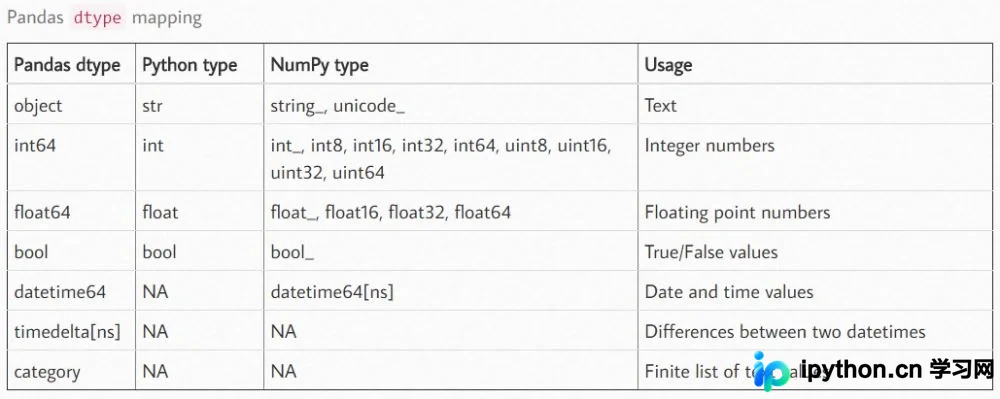
本文详细介绍Pandas中查看和转换数据类型的核心方法。通过df.dtypes、df.shape及df.info()快速获取数据框的维度、列名、非空计数及内存占用等关键信息。重点讲解df.astype()函数的多种用法,包括全局转换、指定列转换及索引类型转换,并深入解析object类型的特殊性及其清洗策略,帮助开发者高效处理数据格式问题。
本文详细解析Python中静态方法@staticmethod的定义与使用。静态方法既不需要访问实例属性也不需要访问类属性,通过@staticmethod装饰器定义,无需self或cls参数。可通过类名或实例对象调用,有助于减少内存占用并提升性能。文章包含多个代码示例,对比实例方法、类方法与静态方法的差异,帮助开发者合理封装逻辑。
本文系统整理了Python中Pandas库的45个高频实用命令,涵盖数据读取、类型转换、缺失值处理、时间序列分析及数据可视化等核心场景。通过具体代码示例,帮助开发者快速掌握高效处理大型数据集的方法,提升数据分析与建模效率。
本文详细解析NumPy中asarray函数的用法,包括输入数据、数据类型和存储顺序等参数。重点对比array、asarray和asanyarray在内存复制、子类处理及copy/subok参数下的行为差异,通过代码实例说明何时生成副本及何时共享内存。
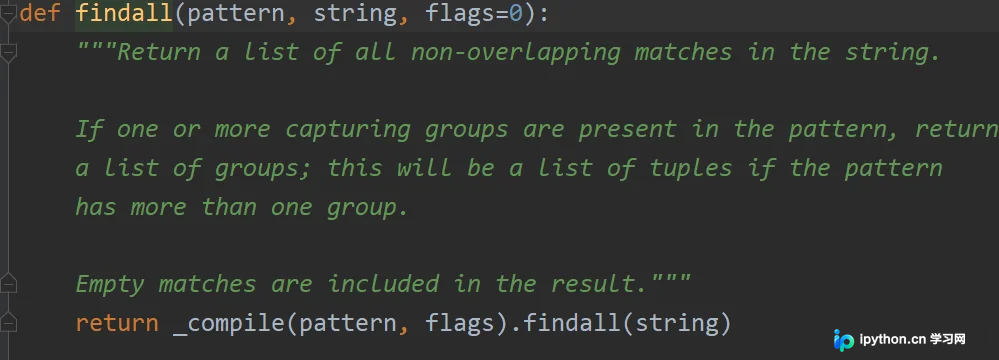
本文详细介绍Python中re模块的findall()函数用法。该函数用于在字符串中查找所有匹配正则表达式的子串,并返回包含所有匹配结果的列表。文章通过多个具体代码示例,演示了基础字符匹配、未找到结果的处理、复杂正则模式(如锚点、字符集、数字匹配及取反)的应用,以及结合requests库提取网页Title的实战场景。
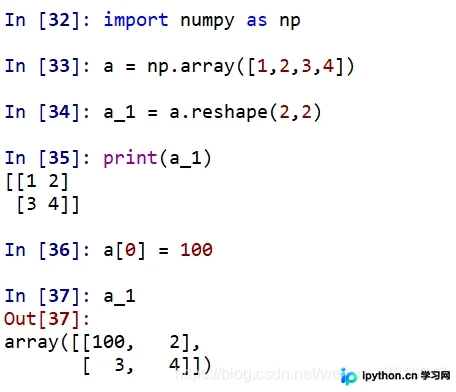
本文详细解析Numpy中shape与reshape函数的区别。shape用于获取数组维度信息,返回元组;reshape用于改变数组形状而不修改原始数据,要求元素总数不变且返回视图。文章涵盖一维至三维数组的shape解读及reshape的参数规则,适合Python初学者参考。
本文详细介绍Python中Fuzzywuzzy模块的使用方法,涵盖fuzz和process两大核心模块。通过fuzz.ratio、partial_ratio、token_sort_ratio及token_set_ratio等函数实现字符串相似度计算,并利用process.extract和extractOne从候选集中快速检索最相似文本,附带完整代码示例与参数说明。
本文详细解析numpy中reshape(-1,1)与reshape(1,-1)的具体用法。通过多个代码示例,说明当指定新数组shape为-1时,Numpy如何根据剩余维度自动计算。重点区分单特征数据使用reshape(-1,1)转为列向量,以及单样本数据使用reshape(1,-1)转为行向量的场景,帮助开发者准确处理数据维度。