基于Docker构建Python爬虫项目的完整部署流程
本文详细解析使用Docker部署Python爬虫项目的完整步骤。内容涵盖Docker环境安装、基础镜像拉取、Python运行环境编译、依赖库处理、Dockerfile编写规范、镜像构建命令及容器启动参数配置,帮助开发者实现爬虫项目的标准化与自动化部署。
2026-10-13
13

本文详细解析使用Docker部署Python爬虫项目的完整步骤。内容涵盖Docker环境安装、基础镜像拉取、Python运行环境编译、依赖库处理、Dockerfile编写规范、镜像构建命令及容器启动参数配置,帮助开发者实现爬虫项目的标准化与自动化部署。
本文详细解析Python中openpyxl模块的安装方法及核心用法。内容涵盖如何加载、创建和修改Excel文件,包括工作表与单元格的常用操作。通过具体代码示例,演示了如何对表格数据进行求和与平均数计算,以及如何将多个Excel文件合并为单一文件,适用于需要自动化处理.xlsx格式数据的开发场景。
本文介绍如何使用Python OpenCV库中的copyMakeBorder函数对图像进行边缘扩充。详细解析了BORDER_REPLICATE(复制边界)、BORDER_REFLECT(反射/轴对称)以及BORDER_CONSTANT(常数填充)三种常见填充模式的实现方法与参数配置,适用于模型训练前的数据预处理场景。
本文详解基于交并比(IoU)的目标检测模型性能评估方法。通过构建二值掩膜计算预测框与真实框的交集与并集,结合0、0.3、0.5、0.7等阈值统计正确检测与漏检数量,从而量化模型在不同严格度下的预测准确度。
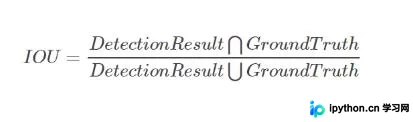
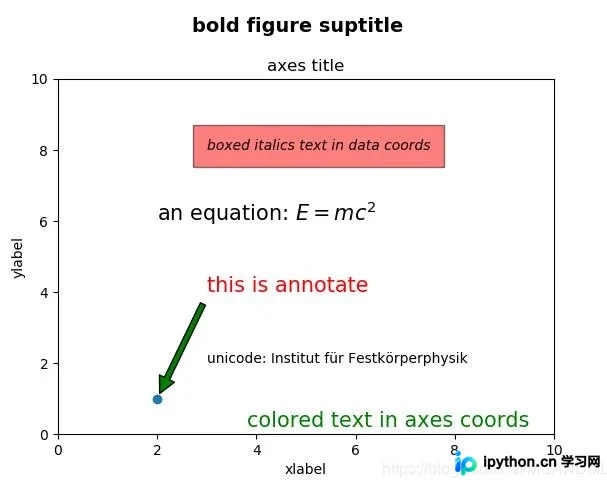
本文详细介绍Python中Matplotlib库的subplot子图绘制流程。涵盖从数据准备、画布创建、多种绘图方式(如plot、bar、scatter等)到图表定制(标题、标签、注释、图例)及保存显示的完整步骤。重点解析fig.add_subplot与plt.subplots()函数的参数用法,包括行列数、共享坐标轴及布局调整,并提供代码示例供参考。
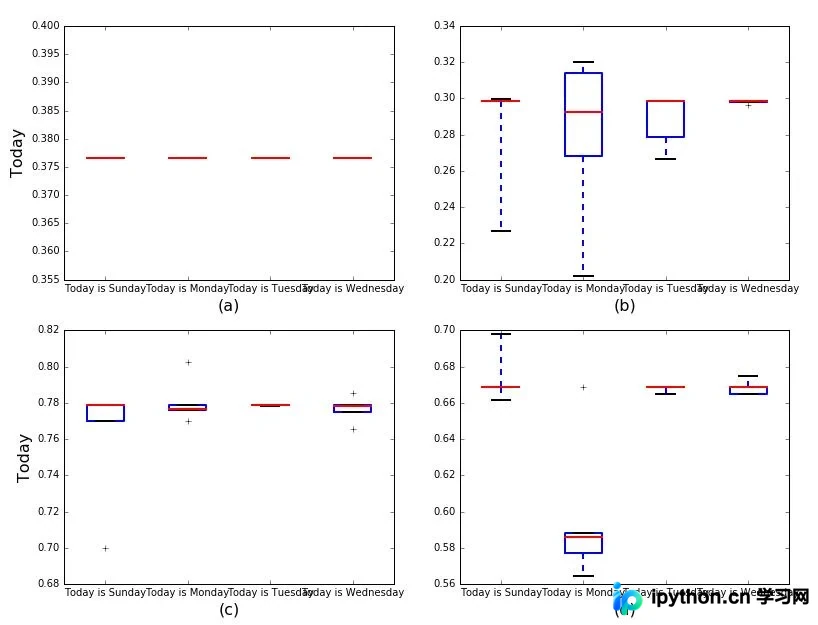
本文介绍在Python Matplotlib绘制箱线图和子图时,解决坐标轴标签重叠的三种实用方法。包括通过添加换行符实现多行显示、设置rotation参数使标签倾斜,以及使用plt.tight_layout()自动调整布局。适用于长标签导致的视觉混乱问题,帮助提升图表可读性。
本文详解Python Turtle库中控制颜色的三个核心方法:pencolor、fillcolor和color。介绍如何获取当前颜色,以及支持字符串、RGB元组和独立数值的四种输入格式。说明colormode对数值范围的影响,并展示多边形轮廓与填充颜色的实际应用示例。
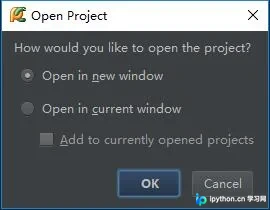
本文详细解析在PyCharm中同时处理多个Python项目的操作技巧。针对新建项目时“Open in new window”与“Open in current window”导致的工程切换繁琐问题,提供了通过Settings配置Project Structure并添加Content Root的解决方案,实现项目A与项目B在同一窗口内的共存与便捷切换。
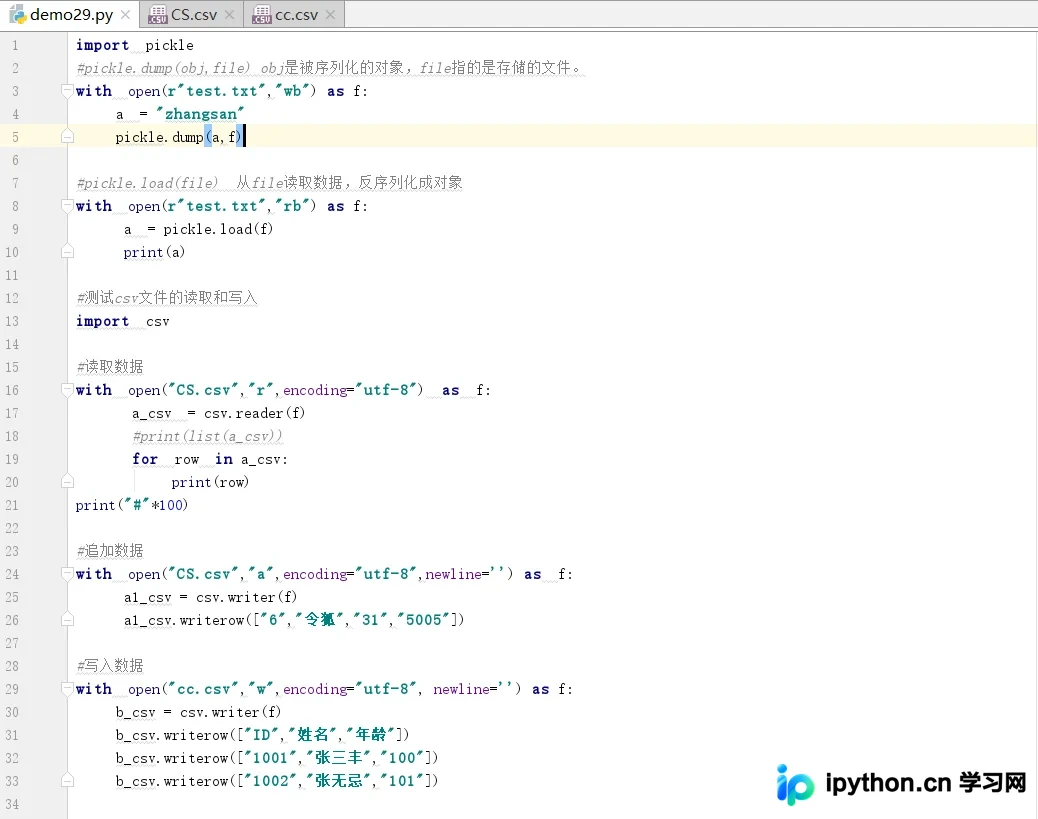
本文详解Python中的序列化机制,重点介绍pickle模块实现对象持久化的方法。同时对比CSV与Excel文件的差异,阐明CSV仅支持字符串数据、无样式及多表等限制,帮助开发者正确使用CSV进行数据存储与读取。
本文详细解析Python中文件打开的三种基础模式(r, w, a)及其组合模式(r+, w+, a+)。重点说明各模式下文件指针的初始位置、读写权限及数据覆盖行为。特别是a+模式下读取为空的原因(指针在末尾),w+模式需seek(0)才能读取已写内容,以及r+模式读写时的字符覆盖机制。附带二进制模式说明及完整代码示例,帮助开发者避免文件操作中的常见错误。
本文提供使用Python脚本从本地文件读取数据的完整代码实例。通过展示如何切换目录、打开文件对象,并利用for循环遍历每一行内容,详细讲解了文件读取的基本流程。同时补充了使用readline()方法进行逐行读取的替代方案,帮助开发者掌握文件操作的核心技巧,适用于Python初学者及需要处理本地数据文件的场景。
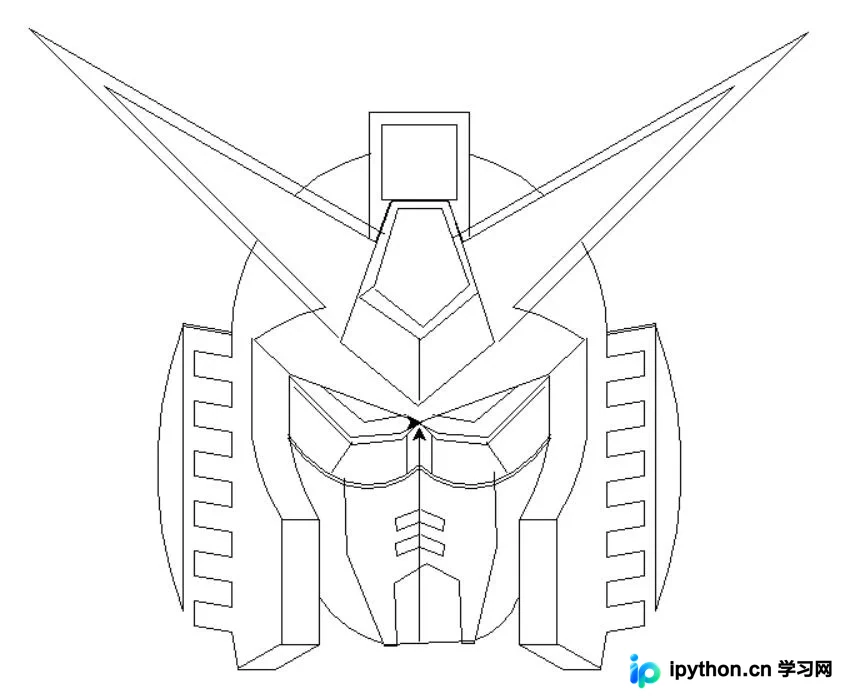
本文提供了一段使用Python turtle库绘制高达模型的完整代码示例。通过控制画笔的移动、转向和几何图形绘制,实现了高达的基本轮廓。代码包含详细的坐标定位与路径指令,适合Python初学者参考学习。