Jupyter Lab文件导出与下载实用指南
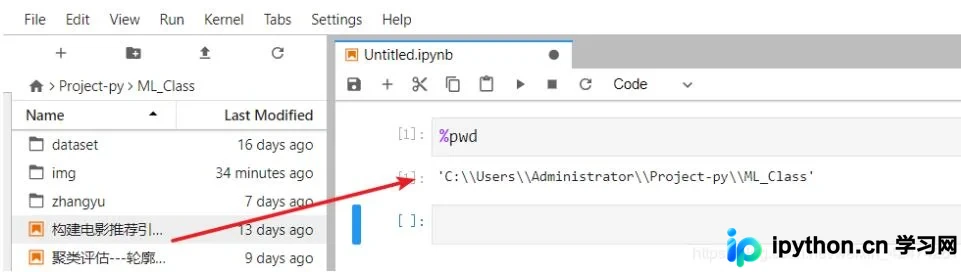
本文介绍Jupyter Lab中文件导出的两种常用方式。首先通过%pwd命令定位实际工作目录,理解其与磁盘文件的同步关系。接着详解直接复制文件以及利用浏览器右键菜单中的“在新标签页打开”或“复制下载链接”功能实现下载的操作步骤,帮助开发者高效管理Notebook文件。
2026-10-13
8

本文介绍Jupyter Lab中文件导出的两种常用方式。首先通过%pwd命令定位实际工作目录,理解其与磁盘文件的同步关系。接着详解直接复制文件以及利用浏览器右键菜单中的“在新标签页打开”或“复制下载链接”功能实现下载的操作步骤,帮助开发者高效管理Notebook文件。
本文提供使用Python和Tkinter库开发扑克牌交互式发牌程序的完整代码示例。程序包含扑克牌类、手牌类及牌堆类的定义,实现了54张牌的生成、随机洗牌及按轮次发牌逻辑。界面通过Canvas绘制四位玩家的手牌区域,并集成“重新发牌”按钮功能,支持用户通过图形界面进行发牌操作。
本文详细介绍Python中os.path模块处理文件路径的核心函数。通过splitdrive获取盘符,split和dirname分离目录与文件名,basename提取文件名,splitext分离扩展名。此外,结合rfind与切片操作实现自定义路径片段提取,并利用join合并路径,提供完整的路径解析解决方案。
本文详细介绍Numpy库中一维线性插值函数numpy.interp的用法。涵盖xp、fp、left、right及period等关键参数的定义与作用,通过插入点在内、外及正弦波周期插值三个具体代码示例,演示如何获取离散数据的分段线性插值结果,帮助开发者掌握该函数的实际应用场景。
本文详解Python中Pandas库的数据重采样与频率转换技术。通过resample结合asfreq实现按月、日等自定义频率的下采样,并演示asfreq的pad前向填充用法。同时介绍线性插值interpolate及前后向填充bfill/pad处理缺失值的方法,结合代码示例展示时间序列数据的变频与插值实际操作。
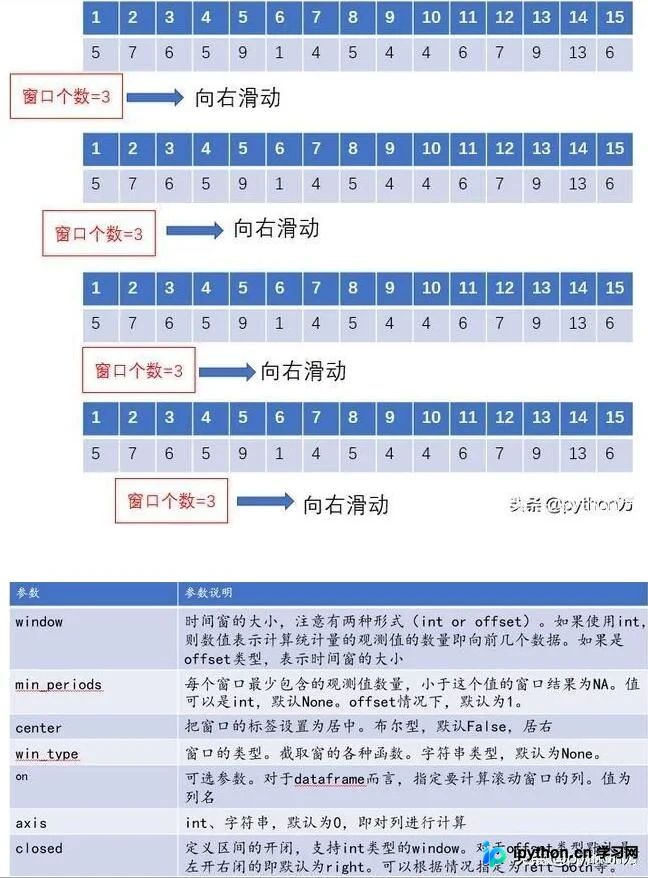
本文详细解析pandas中read_csv、rolling和expanding三个核心函数的用法。涵盖read_csv的header、index_col及usecols参数配置;深入讲解rolling滑动窗口的min_periods参数控制机制;以及expanding扩展窗口处理历史数据的方法。通过具体代码示例,帮助开发者掌握时间序列与数据窗口分析技巧。
本文介绍在Jupyter Notebook中处理大量输出时的两种折叠方法。通过鼠标双击单元格左侧灰色区域,或使用Esc后按O键,即可快速折叠输出以显示更多代码。同时附带展开操作说明及Python查找数组高频元素的代码实例,帮助提升编码效率。
本文详解Pandas中read_csv读取CSV文件时常见的两类错误:因字段数不匹配导致的ParserError及KeyError。通过设置error_bad_lines=False跳过异常行,并区分Series与DataFrame赋值差异,提供针对EOF字符串错误及类型比较错误的实用解决方案。
本文详细记录并解决Django执行数据库迁移时遇到的常见错误,包括表已存在、外键约束导致的删除失败以及迁移状态不一致等问题。通过实战演示,提供了从关闭外键检查、手动清理数据到重置迁移文件及重新配置数据库连接的完整排查步骤,帮助开发者快速恢复Django项目的数据库迁移功能。
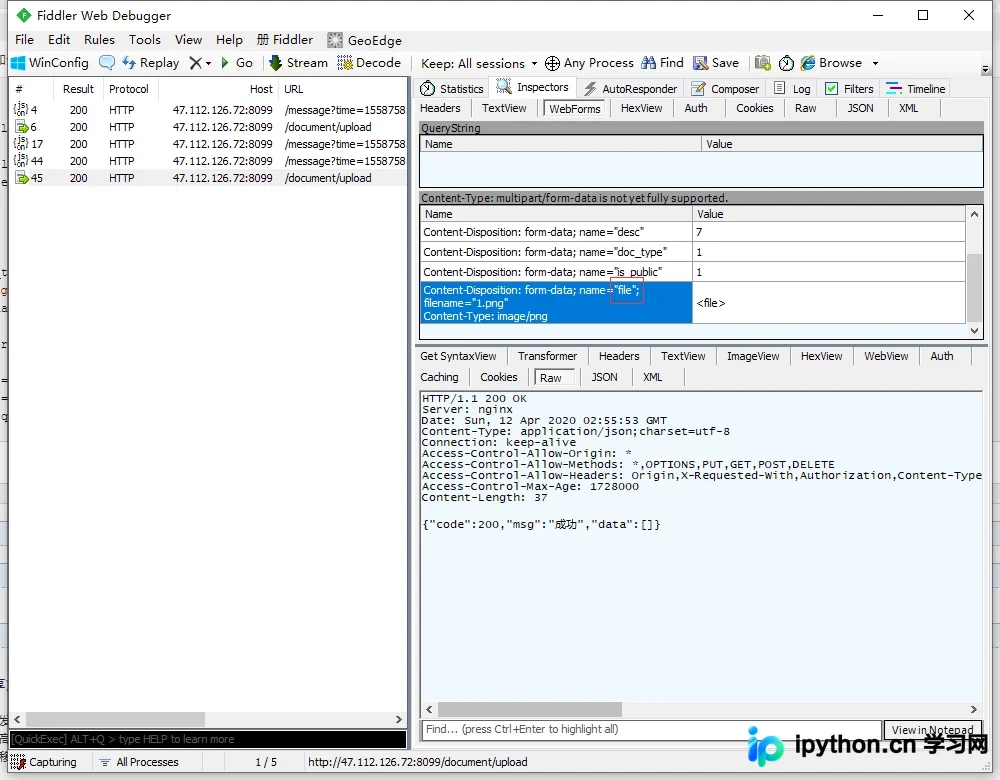
本文详细介绍Python中使用requests库进行文件上传的两种实现方式。方法一利用requests_toolbelt库的MultipartEncoder处理复杂表单数据,需手动转换参数类型并设置Content-Type;方法二直接使用原生requests,通过data和files参数分别传递附加信息与文件,无需额外依赖。文章包含完整代码示例及常见错误处理,适用于CRM接口测试等场景。
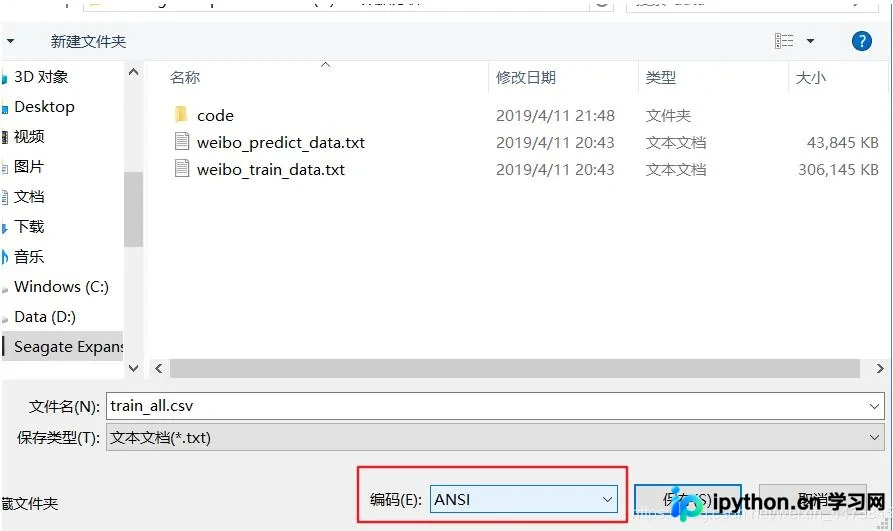
本文介绍在Jupyter Notebook中使用pandas导入CSV文件的方法,重点解决因文件编码非UTF-8导致的UnicodeDecodeError错误。提供两种解决方案:通过记事本将文件另存为UTF-8编码,或在pd.read_csv()中指定encoding参数(如gbk)以正确读取数据。
本文介绍如何在TensorFlow中指定CPU与GPU运算。通过device语句明确指派设备,利用ConfigProto配置日志与软放置。详解GPU资源分配策略,包括按需增长(allow_growth)与固定比例(per_process_gpu_memory_fraction),确保显存高效利用。