Python实现Hive中Lateral View Explode功能的示例
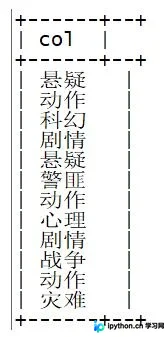
本文介绍如何在Python中实现Hive中类似lateral view explode的功能,将包含多个标签的字符串拆分为多行数据。通过具体示例展示Hive SQL与Python代码的实现方式,并补充相关理论知识,帮助读者理解列转行的数据处理方法。
2026-10-13
8

本文介绍如何在Python中实现Hive中类似lateral view explode的功能,将包含多个标签的字符串拆分为多行数据。通过具体示例展示Hive SQL与Python代码的实现方式,并补充相关理论知识,帮助读者理解列转行的数据处理方法。
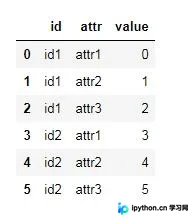
本文介绍如何在Python中使用Pandas库实现数据框的长格式与宽格式相互转换。通过stack和unstack方法,可将键值对形式的堆叠数据重塑为宽表,反之亦然。文章提供完整代码示例,涵盖从CSV读取、PeriodIndex构建到最终pivot和unstack操作的全过程,帮助开发者处理数据库交互中的常见数据结构转换需求。
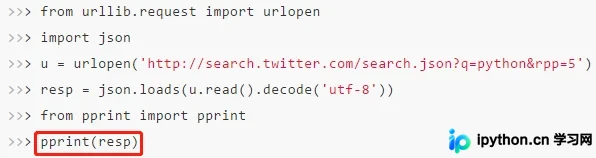
本文详解Python中json模块的使用,涵盖dumps和loads函数的基本用法,演示如何将Python数据结构转换为JSON字符串及反向解析。内容还包括使用indent参数美化输出、处理非标准数据类型、通过object_hook自定义解码逻辑,以及实现对象实例的序列化方法,帮助开发者高效处理JSON数据。
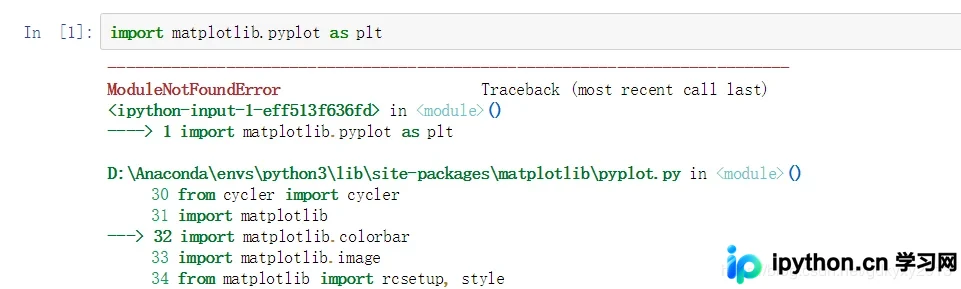
本文详细介绍如何解决Jupyter Notebook内核指向的Python路径与CMD命令行环境不一致的问题。通过对比sys.executable输出,定位并修改kernel.json文件中的解释器路径,确保Jupyter Notebook使用正确的Anaconda虚拟环境Python版本,从而解决库调用错误。
在Python开发中,简单的print打印无法提供足够的调试信息。本文介绍了利用logging.exception以及traceback模块(如print_exc、format_exc等)和sys.exc_info()获取完整异常堆栈信息的方法,帮助开发者快速定位代码错误位置。
本文探讨在Python程序打包为exe时,try-finally结构中异常信息未正常显示的问题。分析发现这是由于标准输出非异步导致堆栈信息延迟打印。通过引入traceback库并调整代码顺序,可确保异常堆栈被正确捕获和输出,解决“死掉后”不报错的现象。
本文深入解析Django ORM中F对象的核心用法。通过实例演示如何利用F对象进行字段值的原子加减、比较及乘积排序,避免内存读写开销。同时涵盖常规排序、随机排序及关联表字段排序等多种场景,提供高效的数据查询方案。
本文详细介绍如何在Python中使用Pandas进行分组求和与分组累加求和,涵盖groupby、count、cumsum及merge等关键操作。同时解析Django中利用aggregate与annotate函数对数据库字段进行条件求和的正确姿势,对比两种实现方式的输出差异,帮助开发者准确获取统计结果。
本文介绍在Django ORM中如何实现非主键字段的自增功能。通过设置IntegerField并配置auto_created=True,结合数据库层面的AUTO_INCREMENT属性,可实现唯一自增。同时对比了默认自增ID与自定义ID的区别,提供具体代码示例及注意事项。
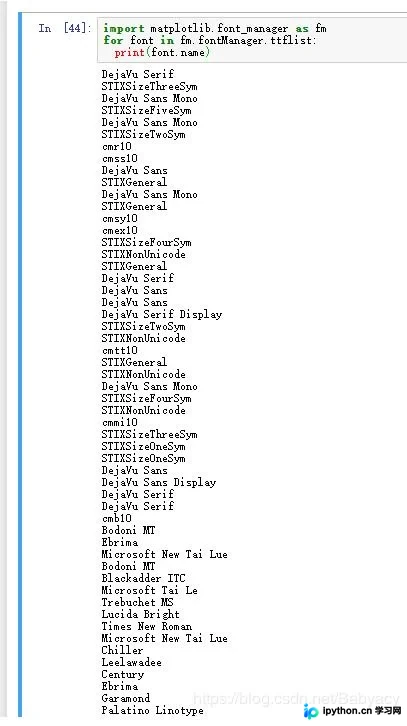
本文详解如何在Python Docker镜像中安装中文字体以解决中文显示乱码问题。通过修改Dockerfile使用apt-get安装字体支持库,并复制字体文件至指定目录,最后执行fc-cache更新缓存。同时提供在本地Python环境中查询和设置中文字体的方法,如使用SimHei黑体,确保跨平台开发环境的一致性。
本文详细记录了Django项目中向MySQL写入中文字符报错的解决方案。主要步骤包括修改MySQL配置文件my.cnf设置utf8字符集,验证字符集变量,以及关键的重建数据库操作。通过新建数据库并执行makemigrations和migrate命令,确保表结构支持中文,从而彻底解决写入错误问题。
本文记录在Anaconda3环境下为Jupyter Notebook安装Table of Contents插件时遇到的conda和pip源超时问题,并提供了通过GitHub下载tar.gz包并使用setup.py手动安装的成功方案,最终实现笔记目录与标题折叠功能。