

Python中导入train_test_split报错的解决方法
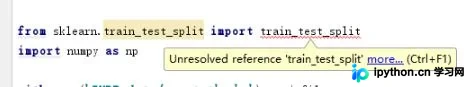
本文介绍在Python中使用sklearn时导入train_test_split报错的解决方案。主要原因为模块位置变更,需从model_selection导入。同时提供解决模块找不到的pip安装命令及处理Windows权限拒绝错误的建议。
2026-10-14
7

本文介绍在Python中使用sklearn时导入train_test_split报错的解决方案。主要原因为模块位置变更,需从model_selection导入。同时提供解决模块找不到的pip安装命令及处理Windows权限拒绝错误的建议。
本文详细介绍如何判断Python模块是否安装成功。通过尝试import模块名,若无报错则说明安装正常;对于numpy等复杂模块,建议使用官方测试函数检查编译完整性。此外,还演示了利用python -v命令结合具体模块名来定位模块安装路径的方法,帮助开发者快速排查环境问题。
Python语法上支持多继承,但官方不推荐使用。本文解析多继承中同名方法的“遮蔽”现象:子类继承多个父类时,定义在继承列表左侧的父类方法会覆盖右侧同名方法。通过代码示例展示优先级规则,并说明为何单继承能保持逻辑清晰。
本文深入解析Python中Numpy库的核心功能,涵盖ndarray对象的创建、数据类型管理及内存优化。详细演示了从列表生成、arange到文件读写的全流程,重点讲解切片、掩码及高级索引技巧,并介绍矩阵运算、统计分析及形状变换等实用操作,助力高效处理科学计算数据。
本文深入解析 Python 中的继承机制,涵盖接口与实现继承的区别、单继承与方法重写原理,以及多继承中的 MRO 和钻石继承问题。重点讲解 super() 方法在解决多继承初始化重复调用中的应用,结合代码示例阐明类属性检索与实例化过程,帮助开发者掌握 Python 面向对象设计的核心概念。
Python常被误认为纯解释型语言,实则CPython在执行前会将源代码编译为与平台无关的字节码(.pyc文件)。本文解析Python解释器中编译器与虚拟机的分工,阐明“编译生成中间代码+虚拟机逐行解释”的双重机制,并对比传统编译型与解释型语言的效率差异,帮助开发者理解Python程序的底层执行逻辑。
本文详解Python中字典(Dictionary)的排序方法。由于字典默认无序,文章介绍了利用sort和sorted函数对字典项进行排序的技巧。重点演示了如何按Key值和Value值分别排序,包括使用lambda表达式、tuple交换及列表推导式等多种代码实现,帮助开发者灵活处理数据输出顺序。
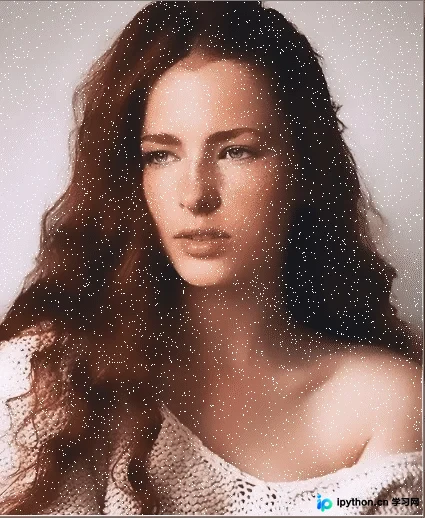
本文详细介绍Python中OpenCV库的四种图像平滑算法:均值滤波、方框滤波、高斯滤波和中值滤波。通过具体代码示例与参数解析,演示如何添加噪声并应用不同核大小进行去噪处理,对比各算法在保留边界信息与消除模糊方面的效果差异,帮助开发者掌握图像预处理的核心技术。
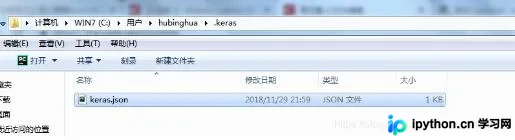
本文介绍如何在Keras中实现Theano与TensorFlow后端训练模型的相互转换。由于两者卷积实现机制不同,需通过特定脚本对卷积层权重进行翻转处理。文章提供了完整的Python转换代码及配置文件修改方法,帮助用户解决跨后端模型迁移时的兼容性问题。
本文深入解析Python中空值的表示方法,重点阐述None作为特殊空值的含义及其与0的区别。通过介绍对象、类与数据类型的关系,说明NoneType的特性,并列举空列表、字典等转换为False的规则,最后演示如何使用any()函数判断空类型,帮助开发者准确处理Python中的空值场景。
Python因语法简洁、接近自然语言而成为编程入门首选。本文解析其六大核心优势:定义优雅简单、第三方库丰富提升开发效率、无需管理内存的高级语言特性、跨平台可移植性、支持C/C++扩展的高可扩展性以及嵌入C/C++的可嵌入性。结合TensorFlow等AI框架及在爬虫、大数据领域的广泛应用,展现其广阔的发展前景。
本文深入解析Python字符串驻留机制,探讨其通过interned字典实现内存共享的原理。详细列举了自动驻留的时机,包括短字符串、编译时优化及特定字符规则。同时分析了驻留在提升比较效率(O(1))与增加创建开销之间的权衡,帮助开发者理解如何利用该机制优化代码性能。