Python自动化办公实战:批量整理文件与文档处理指南
本文介绍如何利用Python内置库及第三方工具实现日常办公自动化。通过os与shutil批量分类移动文件,使用openpyxl和docx读写Excel与Word数据,结合smtplib发送标准化邮件、PyPDF2合并文档以及PIL进行图像尺寸调整与滤镜处理。提供完整可运行的代码片段,帮助办公人员减少重复劳动,提升数据处理效率。
2026-10-12
26

本文介绍如何利用Python内置库及第三方工具实现日常办公自动化。通过os与shutil批量分类移动文件,使用openpyxl和docx读写Excel与Word数据,结合smtplib发送标准化邮件、PyPDF2合并文档以及PIL进行图像尺寸调整与滤镜处理。提供完整可运行的代码片段,帮助办公人员减少重复劳动,提升数据处理效率。
针对Python脚本运行耗时较长的问题,本文通过实测数据梳理了9项核心优化方案。涵盖字符串与集合的数据结构选型、推导式替代传统循环、利用缓存装饰器消除重复计算、调整作用域以加快局部变量检索,以及延迟加载重型模块。合理应用这些底层机制可显著降低CPU开销并缩短启动时间。
本文详细讲解在Python中实现定时任务的四种主流方案,涵盖内置time/datetime模块的轻量轮询、schedule库的简单周期调度、APScheduler的复杂Crontab触发,以及基于asyncio的异步定时执行。附带完整代码示例与异常处理逻辑,帮助开发者根据业务复杂度快速选型并稳定运行自动化脚本。
针对重复计算导致的高耗时问题,Python 标准库提供的 functools.lru_cache 装饰器通过最近最少使用(LRU)策略自动记录函数调用结果。本文详细拆解参数配置、元数据查看及自定义键值的方法,结合递归数列示例演示如何通过内存换时间实现性能跃升,并明确适用边界。
在Windows环境下使用pip安装Python库时,若遇到“Windows Error 5: Access is denied”报错,通常是因为目标文件被其他进程占用或权限不足。本文介绍通过关闭相关编辑器、结束占用进程以及谨慎删除冲突文件来解决问题的具体操作步骤,并提醒操作前务必备份数据以防丢失。
本文详细介绍如何在Python中利用pypyodbc模块连接并操作Access数据库。内容涵盖pypyodbc的安装方法、Windows系统下ODBC数据源的配置步骤,以及使用win_connect_mdb进行数据库连接、游标创建、SQL查询执行和结果遍历的完整代码示例。
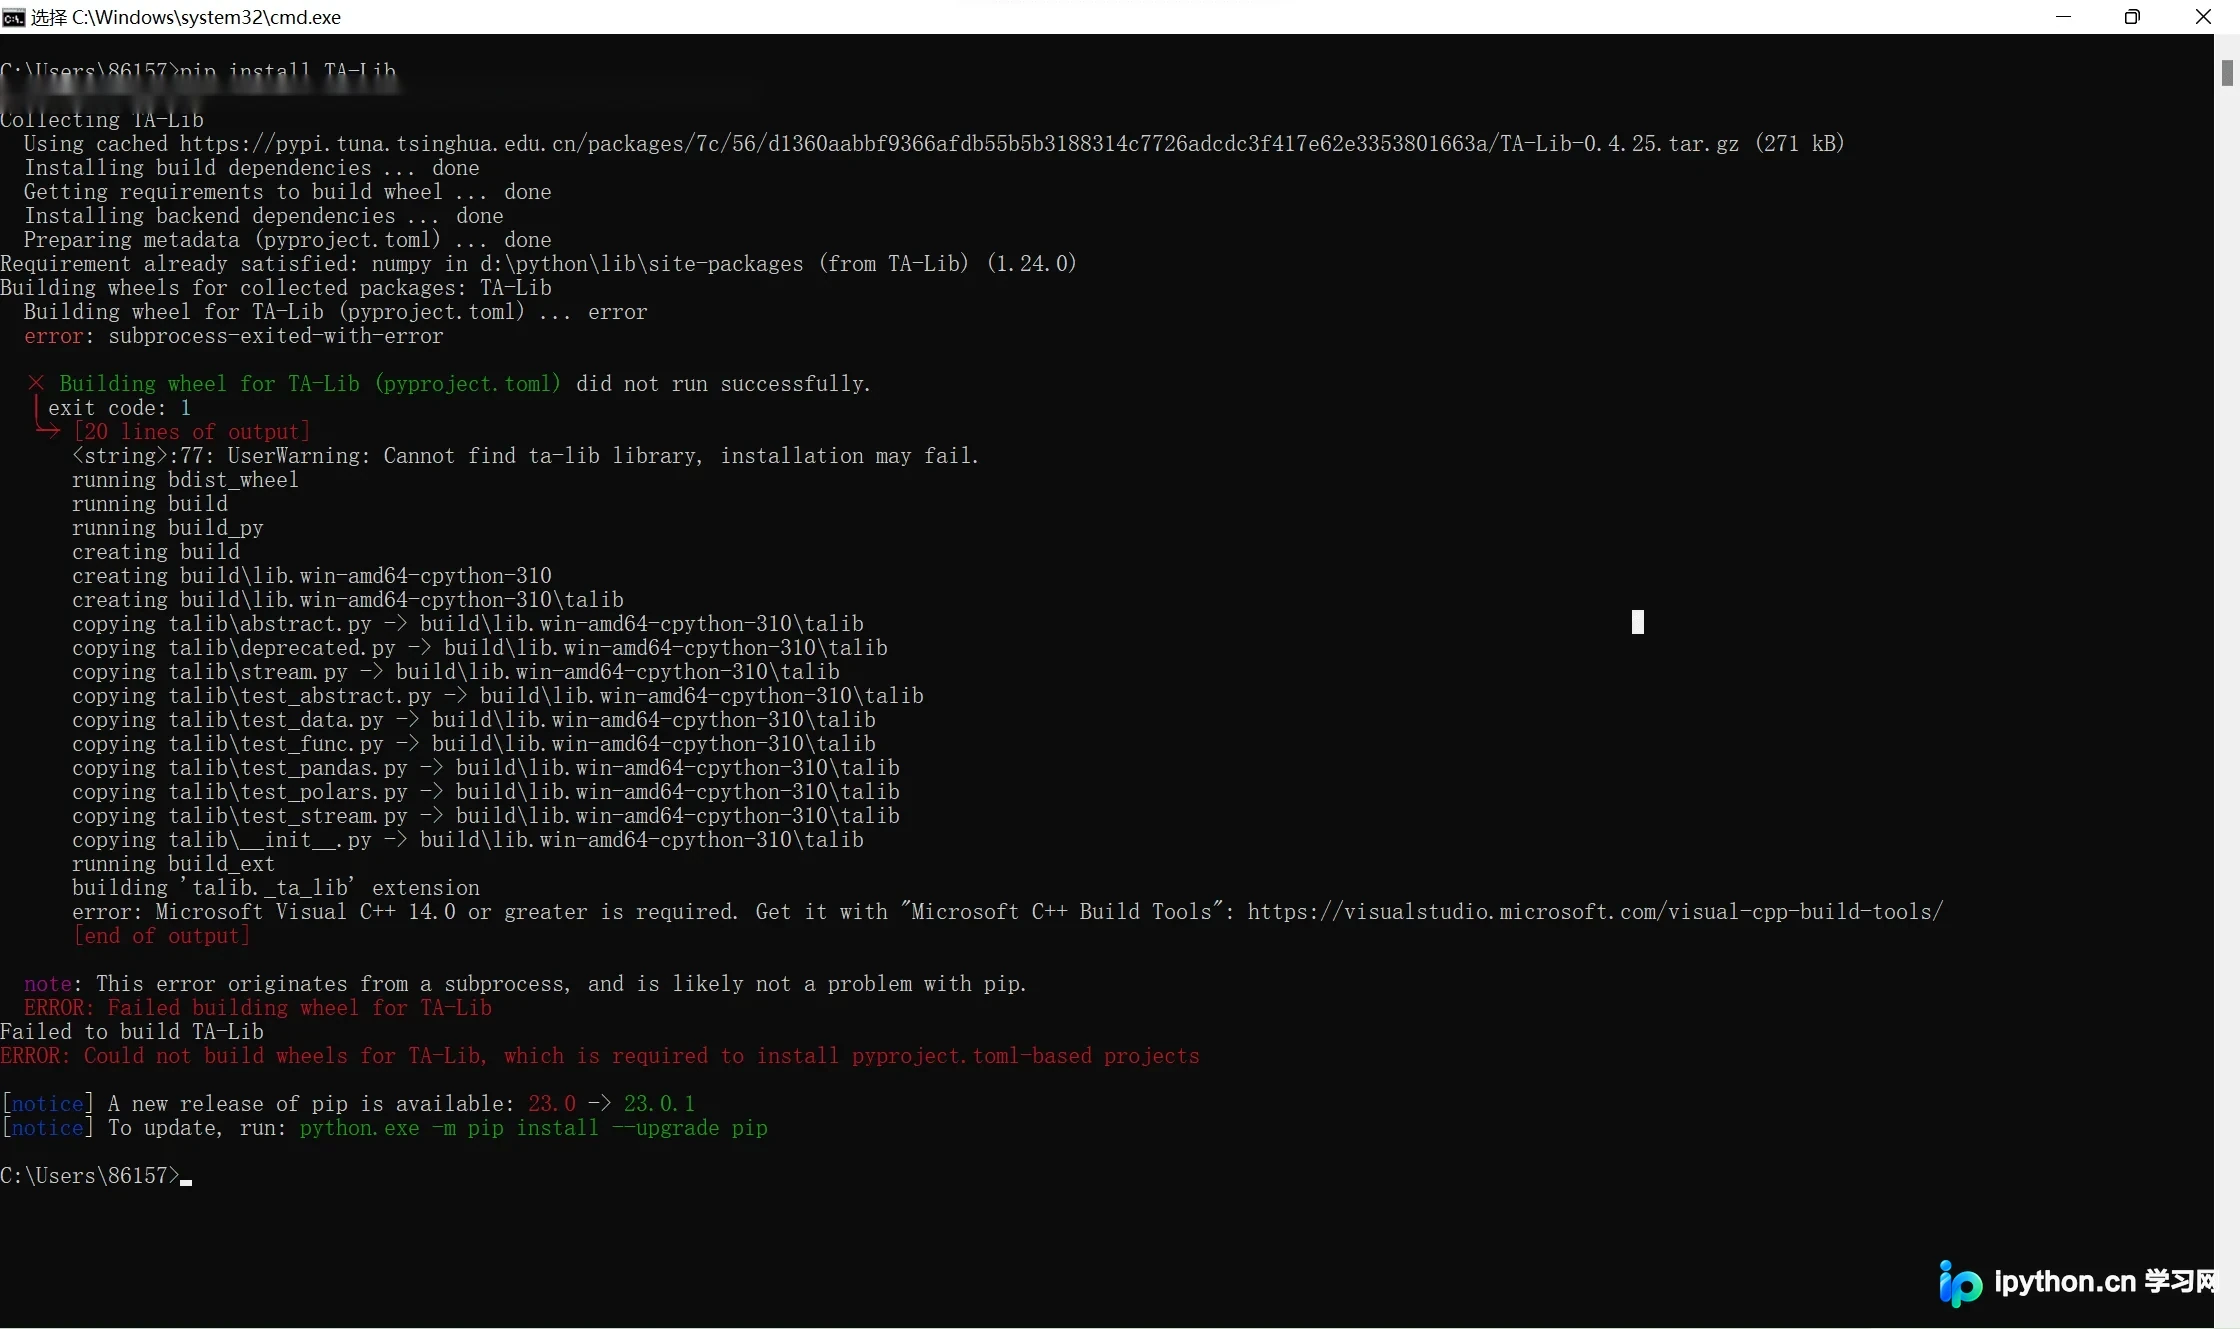
针对使用pip install TA-Lib时出现“Could not build wheels”导致安装中断的问题,本文提供基于预编译whl文件的快速解决路径。通过精准匹配Python版本与系统架构下载离线安装包,放置于Python环境的Scripts目录中执行指令,可跳过C语言底层依赖编译环节,顺利完成TA-Lib金融计算库的本地部署。
在Python开发中,字典的Key为None时,命令行交互可直接取值,但脚本中直接访问会触发KeyError。本文分析该差异原因,并提供通过遍历字典安全获取None对应Value的解决方案,帮助开发者避免脚本运行异常。
在数据处理中,直接将 NaN 替换为 0 往往是不合理的策略,特别是对于如开氏温度等物理量。本文介绍如何利用 NumPy 的矩阵操作,按列计算非 NaN 值的均值,并以此填充矩阵中的缺失值,从而更科学地处理数据缺失问题。
本文介绍如何使用 Python 批量读取指定目录下的 TXT 文件,并通过 linecache 模块提取特定行数据,经过字符串处理后转换为 CSV 格式。文章提供了完整的代码示例,涵盖文件遍历、行读取、数据清洗及文件写入等关键步骤。
解析Python函数中形参与实参的区别与绑定机制,通过位置参数、默认参数、关键字参数及可变参数的代码示例,演示实际传参方式与执行结果,帮助开发者规范函数定义并避免类型或数量匹配错误。
本文介绍了数据科学领域最核心的三个Python库:NumPy、Pandas和Matplotlib。NumPy提供高效的多维数组计算能力;Pandas通过DataFrame处理结构化数据;Matplotlib则负责生成各类可视化图表。文章包含具体的代码示例,展示了如何创建数据框并绘制条形图,帮助开发者快速上手Python数据分析。