Python实现简易商城购物车功能完整示例
本文分享一个基于Python的简易商城购物车代码实例。程序通过列表存储商品清单,接收用户输入的工资金额,支持循环选购商品并实时计算余额。代码包含输入合法性校验、余额不足提示及退出打印购物清单功能,并演示了终端彩色输出用法,适合Python初学者参考学习。
2026-10-13
23

本文分享一个基于Python的简易商城购物车代码实例。程序通过列表存储商品清单,接收用户输入的工资金额,支持循环选购商品并实时计算余额。代码包含输入合法性校验、余额不足提示及退出打印购物清单功能,并演示了终端彩色输出用法,适合Python初学者参考学习。
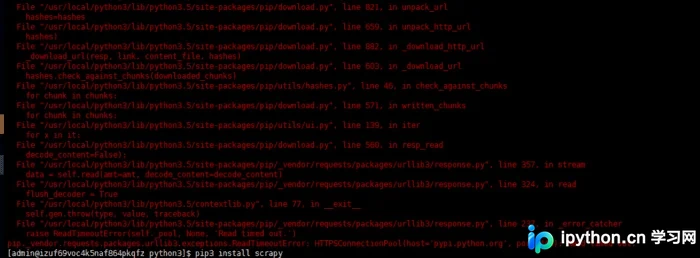
本文详细介绍在 CentOS 7 系统中编译安装 Python 3.5.5 及 Scrapy 框架的完整步骤。内容涵盖开发工具依赖安装、Python 源码编译、软链接配置以及 Scrapy 的安装与验证,确保在不破坏系统原有 Python 2.7 的前提下完成环境搭建。
本文详解Python读取.docx文件正文信息的原理。.docx本质是包含XML的ZIP压缩包,正文存储于word/document.xml中。通过Python解压文件并解析该XML,可提取文本内容。文中提供基于ZipFile和BeautifulSoup的完整代码示例,展示如何遍历并打印文档正文。
本文介绍如何利用Python标准库itertools模块高效解决列表元素的排列与组合问题。通过test_func1、test_func11、test_func2及test_func22四个函数,分别演示了元素不重复排列、元素可重复排列、元素不重复组合及元素可重复组合的具体实现与结果统计,适用于需要快速生成全排列或组合场景的开发需求。
本文介绍利用Python标准库collections模块中的Counter类,高效找出序列中出现次数最多的元素。通过most_common()方法获取高频项,支持手动更新或使用update()方法增加计数,并可执行数学运算合并或减去计数器。相比手写字典算法,Counter是处理数据制表与计数的得力工具。
本文介绍如何使用Python脚本在命令行环境下将Word文档转换为PDF格式。通过调用Office 2007 SP2引入的ExportAsFixedFormat接口,可确保转换后的PDF保留原文档的书签和超链接。文章提供了完整的Python代码示例,并强调了使用绝对路径及安装必要依赖(如pywin32)的重要性,适用于自动化构建流程中的文档格式转换需求。
本文介绍如何使用Python的PIL库在Flask后端生成随机图片验证码,并通过前端JavaScript实现点击刷新与表单提交验证。代码涵盖验证码类定义、路由配置及HTML交互逻辑,提供完整源码参考,适用于Web应用的安全注册或登录场景。
本文详细介绍Python中format()函数的多种用法,涵盖通过位置索引和关键字传递参数、字典解包、字符串对齐与填充、指定精度以及进制转换等核心功能,帮助开发者掌握高效的字符串格式化技巧。
本文介绍如何利用Python标准库zipfile,通过指定'a'(追加)模式,将新文件或文件夹内容添加到现有的ZIP文件中。核心在于遍历源目录并递归写入,适用于需要增量更新压缩包而不覆盖原有内容的场景。
本文介绍利用Python批量提取PDF文件中文本的方法。首先通过pip install pdfminer3k安装扩展库,随后使用内置的pdf2txt.py命令行工具处理PDF。脚本自动重命名含特殊字符的文件,调用转换命令并输出前200个字符。适用于需要批量处理PDF文档的场景,支持简单密码处理逻辑。
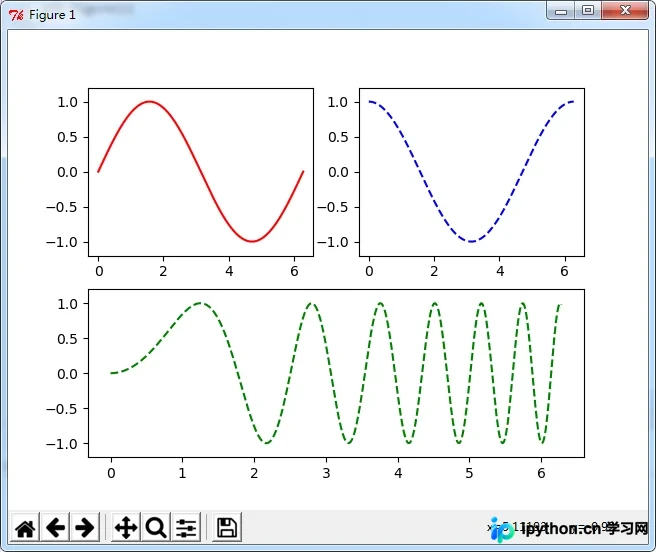
本文介绍利用Python matplotlib库实现多个图形单独显示的具体方法。通过导入numpy和matplotlib.pyplot,创建自变量数组及不同函数值数组,使用plt.figure和plt.subplot构建2行2列的子图布局。代码演示了如何在不同子图中分别绘制红色、蓝色及绿色曲线,并通过plt.sca选择当前坐标轴,利用plt.ylim限制y轴范围,最终实现多图形独立展示效果。
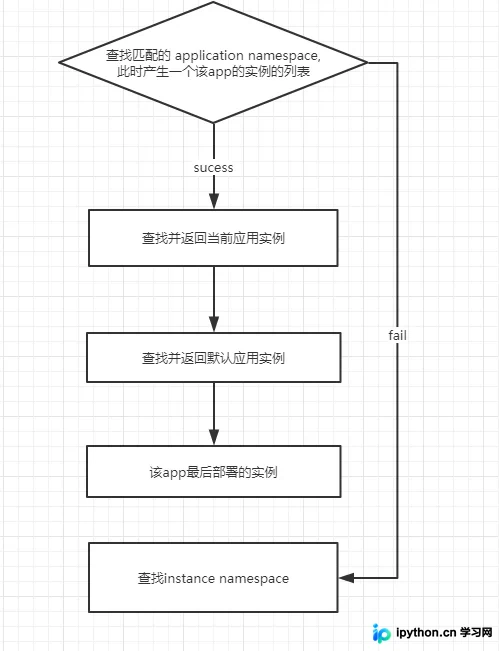
本文详解Django中URL反向解析的命名空间机制,区分application namespace与instance namespace。通过polls示例展示reverse()函数结合current_app参数的使用,说明如何根据当前实例或默认实例正确解析URL,适用于Django 2.0及以上版本。