Python使用Pandas进行Excel风格多列排序详解
本文详细介绍如何利用Python的Pandas库实现类似Excel的强大排序功能。通过df.sort_values()方法,演示如何对单列或多列数据进行升序或降序排列,并深入讲解当存在相同值时如何处理索引排序,以及如何通过列表参数实现不同列混合排序(如身高降序、武力升序)。
2026-10-13
18

本文详细介绍如何利用Python的Pandas库实现类似Excel的强大排序功能。通过df.sort_values()方法,演示如何对单列或多列数据进行升序或降序排列,并深入讲解当存在相同值时如何处理索引排序,以及如何通过列表参数实现不同列混合排序(如身高降序、武力升序)。
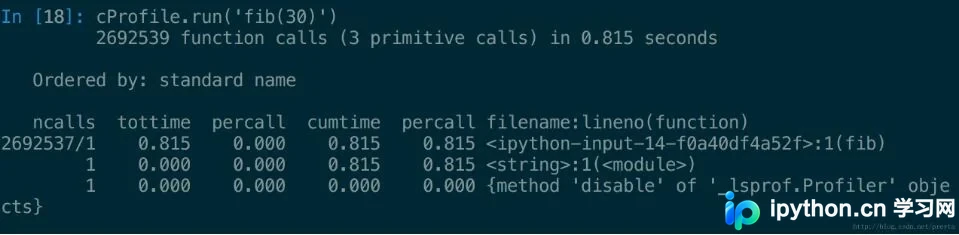
本文详细介绍Python标准库中用于性能测试的cProfile和pProfile模块,重点讲解cProfile.run()与runctx()用法及输出字段含义。通过fib函数示例,演示如何利用lru_cache缓存与迭代法优化递归性能,并展示pstats对测试结果的聚合、排序与过滤功能,帮助开发者高效定位性能瓶颈。
本文详细介绍如何使用 Python Pandas 将数据写入 Excel 文件。涵盖两种核心场景:使用 to_excel() 直接保存单个 DataFrame,以及利用 ExcelWriter 配合循环将多个数据写入同一工作簿的不同 Sheet。同时提供 xlrd、xlwt 和 openpyxl 库的安装建议,解决常见依赖问题。
本文盘点Python中除class外表示对象的多种方法。包括灵活但可变的dict、不可变的tuple、命名元组namedtuple和NamedTuple、动态属性SimpleNamespace以及高性能二进制打包的Struct。文章对比了各方式在空间性能、可变性及使用场景上的差异,帮助开发者根据具体需求选择最合适的对象定义方式。
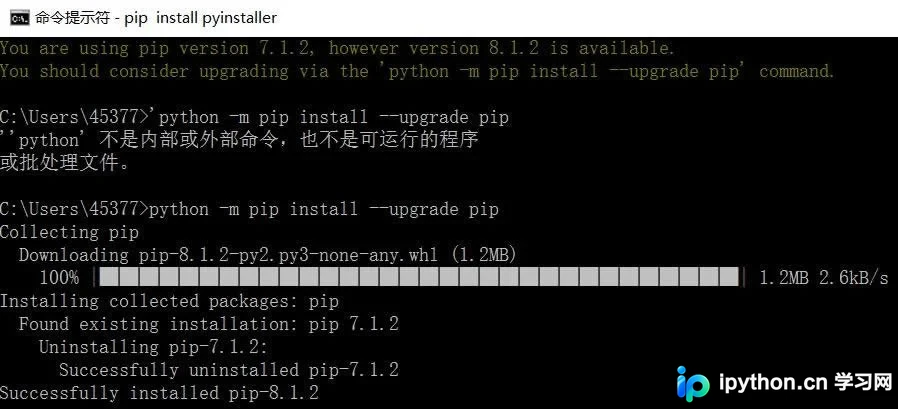
本文详细介绍将Python脚本打包为Windows可执行文件(EXE)的完整流程。涵盖pywin32依赖安装、pip环境更新、PyInstaller工具配置,以及使用-F、-w、-i参数进行单文件、无窗口及自定义图标打包的具体命令。特别指出测试中发现的-F参数可行性问题,并强调执行目录对资源文件路径的影响,帮助开发者高效完成程序发布。
本文解析 Python 中参数传递、返回值及对象拷贝的核心机制。针对不可变对象(如数字、元组),其行为类似值传递;针对可变对象(如列表、字典),直接赋值与浅拷贝会共享引用,而深拷贝则创建独立副本。通过代码示例阐明不同操作对内存地址及数据修改的影响。
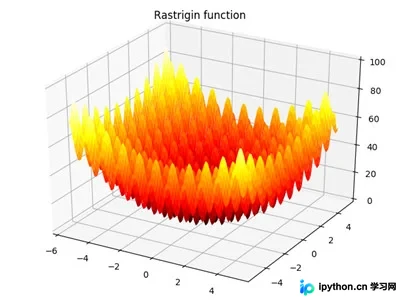
本文介绍使用Python和Matplotlib库绘制常见优化算法测试函数的3D图像。通过定义Rastring、Sphere等函数及通用绘图接口,展示如何生成可视化结果以辅助算法性能评估。
本文详细解析华为2019年在线笔试题中关于字符串处理的核心逻辑。内容涵盖如何识别并过滤非法字符、对合法字符串进行去重、执行循环左移10次操作,以及最终按ASCII码从小到大排序。通过Python代码实现输入解析、合法性校验及多步数据处理,为备考相关技术岗位提供实用参考。
本文演示如何使用Python requests和BeautifulSoup库抓取有道词典网页数据,实现英汉互译功能。通过ctypes模块实现Windows控制台彩色文字输出,并利用PyInstaller将脚本打包为独立的EXE文件,方便在CMD中直接运行。
本文详细介绍如何使用Anaconda快速搭建Python开发环境。内容涵盖Anaconda下载与安装注意事项、Windows系统环境变量的正确配置方法,以及在Visual Studio和PyCharm中导入Anaconda环境的步骤。此外,还讲解了通过Anaconda Prompt使用pip安装额外第三方库的操作流程,帮助初学者高效解决环境配置难题。
本文详细介绍Python中set(集合)的定义、特性及常用操作。set是一种无序且元素不重复的数据类型,通过set()创建。文章演示了如何遍历集合、使用add()和remove()方法添加或删除元素,并对比了list与set在计算效率上的差异。重点讲解了元素存在性判断及大小写敏感等注意事项,帮助开发者高效利用集合进行数据去重和快速查找。
本文详解pandas库中value_counts()函数的使用方法。涵盖Series单个列的频次统计、默认降序与升序排列、normalize参数计算占比,以及DataFrame多列批量统计。重点解析ascending和normalize参数的具体应用及空值处理机制,帮助开发者高效进行数据分布分析。