Python Pandas DataFrame 行列求和及新增行列操作详解
本文详细介绍在 Python 中使用 Pandas 库对 DataFrame 进行行与列求和,并将结果作为新列或新行添加至数据框末尾的具体操作方法。通过导入模块、生成随机数据及应用 apply 函数,实现数据的汇总与扩展,为数据分析提供基础支持。
2026-10-13
13

本文详细介绍在 Python 中使用 Pandas 库对 DataFrame 进行行与列求和,并将结果作为新列或新行添加至数据框末尾的具体操作方法。通过导入模块、生成随机数据及应用 apply 函数,实现数据的汇总与扩展,为数据分析提供基础支持。
本文详解Python爬虫中常见的403禁止访问错误原因,介绍通过urllib2模块添加User-Agent、Host和Referer等请求头来伪装浏览器访问的方法,并提供封装好的随机User-Agent选择函数代码,帮助开发者绕过基础反爬限制。
本文介绍了一个使用Python开发的简易在线音乐播放器项目。通过Tkinter构建图形界面,利用requests模块获取网易云音乐接口数据,结合json解析与mp3play库实现歌曲搜索与在线播放功能。
本文详解Python项目中requirements.txt的核心作用,涵盖手动维护与自动生成的多种方法(如pip freeze、pipreqs、pigar等),对比各工具优劣。重点解析多环境依赖管理策略,并深入辨析requirements.txt与setup.py的功能边界及共存必要性,通过Flask案例说明实际应用场景,为开发者提供规范的依赖管理最佳实践。
本文深入解析Python正则表达式中的贪婪与非贪婪匹配机制。通过具体代码示例,详细阐述默认贪婪行为导致的匹配偏差,并介绍使用问号?实现非贪婪匹配的方法。此外,还探讨了利用零宽断语(?=)和(?!解决字符消耗问题的技巧,帮助开发者更精准地控制正则表达式的匹配行为。
本文详解Python中单例模式的多种实现方式,包括饿汉式、懒汉式及多线程下的双重锁定机制。同时深入解析@staticmethod与@classmethod的区别,通过代码示例说明类方法、静态方法及类级别变量的使用场景与最佳实践,帮助开发者写出更规范的Python代码。
本文介绍Python中字典与字符串相互转换的两种常见方式。字典转字符串可通过遍历元素拼接实现;字符串转字典则推荐使用eval或exec函数解析。文章提供了具体代码示例及操作技巧,帮助开发者快速掌握相关数据处理方法。
本文介绍Python中读取文件最后N行及最后一行的两种方法。第一种适用于小文件,直接读取所有行后切片;第二种针对大文件,通过计算文件大小和块大小,利用seek定位读取末尾数据,避免全量加载内存。文中包含完整代码示例及日志格式说明,供Python开发者参考。
本文详细介绍Python中NumPy库的基础用法,涵盖数组创建、维度与数据类型查看、基础加减乘除运算、索引切片、布尔索引、ufunc函数(如meshgrid和where)、数学统计、矩阵乘法及随机数生成。通过具体代码示例,帮助开发者掌握高效数据处理的核心技能。
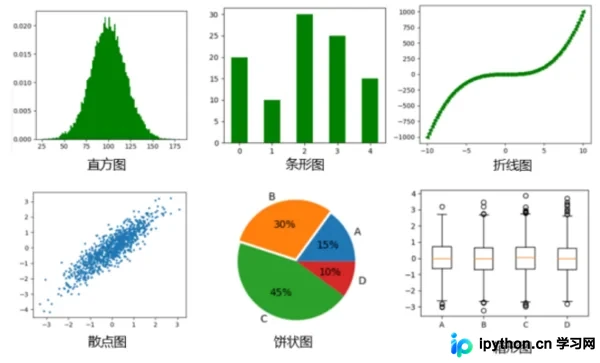
本文系统介绍Python中Matplotlib库的绘图方法,涵盖直方图、条形图、折线图、散点图、饼图及箱形图的实现代码。同时详解23种点形状、8种内置颜色、4种线性样式,以及子图布局、网格生成和图例添加等图像调整技巧,帮助开发者快速掌握数据可视化核心技能。
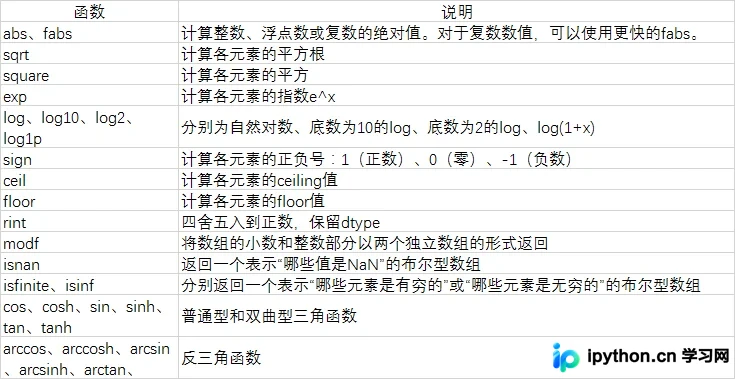
本文详解Python中正负无穷(Inf)与非数值(NaN)的判断方法。指出使用is和==运算符判断NaN时存在反直觉行为,推荐优先使用math模块的isinf和isnan函数进行准确判断,并介绍了利用对象自身不等性及numpy模块处理数组的技巧。
本文基于《Python Qt GUI快速编程》第10章示例,使用Python3和PyQt5实现剪贴板功能。代码演示了如何分别处理文本、图片及HTML内容的复制与粘贴操作,三种方式逻辑相似。通过完整代码展示,帮助开发者掌握在Qt应用中集成剪贴板交互的方法。