

Python计算指定时间差的方法详解
本文介绍如何在Python中计算指定时间差,通过time模块实现获取过去或未来特定天、小时、分钟及秒数的时间。代码示例展示了UTC与本地时间的处理,以及三天前、两小时前等常见场景的用法,方便数据分析和日志处理时复用。
2026-10-13
13

本文介绍如何在Python中计算指定时间差,通过time模块实现获取过去或未来特定天、小时、分钟及秒数的时间。代码示例展示了UTC与本地时间的处理,以及三天前、两小时前等常见场景的用法,方便数据分析和日志处理时复用。
本文介绍如何利用Python和Selenium库自动化处理网页分页功能。通过解析DOM元素,可获取分页总数、当前页码及翻页状态,并演示如何定位并点击指定页码链接实现页面跳转,适用于Web自动化测试与数据采集场景。
本文详细介绍基于Python的自动群发邮件脚本实现方案。通过多账号轮换、内容混淆及时间间隔控制等策略,有效降低邮件进入垃圾信箱的概率。文章涵盖CentOS环境下Python版本升级、目录结构规划、日志系统配置及核心发送代码解析,提供了一套低成本、高可用性的邮件群发技术参考。
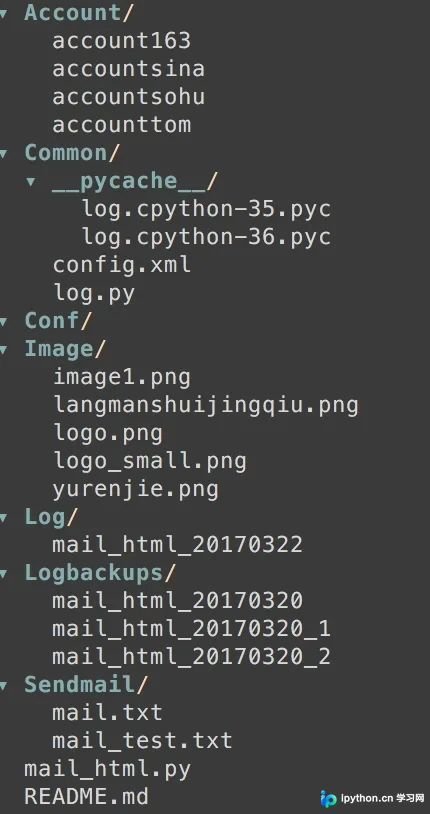
本文介绍在Python中如何获取文件名和文件路径。通过os模块的basename、dirname、realpath以及listdir和walk函数,可以分别提取URL或本地路径中的文件名与目录,列出指定目录内容,并递归遍历文件夹获取所有文件信息。
本文深入解析 Python Beautiful Soup 库的搜索功能,涵盖 find() 与 find_all() 的核心用法。详细讲解如何通过标签名、属性、文本及正则表达式精准定位元素,并演示处理自定义属性和 CSS 类属性的技巧。此外,还介绍了利用父级、同级及下级标签进行关联搜索的高级策略,帮助开发者高效提取网页数据。
本文详细介绍 Python Beautiful Soup 模块中 BeautifulSoup、Tag 和 NavigableString 三种核心对象的创建与使用方法。涵盖通过字符串或文件对象初始化 BeautifulSoup,指定 features 参数选择解析器(如 lxml、html5lib)的技巧,以及获取和修改 Tag 名称、属性及文本内容的实际操作。
本文详细讲解如何将Python程序封装为Windows系统服务。通过调用win32service等API实现服务框架,利用PyInstaller进行单文件打包,并演示使用sc命令进行服务的安装、启动、停止及删除操作,解决运行中的常见坑点。
本文详细解析Python中的类继承机制,通过Parent与Child类的单继承示例展示方法调用流程,并进一步说明Python支持多继承的特性。文章提供完整的类定义、实例化及输出结果代码,帮助开发者理解Python实现继承的简洁性与具体用法。
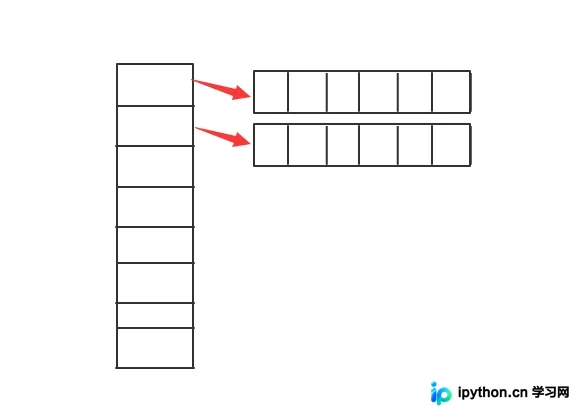
本文介绍如何在Python中使用列表模拟字典,重点讲解利用拉链法解决Hash冲突的方法。通过在每个哈希桶中嵌套子列表,即使发生碰撞也能存储数据,配合良好的Hash函数和足够大的表长,可实现接近O(1)的查找效率。
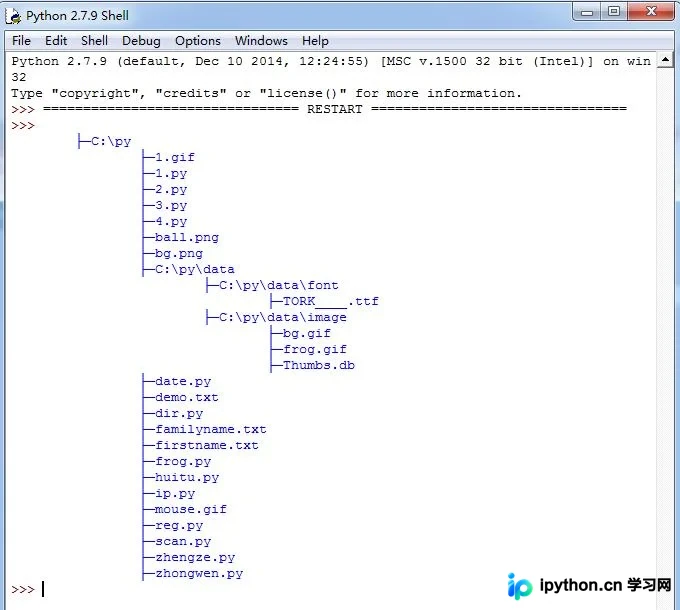
本文提供了一段基于Python的递归函数代码,用于遍历指定目录并输出树状结构。通过判断文件与文件夹类型,利用os.listdir获取子项并递归调用,实现目录树的可视化展示。代码包含存在性检查及基础的文件名打印逻辑,适合需要快速处理目录结构的场景参考。
本文介绍如何利用Python标准库xml.etree.ElementTree模块创建XML文件。通过定义根节点、子节点及属性,并设置文本内容,最终写入指定文件。文中附带完整代码及在线XML处理工具推荐,适用于需要程序化生成结构化数据场景。
本文通过Python中re.split函数的实际运行结果,解析了正则表达式中括号分组对匹配结果的影响。当使用带括号的模式如'(\W+)'时,分组内的匹配内容会被单独提取并保留在返回列表中,导致非单词字符出现在结果里。对比无括号模式可知,这是正则表达式标准行为,旨在允许用户获取分隔符信息。