

Python通用VCF文件读取与处理类实现
本文介绍了一个通用的Python VCF文件读取类,旨在解决现有库固定字段限制的问题。该类支持直接读取VCF文件的Header、INFO及GT等复杂字段,并提供迭代器接口进行高效遍历。通过示例展示了如何过滤特定条件(如AF值、FILTER状态)并输出结果,适用于需要灵活处理VCF格式的场景。
2026-10-12
13

本文介绍了一个通用的Python VCF文件读取类,旨在解决现有库固定字段限制的问题。该类支持直接读取VCF文件的Header、INFO及GT等复杂字段,并提供迭代器接口进行高效遍历。通过示例展示了如何过滤特定条件(如AF值、FILTER状态)并输出结果,适用于需要灵活处理VCF格式的场景。
本文介绍如何在Python中将字典转换为JSON字符串时保持键值对的输入顺序。默认情况下,Python字典在转换时会按字母排序,导致顺序丢失。通过引入collections模块中的OrderedDict类,可以显式指定字典的排序规则,确保JSON输出与原始数据顺序一致。文章提供了详细的代码示例和注意事项,帮助开发者解决数据序列化时的顺序问题。
本文系统讲解Python中字符串的常见操作,涵盖切片、原始字符串、重复、成员检测及常用内置函数。详细演示去空格、分隔、拼接、统计、替换、格式化输出等核心技巧,通过具体代码实例帮助开发者掌握字符串处理的关键方法。
本文介绍如何使用 Python 的 scipy 库计算连续与离散随机分布的概率密度(pdf)、累计分布(cdf)及逆函数(ppf)。通过正态分布、二项分布等示例,展示 loc 和 scale 参数的调整方法。此外,深入解析基于 CDF 逆函数生成随机数的两种实现路径:公式法与数值模拟法,并附带伯努利分布生成的代码示例。
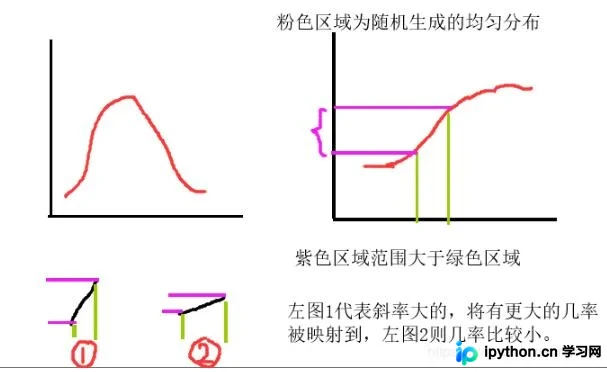
本文介绍在Python中对WAV文件进行重采样(改变采样率)及通道转换的方法。通过Librosa库的load函数可快速实现音频重采样;同时提供基于标准库wave和audioop的手动实现方案,支持指定输入输出采样率及通道数(如双通道转单通道),并包含完整的代码示例与注意事项。
本文介绍在 Python 中找出列表出现次数最多元素的三种方法。通过手动构建字典统计、利用 setdefault 简化逻辑,以及使用 collections.Counter 模块,分别展示了不同场景下的实现方式。重点解析 Counter 的 most_common 用法及其返回类型,帮助开发者高效处理数据频次统计。
本文深入解析 Python 函数注解与匿名函数(lambda)。函数注解通过 __annotations__ 属性存储类型提示,但不参与运行时检查,主要用于生成文档。lambda 表达式用于定义单行匿名函数,支持排序等场景,但需注意自由变量在运行时的绑定机制及默认参数捕获技巧。
本文详细介绍Python中单链表的原理与实现方法。内容涵盖链表基本概念、节点定义、头指针作用,以及头部插入、头部删除、尾部添加、指定位置插入和按值删除等核心操作的代码实现与逻辑解析,帮助读者深入理解链表数据结构。
本文详细解析Python NumPy中两种常见索引方式的区别。通过具体代码示例,对比`array[0][0]`(链式索引)与`array[0,0]`(元组索引)的执行机制与性能差异,帮助开发者理解底层原理并选择更高效的访问方式。
本文系统梳理 Python 编程中的核心命名规范,涵盖模块、类、函数、变量及常量的命名规则。详细解析小写、驼峰、下划线及双下划线的具体应用场景,帮助开发者写出符合 PEP 8 标准、清晰易读的 Python 代码。
本文整理了适合Python初学者的实用编程技巧,涵盖变量交换、条件表达式、列表与字典推导式、字符串处理、切片操作及常用模块使用。通过具体代码示例,帮助初学者提升代码简洁性与执行效率,快速掌握Python核心语法特性。
本文介绍在Python中获取二维数组行列数的两种常用方法。第一种利用NumPy库的shape属性,直接获取元组形式的维度信息;第二种使用内置len()函数,分别计算列表长度和首行长度。通过具体代码示例,清晰展示如何提取行数和列数,适用于不同场景下的数据处理需求。