

Python处理缺失值的常见策略与代码实现
本文总结Python中处理缺失值的五种主要方法,包括忽略元组、人工填写、全局常量、均值填充及最可能值预测。结合Scikit-learn库的Imputer类,演示如何使用均值策略填充NaN数据,并分析各方法的适用场景与局限性,帮助开发者选择合适的数据预处理方案。
2026-10-12
13

本文总结Python中处理缺失值的五种主要方法,包括忽略元组、人工填写、全局常量、均值填充及最可能值预测。结合Scikit-learn库的Imputer类,演示如何使用均值策略填充NaN数据,并分析各方法的适用场景与局限性,帮助开发者选择合适的数据预处理方案。
本文深入解析Python中in和is的区别。in用于判断成员资格,检查值是否存在于序列中;is用于判断身份标识,确认两个变量是否指向同一内存对象。通过对比id()和__eq__()机制,明确两者在对象比较中的不同应用场景。
本文详细讲解在Python中如何为数据添加标签、根据条件判断标签值以及从HTML结构中获取特定标签内容。通过Pandas的merge与apply方法实现复杂逻辑打标,并结合lxml库利用XPath表达式精准提取网页元素属性,适用于数据分析和网络爬虫场景。
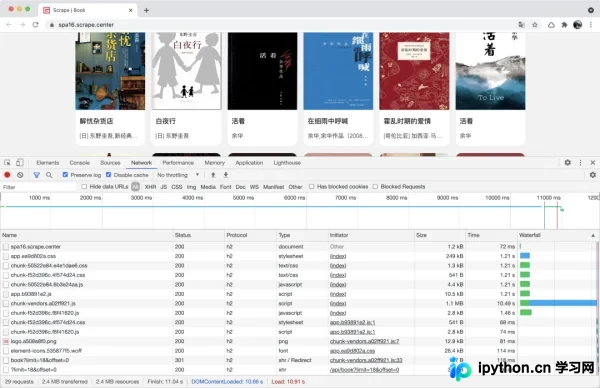
本文介绍一种基于强制HTTP/2.0协议的反爬虫策略。由于主流Python爬虫库如requests仅支持HTTP/1.1,且Scrapy的HTTP/2支持尚为实验性,通过Nginx配置拒绝HTTP/1.x请求可有效拦截大部分自动化脚本。文章详细演示了Nginx及Kubernetes Ingress的配置方法,并通过对比requests、Scrapy与httpx的测试结果,验证了该方案对常规爬虫的阻断效果及合法用户的兼容性。
本文详细解析Python中__new__与__init__方法的差异与协作机制。__new__负责创建实例并返回对象,__init__负责初始化实例属性。文章通过代码示例说明两者调用顺序、返回值影响及继承场景下的行为,帮助开发者深入理解Python对象创建流程。
本文深入解析Python类的继承链机制,通过实例演示子类如何继承父类及多层继承关系。重点讲解使用内置函数issubclass()验证继承关系,并详细对比直接调用父类构造方法与使用super()函数的区别,帮助开发者掌握Python面向对象编程中的继承与重构技巧。
在Django开发中,通过request.META.get()获取不到自定义header是常见问题。本文详细解析其根本原因:Django会自动将HTTP请求头转换为大写并替换连字符为下划线,且必须添加HTTP_前缀。例如,auth-token需转换为HTTP_AUTH_TOKEN。文章还对比了URL参数、查询字符串、表单及原始请求体的获取方式,帮助开发者全面掌握Django的请求处理机制。
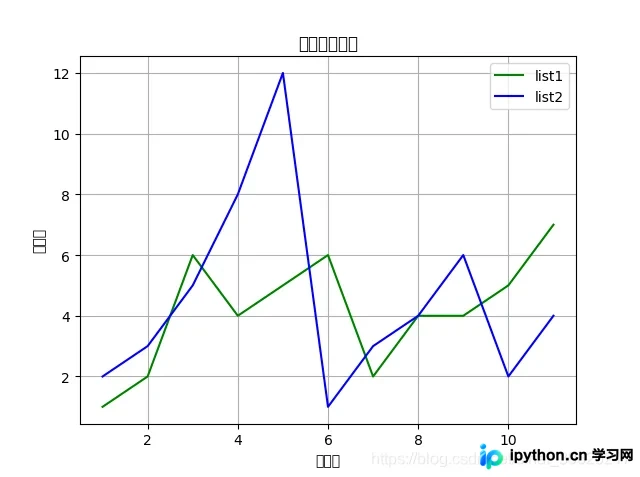
本文详解Python中matplotlib库的绘图技巧,涵盖中文标题与坐标轴乱码的解决方法,以及如何自定义线条颜色、粗细、线型及网格显示。通过完整代码示例,展示如何生成美观的折线图,适合Python初学者快速掌握基础绘图功能。
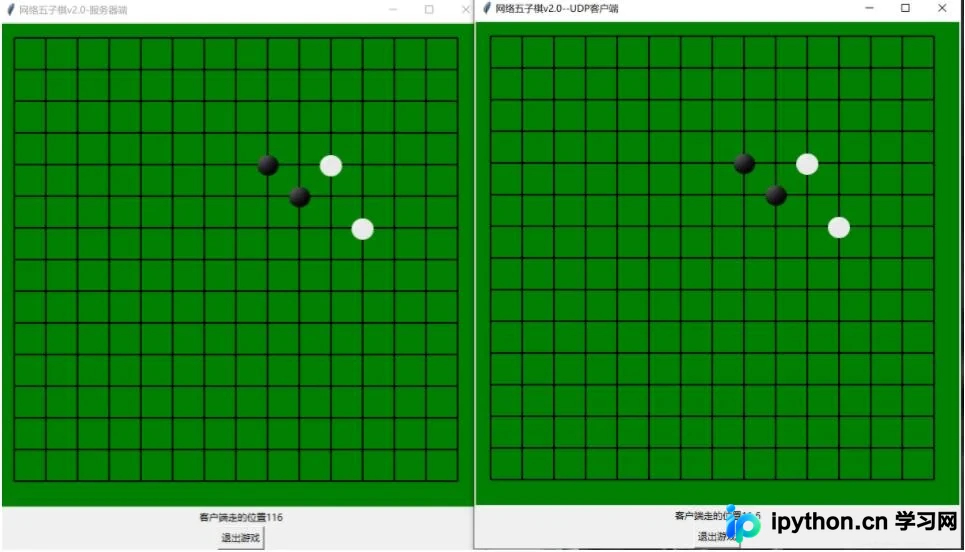
本文介绍使用Python和UDP协议实现的网络五子棋游戏。通过Tkinter构建图形界面,利用多线程处理网络通信与游戏逻辑。代码涵盖服务器端监听、客户端连接及棋盘绘制功能,支持双人对战,适合Python网络编程初学者参考学习。
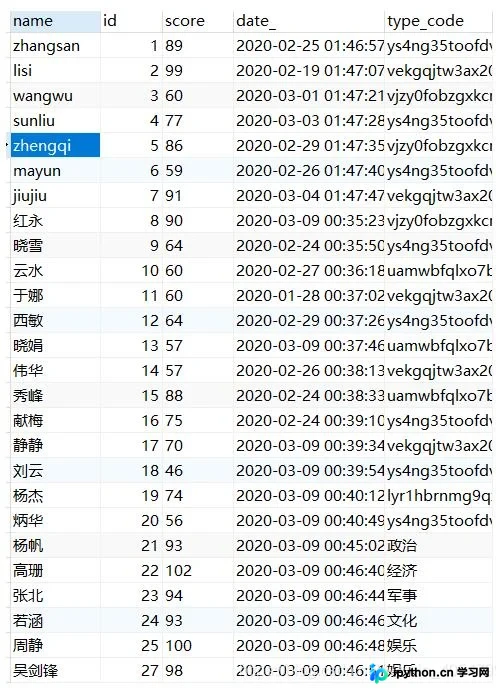
本文详解Python中pymysql库的cur.fetchall与cur.fetchone方法。通过连接MySQL数据库,演示如何提取数据并利用pandas进行分组统计、映射编码、排序及格式转换,最终输出前端所需JSON格式。同时对比fetchone在单行查询中的应用,提供完整的代码示例与结果分析。
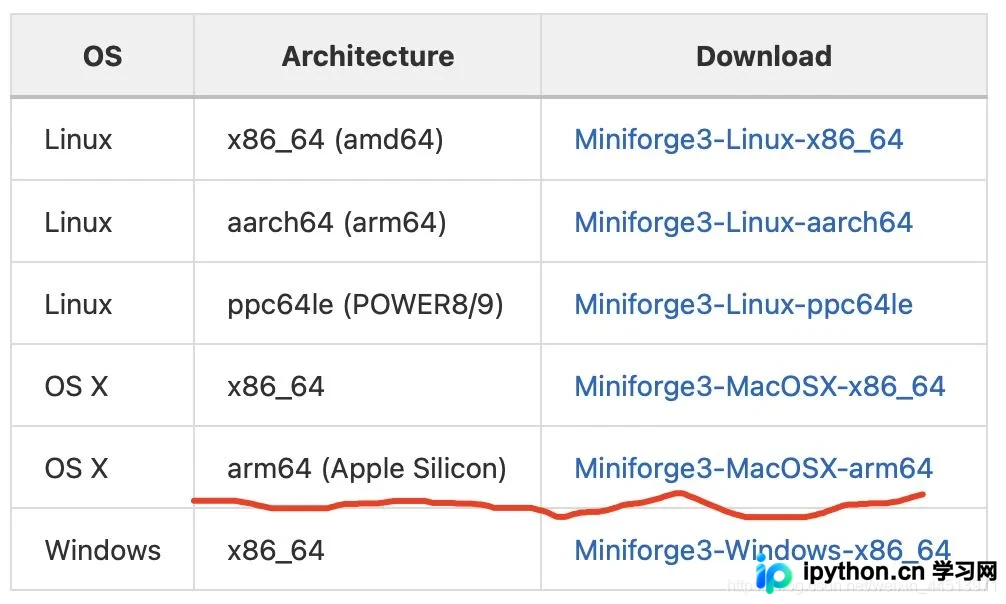
本文详细记录在搭载M1芯片的MacBook Air上安装Miniforge3及配置Conda镜像源的全过程。针对ARM架构,推荐使用Miniforge3替代传统Anaconda。文章重点解决了镜像源配置后condarc文件未生效的常见错误,通过终端命令修正配置文件,确保pandas、numpy等库的正常安装,帮助开发者快速搭建Python开发环境。
本文深入解析Python主流Web框架Django与Flask的设计哲学及适用场景,并详细阐述WSGI(Web Server Gateway Interface)标准的核心作用。通过从零实现Socket服务器与wsgiref模块的对比,揭示Python Web应用从接收请求到返回响应的底层流程,帮助开发者理解框架选型与生产环境部署的关键差异。