

Python装饰器深入解析:从基础到高级应用
本文深入解析Python装饰器的核心原理与实战用法。从无需修改原代码即可扩展功能的角度出发,逐步演示如何构建通用装饰器、处理带参函数、支持不定长参数以及组合多个装饰器。通过具体代码案例,阐明装饰器的工作机制、执行顺序及常见错误排查,帮助开发者掌握这一Python高级特性。
2026-10-15
9

本文深入解析Python装饰器的核心原理与实战用法。从无需修改原代码即可扩展功能的角度出发,逐步演示如何构建通用装饰器、处理带参函数、支持不定长参数以及组合多个装饰器。通过具体代码案例,阐明装饰器的工作机制、执行顺序及常见错误排查,帮助开发者掌握这一Python高级特性。
本文介绍一个基于Python的辅助脚本,旨在解决Windows下网易邮箱大师客户端中邮件阅读效率低的问题。通过调用Windows API模拟键盘操作,脚本可自动执行删除键(Delete)并间隔读取邮件,实现快速浏览与批量清理无用邮件的功能。该脚本仅限Windows环境使用,适用于处理大量未读邮件的场景。
本文深入解析 Python 库 PyG2Plot 的工作原理,指出其借鉴 pyecharts 但基于 G2Plot 配置式结构更为简洁。详细说明了 plot.py、engine.py 及 templates 三大核心文件的作用,并展示了通过 render 生成 HTML 或在 Jupyter Notebook 中预览的具体代码示例与使用场景。
本文详解Python链表类中append与get_position方法的实现逻辑。append方法通过遍历找到尾节点并指向新元素,处理空链表情况;get_position方法利用计数器遍历链表以定位指定位置节点,返回None处理非法索引。
本文详解Python爬虫中利用Requests库处理Cookie的两种核心方法。通过对比urllib,展示如何使用get方法直接传递Cookie,以及利用Session对象在多次请求间自动保持Cookie状态。包含具体代码示例及运行结果分析,帮助开发者更高效地实现登录态维持与数据抓取。
本文详细介绍如何使用Python编写一个基于CSV文件的学生电子考勤系统。内容涵盖学生信息的加载、基于学号和密码的登录验证机制(含三次重试逻辑)、考勤数据的写入以及按姓名查询出勤记录的功能实现。通过解析main.py与stu_attendance.py两个核心文件,帮助开发者掌握基础的数据持久化与交互逻辑。
本文详细介绍如何使用Python结合PySimpleGUI和Pandas库开发一款数据预处理小工具。通过构建图形用户界面,实现Excel文件的读取与预览,并自动化处理重复值、缺失值及异常值。文章涵盖界面布局设计、核心代码解析、数据处理逻辑及使用PyInstaller打包成可执行文件的全过程,旨在提供一键完成数据清洗的实用方案。
本文详解Python中raise语句的语法与作用,分析异常触发与传递流程。通过内置异常、自定义异常及异常链携带信息的三个实战示例,展示如何精准抛出和处理错误,提升代码稳定性与调试效率。
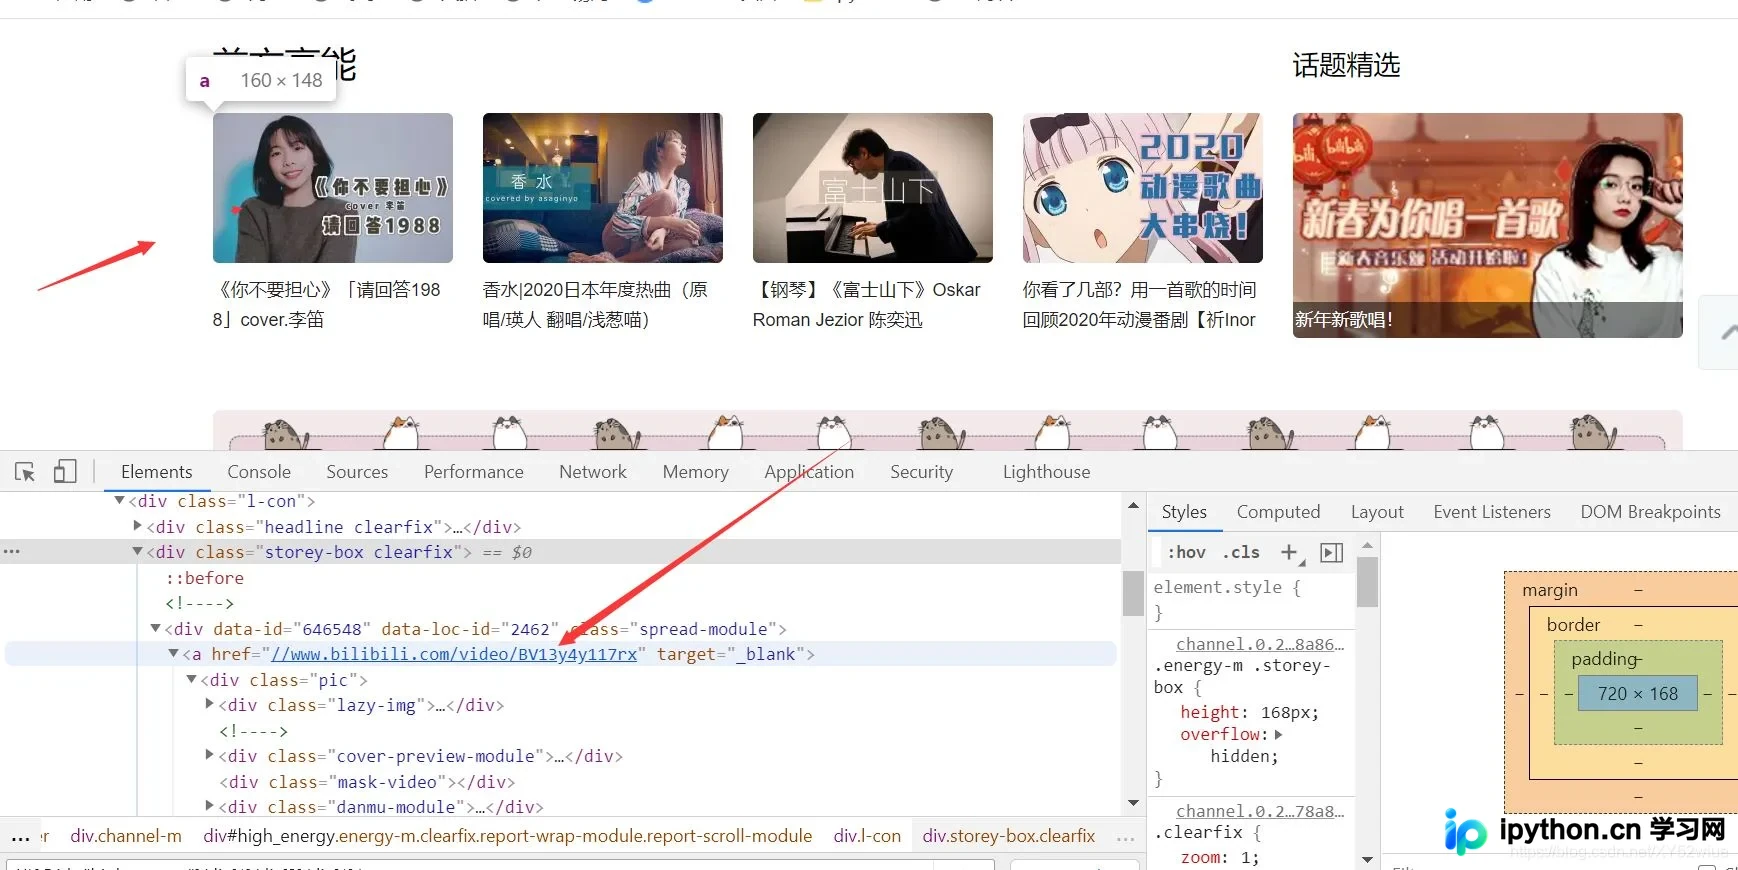
本文通过B站爬虫案例,指出Selenium中使用XPath直接获取属性(如./a/@href)会报错,正确做法是先定位元素节点再调用get_attribute()方法。文章提供了完整的Python代码示例,展示了如何在无头浏览器环境下解析网页数据并提取链接与标题。
本文介绍在Python爬虫开发中,如何获取HTTP重定向后的最终URL。通过urllib库的urlopen方法和requests库的get方法,分别展示了两种获取重定向地址的代码实现。重点解析了如何从响应对象中提取最终跳转后的网址,并提供了包含User-Agent请求头设置的示例,帮助开发者解决爬虫追踪真实链接的问题。
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。