

Python将List列表写入文件并读取的多种方法详解
本文汇总了Python中将List列表写入文本文件的四种常用方法,包括直接写入、字符串转换、循环写入及join函数处理,并详细解析了read、readline和readlines三种读取方式的区别与注意事项。此外,文章还补充了使用csv和xlwt库写入CSV及Excel文件的实现代码,帮助开发者灵活处理数据持久化需求。
2026-10-15
9

本文汇总了Python中将List列表写入文本文件的四种常用方法,包括直接写入、字符串转换、循环写入及join函数处理,并详细解析了read、readline和readlines三种读取方式的区别与注意事项。此外,文章还补充了使用csv和xlwt库写入CSV及Excel文件的实现代码,帮助开发者灵活处理数据持久化需求。
本文详解Scrapy框架中下载中间件的编写方法。涵盖process_request、process_response及process_exception三大核心函数的实现逻辑,演示如何通过中间件进行UA伪装、响应数据篡改(结合Selenium处理动态加载)以及代理IP设置,并说明在settings.py中启用中间件的具体配置步骤。
本文详细介绍在Python中使用pandas库计算环比和同比数据的方法。通过示例演示了利用shift、diff及pct_change函数处理时间序列数据的技巧,涵盖月度、季度及年度周期设置,并解析了处理缺失值和不同轴向计算的参数配置,帮助开发者高效完成业务数据分析。
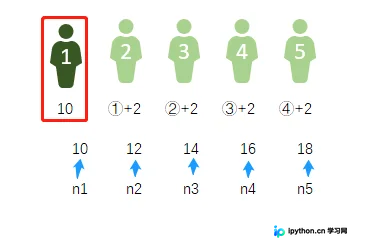
本文通过Python和R语言两种编程语言,详细演示了斐波那契数列与年龄计算问题的实现方法。文章从数学原理出发,结合代码示例,对比展示了两种语言在循环结构、函数封装及交互输入处理上的异同,旨在帮助读者深入理解基础语法在实际场景中的应用。
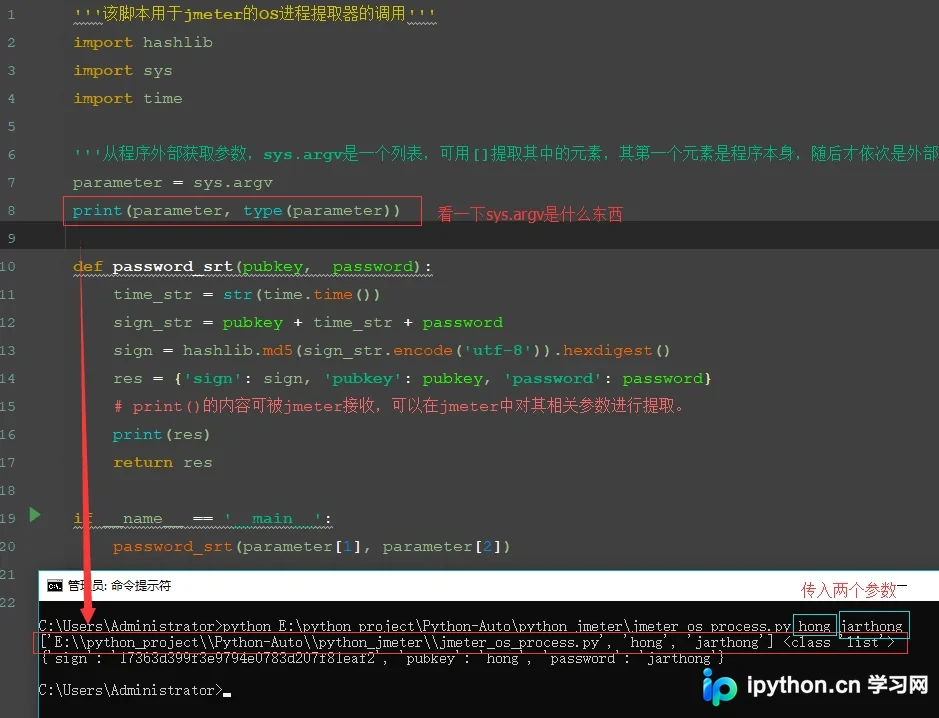
本文详解如何在JMeter中使用OS Process Sampler组件调用Python脚本,通过sys.argv接收外部参数并返回结果。结合.bat批处理文件与正则表达式提取器,实现JMeter与Python间的参数双向传递及数据提取,适用于接口自动化测试中的动态数据处理场景。
本文详细介绍Python中pass语句和assert断言函数的用法。pass作为空语句用于占位,保持代码结构完整而不执行任何操作;assert用于条件判断,当表达式为假时抛出AssertionError异常,常用于程序调试和输入验证,有助于提高代码健壮性。
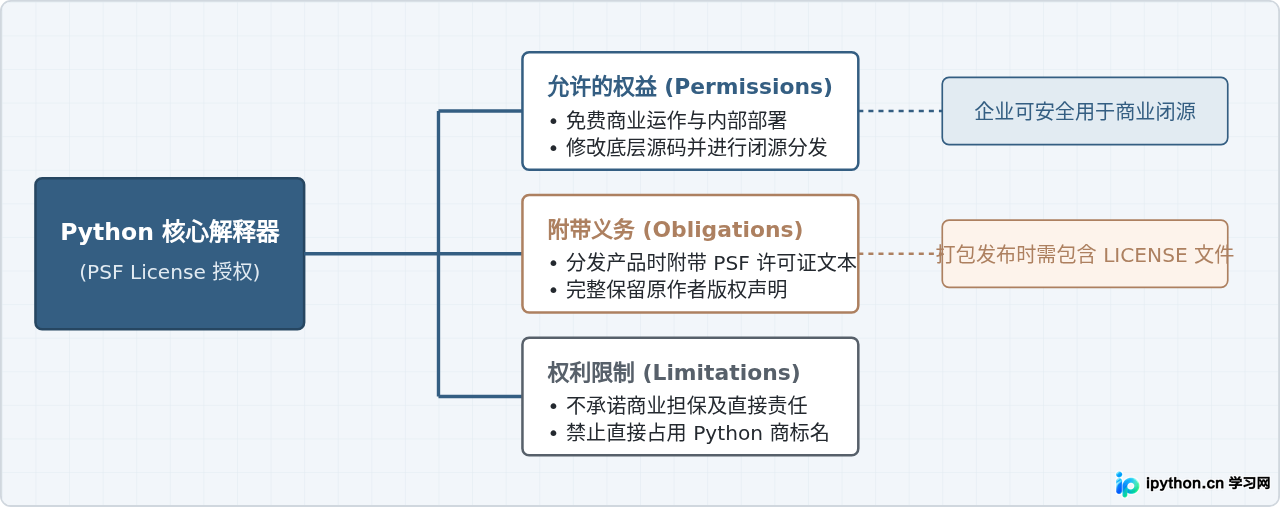
全面解析Python自身PSF协议及第三方包常见开源协议的限制条件,提供个人与企业在商业闭源、分发与二次开发时的合规指南与排查步骤。
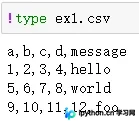
本文详解pandas中read_csv与read_table函数的数据读取方法,涵盖分隔符指定、表头处理、索引设置及缺失值标识配置。同时介绍to_csv导出技巧、header与index_col参数用法,以及利用chunksize实现大文件分块读取和聚合操作,帮助高效处理文本格式数据。
本文详解Python3中str与bytes两种字符串类型的区别,重点讲解在网络传输中两者相互转换的必要性。通过具体代码示例,演示bytes转str的两种方法(str()函数与decode())以及str转bytes的两种方法(bytes()函数与encode()),帮助开发者掌握正确的编码处理技巧。
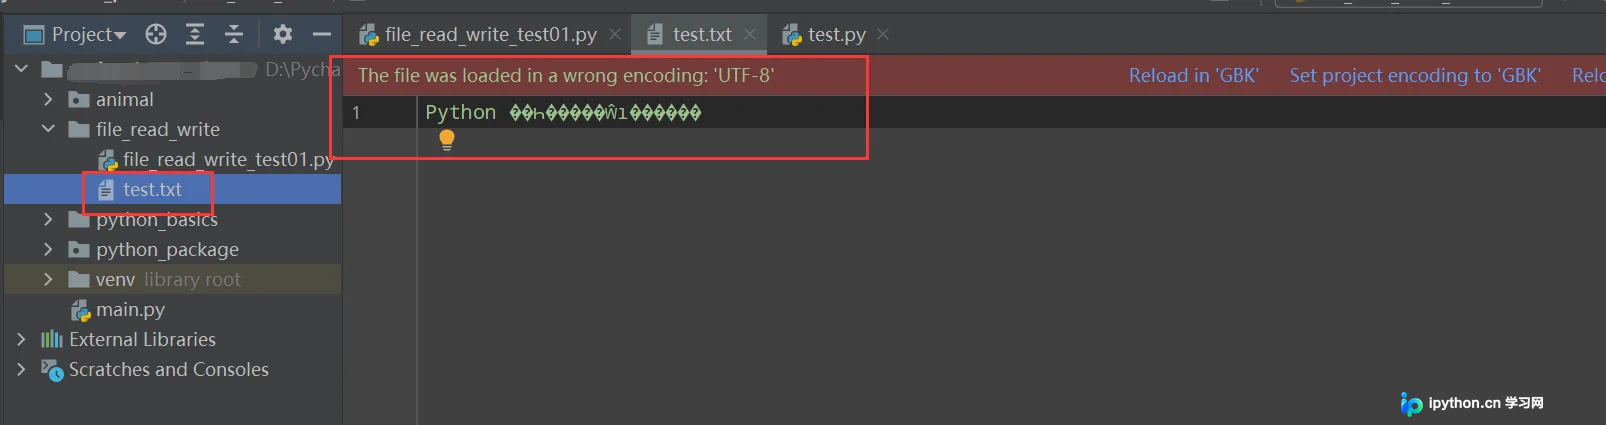
本文详解Python中文件的创建与写入操作。重点解析open()函数的参数与返回值,深入对比w、w+、a、ab等写入模式的区别与适用场景。针对Windows系统中文编码问题提供解决方案,并通过自动创建包及自定义换行类两个实战案例,展示文件操作的高级应用技巧。
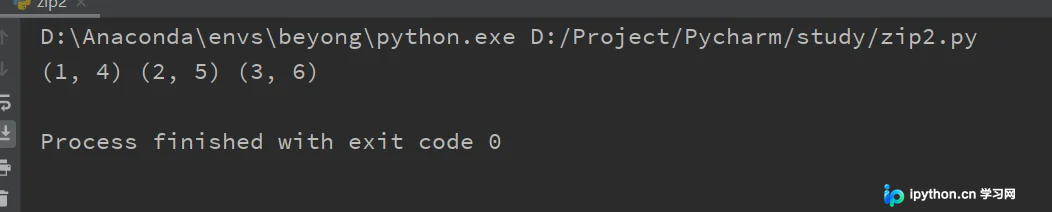
本文深入解析Python内置函数zip()的核心机制与高级应用。详细阐述zip()如何将多个可迭代对象打包为元组,涵盖基础语法、列表合并及字典构建。重点演示利用zip()实现矩阵的旋转与行列转置,并通过*zip()操作演示序列解压的反向过程,帮助开发者掌握数据处理中的关键技巧。
本文深入解析 Python 中 lambda 匿名函数的定义、语法及核心应用场景。通过对比 def 语句,阐述 lambda 在 map、filter 等函数式编程中的优势,并展示如何利用闭包创建动态函数工厂,帮助开发者编写更简洁高效的代码。