

pandas 快速处理 date_time 日期格式方法
本文介绍如何在 pandas 中高效处理非标准日期格式。通过对比两种处理方式,展示使用 to_datetime 函数时指定 format 参数对提升处理速度的关键作用。示例显示,对于300万条数据,明确指定格式可将处理时间从10分钟缩短至10秒。
2026-10-13
9

本文介绍如何在 pandas 中高效处理非标准日期格式。通过对比两种处理方式,展示使用 to_datetime 函数时指定 format 参数对提升处理速度的关键作用。示例显示,对于300万条数据,明确指定格式可将处理时间从10分钟缩短至10秒。
本文针对每日千万级Kafka数据写入磁盘的场景,探讨了如何高效管理动态生成的文件及计数器。通过对比尝试使用exec等动态语法失败的经历,最终提出利用三个独立字典分别存储计数器、时间戳和分类信息的解决方案。该方法避免了定义海量变量的性能损耗,实现了基于配置条数自动切换文件后缀(tmp转out)的稳定处理流程。
本文通过实例对比Python中两种常见的文件读取方式:逐行迭代读取与readlines一次性读取。测试结果显示,逐行遍历虽然内存占用低,但耗时较长;而使用readlines将内容一次性加载至列表后处理,在速度上具有明显优势。文章提供了具体的代码实现及性能差异说明,帮助开发者根据实际需求选择高效的文件读取策略。
本文介绍如何在Python中使用列表生成式替代传统的嵌套for循环,以提取嵌套列表中的元素。通过对比传统循环与列表生成式的写法,展示代码简化技巧,帮助开发者提升代码可读性与执行效率。
本文介绍Python中训练数据与标签同步打乱的两种常用方法。第一种通过生成并打乱索引数组来重排数据,适用于大数据量以节约内存且每次结果不同;第二种利用随机种子固定打乱顺序,分别对数据和标签执行shuffle。两者各有适用场景,可根据需求选择。
本文详解如何在Python Flask框架中集成Flask-APScheduler模块以实现定时任务调度。内容涵盖安装方法、Config配置对象的使用、scheduler初始化流程,以及基于cron和interval触发器的具体代码示例与参数说明,帮助开发者快速掌握Flask下的任务调度方案。
本文详细介绍在 Python 中导入 CSV 文件的三种常用方法。首先通过标准库 csv 结合 NumPy 数组处理基础数据;其次利用 NumPy 的 loadtxt 函数处理无表头且类型统一的数据;最后重点推荐 Pandas 库的 read_csv 函数,因其返回 DataFrame 结构,便于后续数据清洗与机器学习建模,是实际开发中的首选方案。
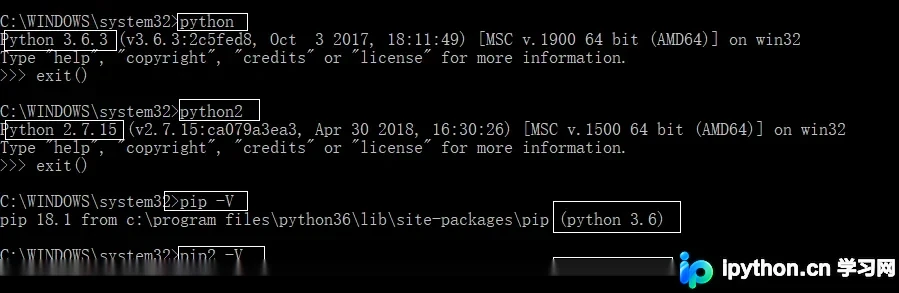
本文介绍在Windows系统中同时安装Python 2和Python 3时,如何将Python 3设置为默认运行版本。通过修改系统环境变量,并针对性地重命名或复制根目录及Scripts文件夹下的可执行文件(如python.exe和pip.exe),可实现命令行调用默认指向Python 3。操作完成后,通过命令行验证版本信息以确认配置成功。
本文详细介绍Python中列表的基本定义与类型判断,系统讲解append、count、extend、index、insert、pop、remove、reverse、sort及len等常用函数的用法。通过代码示例演示列表的增删改查、排序去重及类型限制,帮助初学者快速掌握列表核心操作。
本文详细介绍如何在Python中将包含大量浮点数的TXT文件数据读取并转换为NumPy数组。通过示例代码展示如何逐行处理文本、去除换行符、按逗号分割数据,并利用numpy的array和c_函数构建二维数组,最终实现125行45列数据的精确加载与输出。
本文介绍如何在 pandas 中创建一个空的 DataFrame 并预先定义列名。通过构建包含基础字段、动态列表及特定标识的列名数组,并将其传递给 DataFrame 构造函数,即可实现快速初始化。该方法适用于需要预设数据结构后续填充数据的场景。
本文详解Python3中字符串编码转换方法,重点讲解如何将UTF-8字符串转为16进制Hex字符串,以及Bytes与Unicode之间的互转技巧。通过具体代码示例,展示bytes.fromhex()、encode()及decode()函数的实际应用,解决老接口对接时的编码兼容问题。