Python使用Pandas将CSV数据导入SQLite3数据库
本文介绍如何使用Python的Pandas库将CSV文件高效导入SQLite3数据库。通过示例代码展示利用read_csv读取数据,并借助to_sql方法将数据写入指定表,相比传统Shell模式操作更为便捷,适合初学者参考。
2026-10-13
19

本文介绍如何使用Python的Pandas库将CSV文件高效导入SQLite3数据库。通过示例代码展示利用read_csv读取数据,并借助to_sql方法将数据写入指定表,相比传统Shell模式操作更为便捷,适合初学者参考。
本文详细解析Python re模块中贪婪与非贪婪模式的匹配机制。通过对比示例,说明默认贪婪模式尽可能匹配最长字符串,而非贪婪模式通过添加问号“?”实现最少匹配。文章提供具体代码案例,展示如何正确处理数字提取等场景,帮助开发者精准控制正则表达式的匹配行为。
本文详细介绍使用Python实现基于二进制编码的遗传算法,以求解特定二元函数的最优值。内容涵盖变量编码长度计算、参数设置、轮盘赌选择、交叉变异及自学习策略,并提供完整代码与结果分析,帮助开发者掌握智能优化算法的核心实现细节。
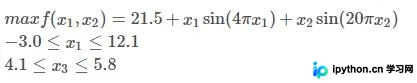
本文详细介绍如何使用Python的cryptography库结合OpenSSL生成的RSA密钥对进行安全通信。内容涵盖从Linux环境下使用yum安装openssl、生成私钥与公钥文件,到在Python中加载密钥、执行RSA签名与验证、以及公钥加密私钥解密的全过程。文中提供了具体的代码示例,包括处理大文件时的Prehashed用法及PSS填充方案,帮助开发者掌握完整的加解密与身份验证流程。
本文详细介绍Python中获取当前时间及格式化时间日期的多种方法。通过time模块的time()、localtime()和strftime()函数,可将时间戳转换为结构化时间或指定格式的字符串。同时利用calendar模块生成指定月份的日历视图,帮助开发者灵活处理时间数据。
本文详细解析Python中守护线程的实现原理。通过对比setDaemon(True)与False的执行结果,阐明主线程退出时子线程的行为差异。同时介绍利用isAlive()方法监控线程状态,并在检测到线程死亡时自动重建并启动新工作线程的完整流程,适用于需要后台持续运行的场景。
本文深入解析Python中默认参数的调用方式,通过示例展示三种常见调用形式。重点阐述默认值仅在函数定义时赋值一次的机制,特别是当默认参数为列表等可变对象时可能引发的累积错误。文章提供了使用None作为默认值的标准解决方案,帮助开发者避免潜在bug,提升代码健壮性。
本文详解Python中通过序列索引进行For循环迭代的方法。重点解析len()获取长度与range()生成索引序列的配合使用,涵盖字符串、列表及元组的遍历示例,并说明集合与字典因无序性不支持索引访问的限制。
本文分析Tensorflow训练过程中因重复加载图结构导致速度变慢的原因,并提供两种解决方案:将模型结构载入全局或置于会话外部。通过对比测试数据,展示优化后训练时间的均衡性,帮助开发者避免图爆炸问题,提升训练效率。
本文介绍如何利用Python实现IP地址的包含关系判断。通过自定义函数将不同格式的IP地址(如标准IP、范围IP、CIDR等)统一转换为十进制数值范围,进而通过数值比较判断两个IP地址之间是否存在包含关系,解决了标准库在某些场景下的局限性。
针对Tensorflow不支持Python 3.7的问题,本文提供将Python降级至3.6的完整解决方案。内容涵盖使用Homebrew移除现有版本并通过指定公式安装3.6.5,以及利用Conda直接安装指定版本的命令。适用于Mac用户解决环境兼容性问题,确保开发环境稳定运行。
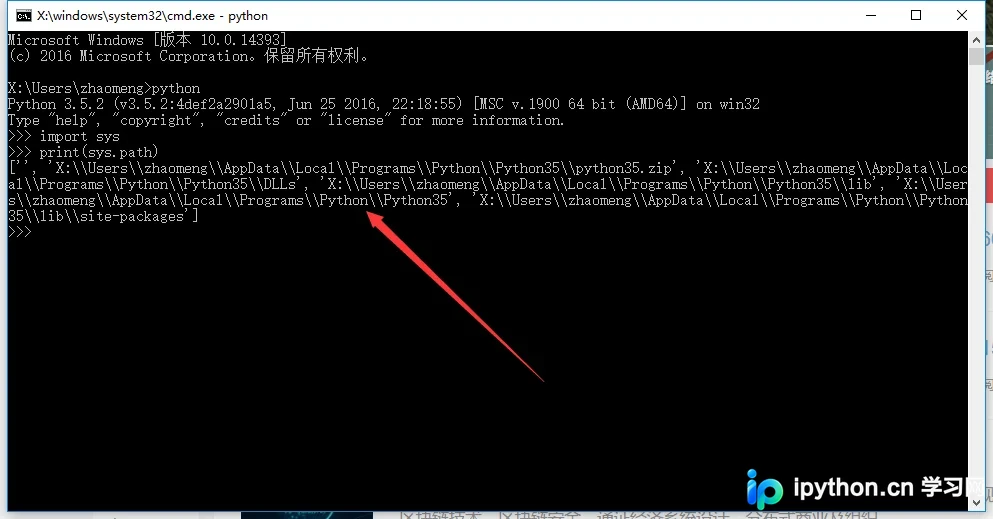
本文介绍了两种查找Python安装路径的方法。第一种是通过系统全局搜索,虽准确但耗时。第二种推荐在CMD中输入python,随后执行import sys和print(sys.path),从输出列表中定位安装路径,操作更便捷高效。