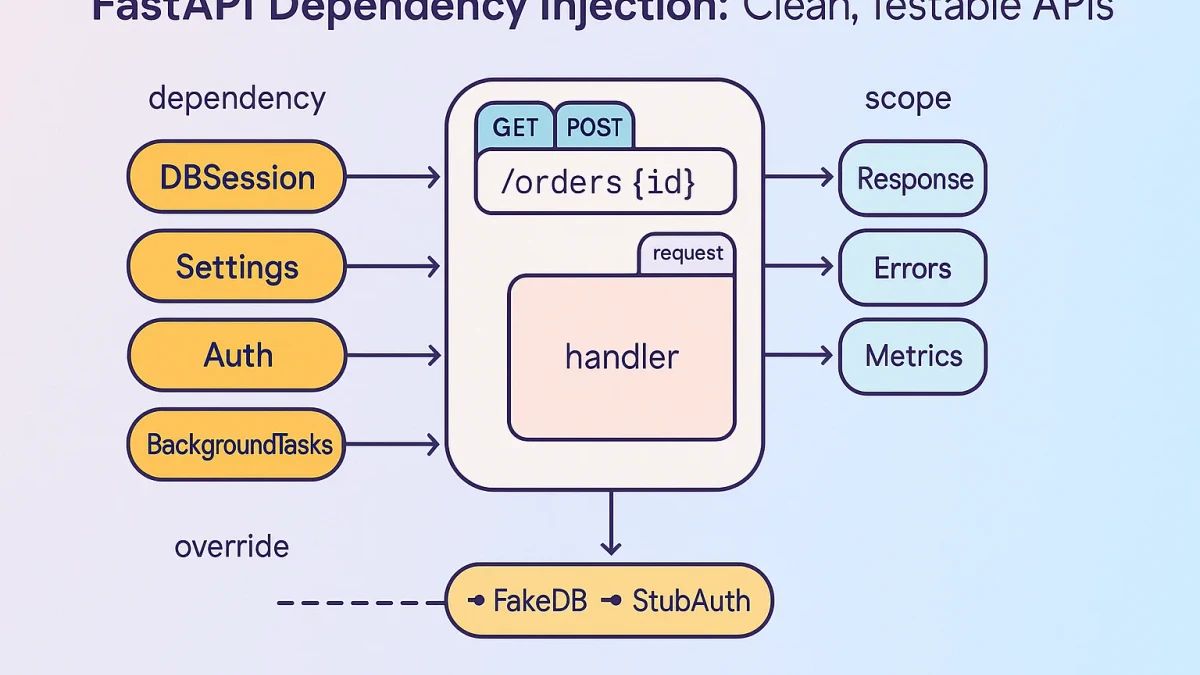
详解pandas如何去掉、过滤数据集中的某些值或者某些行?
本文详细介绍在pandas中如何高效过滤数据集中的特定值或范围。通过isin()方法结合逻辑非操作,可精确剔除指定列的特定数值;利用逻辑与(&)运算符,能实现多列多条件的组合过滤。同时涵盖基于数值范围的筛选技巧,帮助开发者快速完成数据清洗任务。
2026-10-13
11

本文详细介绍在pandas中如何高效过滤数据集中的特定值或范围。通过isin()方法结合逻辑非操作,可精确剔除指定列的特定数值;利用逻辑与(&)运算符,能实现多列多条件的组合过滤。同时涵盖基于数值范围的筛选技巧,帮助开发者快速完成数据清洗任务。
本文深入解析Python内置函数locals的机制,展示如何利用其动态创建和访问变量的特性解决复杂数据处理问题。通过一个按tid排序且相邻元素不重复的列表重组案例,结合局部与全局命名空间原理,详细演示了动态生成变量及操作列表的具体实现代码与逻辑。
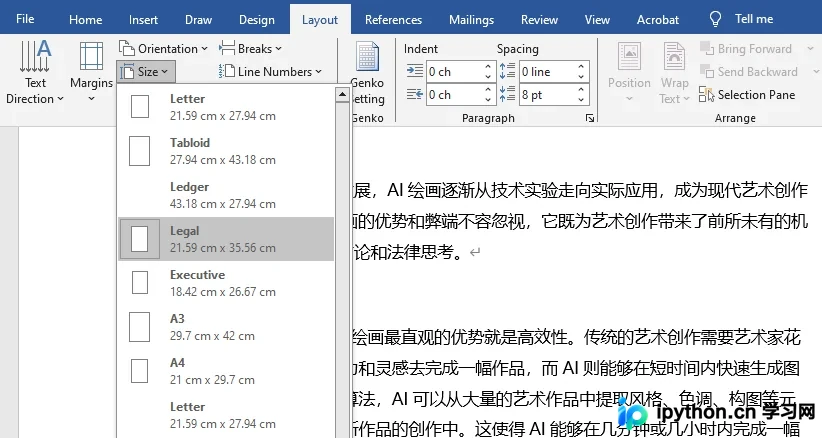
处理跨国业务或海外法务文件时,常需将默认A4文档转换为北美常用的Legal纸张(8.5×14英寸)。本文将解析三种国际纸张的尺寸差异,演示如何使用Spire.Doc与Spire.PDF组件编写Python脚本,批量调整Word分节页面大小,并利用模板布局技术对PDF进行无损等比缩放。文末汇总python-docx与PyPDF2等主流开源方案的配置参数,提供可直接复用的办公自动化排版方案。
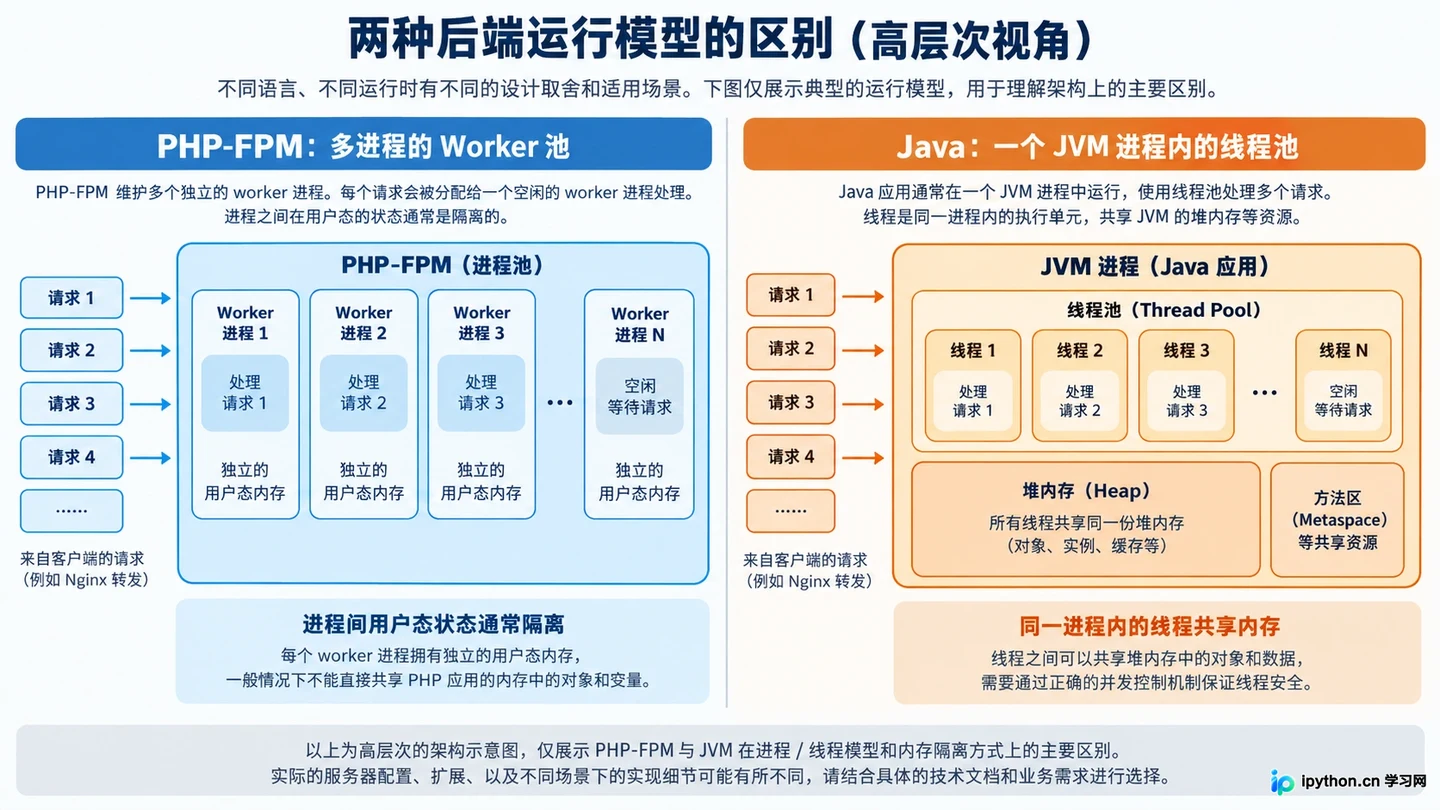
本文从部署成本、并发模型和生态成熟度三个维度,对比PHP、Python与Java在后端开发中的实际表现。不罗列语法差异,而是聚焦于“为什么选它”以及“选了之后会遇到什么坑”,为技术决策提供基于因果关系的选型依据。
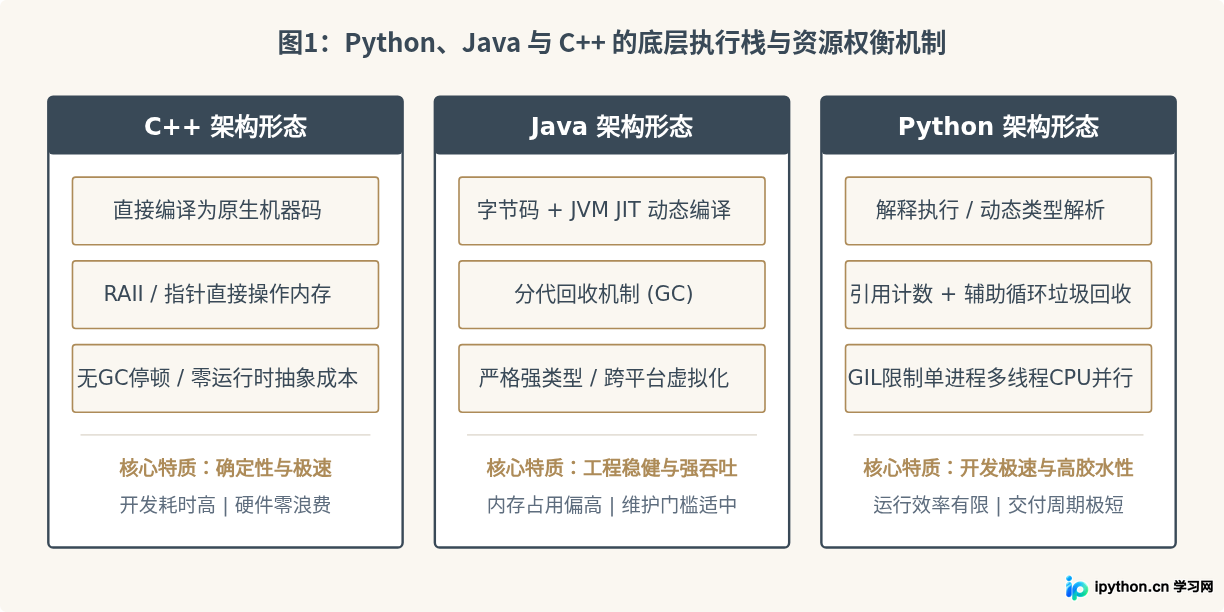
深入对比Python、Java与C++在实际工程项目中的应用场景区别,从语言底层运行机制、开发效率、资源开销与并发模型等维度解析选型依据。
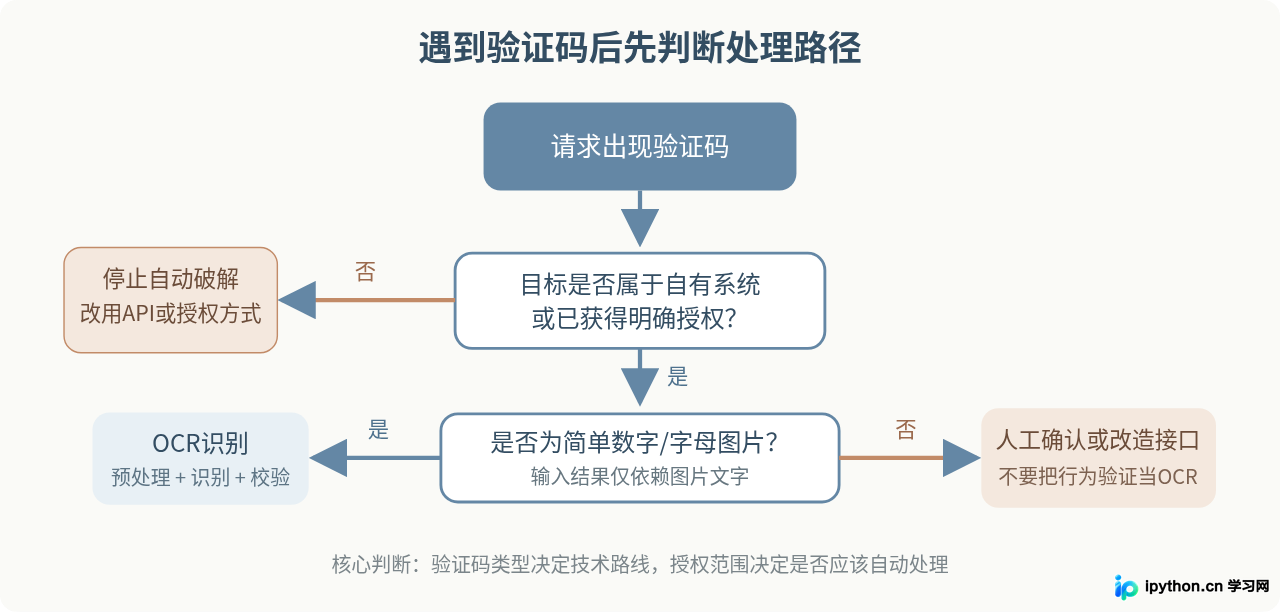
讲解Python爬虫遇到验证码时的处理思路,包括验证码类型判断、OCR识别、图像预处理、人工打码平台接口设计、失败重试和合规边界,并提供可运行的Python示例。
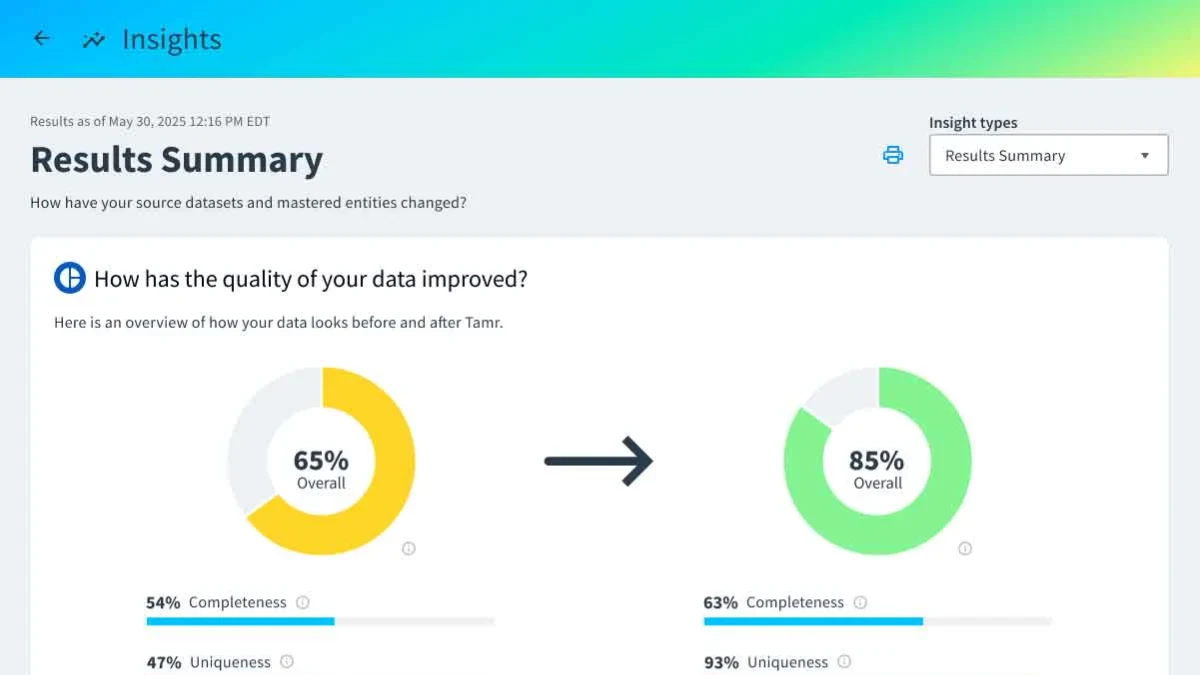
以一份典型业务数据为例,按照“数据概览→缺失值处理→重复值处理→异常值识别与处理→结果验证”的流程,系统讲清 Pandas 数据清洗中最常见的问题、核心操作与容易踩坑的地方。重点覆盖 isna()/isnull()、dropna()/fillna()、duplicated()/drop_duplicates(),以及基于统计规则识别异常值,并强调清洗前后数据量与关键指标的验证。
先澄清一个最容易踩坑的误区:中文书名相同的《Python核心编程(第2版)》与《Python核心编程(第3版)》并不是简单的新旧版本关系。第2版对应 Core Python Programming 的第一卷,而第3版对应拆分后的应用编程部分,英文名为 Core Python Applications Programming,内容重点明显不同。本文应围绕“先辨版本、再比内容、最后按学习目标选书”的路径展开。
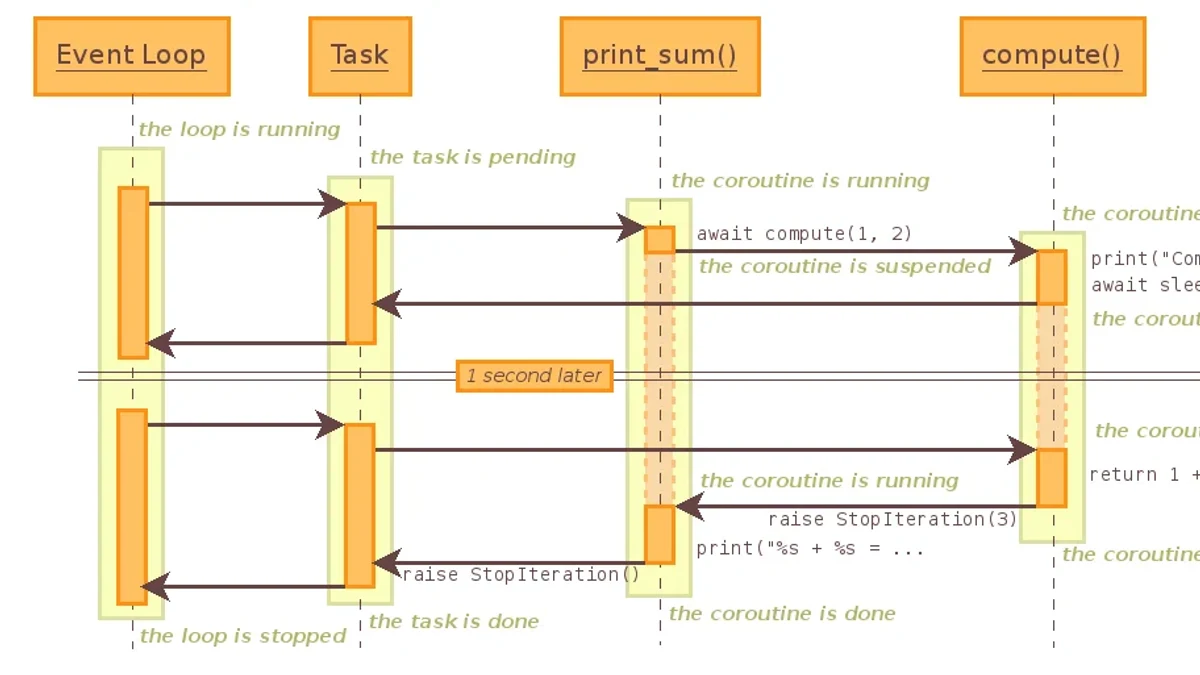
从异步任务中的上下文隔离问题出发,介绍 Python contextvars 的核心概念、基本操作与异步场景实践,并通过可验证示例说明它与全局变量、threading.local 的区别,同时总结常见使用误区。
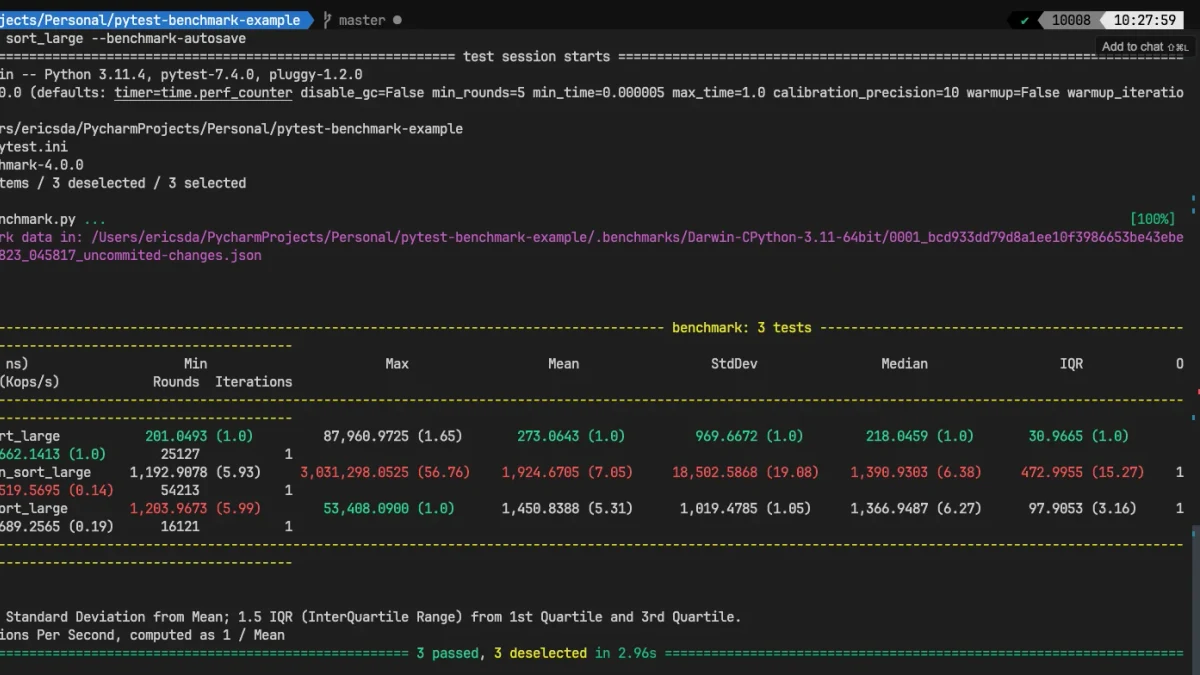
介绍如何使用pytest-benchmark为Python代码建立可重复的性能基准,通过基准测试、对比分析和结果验证定位性能差异,同时避免测试环境、数据规模和统计方式带来的误判。
从依赖注入的核心概念入手,掌握 FastAPI 中 Depends 的声明、依赖复用、嵌套依赖与资源管理,并通过实际接口验证执行流程,同时覆盖常见配置与设计误区。