

Python多重继承与菱形继承详解:MRO机制与super()用法
本文深入解析Python中的多重继承与菱形继承问题,通过实例展示经典调用顺序导致的父类重复执行现象。重点介绍MRO(方法解析顺序)及C3算法如何确保每个类仅被调用一次,并演示如何利用super()函数优化代码结构,实现广度优先的清晰调用链,适用于Python3新式类场景。
2026-10-13
9

本文深入解析Python中的多重继承与菱形继承问题,通过实例展示经典调用顺序导致的父类重复执行现象。重点介绍MRO(方法解析顺序)及C3算法如何确保每个类仅被调用一次,并演示如何利用super()函数优化代码结构,实现广度优先的清晰调用链,适用于Python3新式类场景。
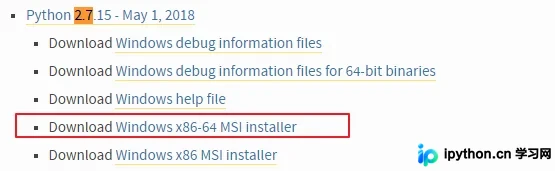
本文详细介绍在Windows 10 64位系统中安装Python 2.7及Pygame库的完整流程。内容涵盖Python环境变量的手动配置、pip工具的验证与安装、Pygame特定版本文件的下载与本地安装,以及如何在PyCharm Community 2018中为项目正确配置第三方库依赖。
本文详细梳理了 TensorFlow 从旧版升级至 1.0 版本时的 API 命名变更。重点涵盖全局变量、局部变量及初始化函数的重命名规则,Summary 系列函数的结构调整,以及 sub、mul、div 等基础数值计算函数的新命名方式。帮助开发者快速适配新版本,避免代码报错。
本文详细介绍在 Django 项目中添加日志功能的方法。通过配置 settings.py 中的 LOGGING 字典,定义格式化器、处理器及日志级别,实现控制台输出与文件轮转存储。结合视图函数中的手动异常捕获,利用 logging.getLogger 获取指定 logger 并记录错误信息,确保应用运行状态可追溯。
本文详细介绍在Scrapy框架中实现网站登录的三种常见方式。第一种通过预置Cookies直接访问;第二种手动解析网页获取隐藏字段后发送POST请求;第三种利用FormRequest.from_response自动处理表单提交。文章提供完整代码示例,帮助开发者掌握不同场景下的登录策略。
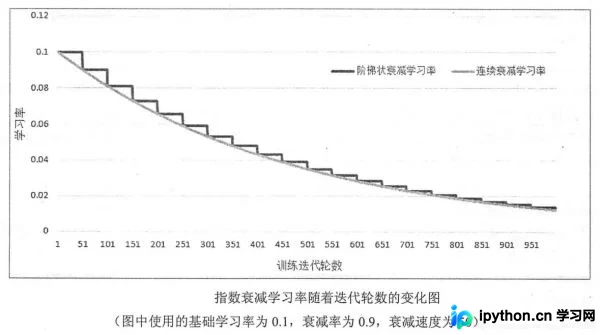
本文介绍TensorFlow中tf.train.exponential_decay函数的用法。该函数通过设置初始学习率、衰减系数和衰减步数,实现学习率的指数级下降。文章详细解析了staircase参数对连续衰减与阶梯状衰减的影响,并展示了global_step作为变量自动更新和作为占位符手动feed的两种典型应用形态,帮助开发者优化模型训练过程。
本文详解TensorFlow默认占用全部GPU显存的机制及其潜在问题。重点介绍两种核心配置:allow_growth实现内存按需动态分配,避免初始过度占用;per_process_gpu_memory_fraction通过设定比例固定显存上限。通过ConfigProto配置,可有效缓解显存碎片并提升多进程环境下的资源利用率,适用于模型训练与部署场景。
本文使用Python构建SIR传染病模型,通过手工提取数据并采用穷举法估算感染系数β和初始易感人数S0,结合已知恢复率γ进行疫情走势模拟。结果显示最大感染人数约2.3万人,峰值出现在2月12日左右。文章强调此为个人技术探索,非专业流行病学预测。
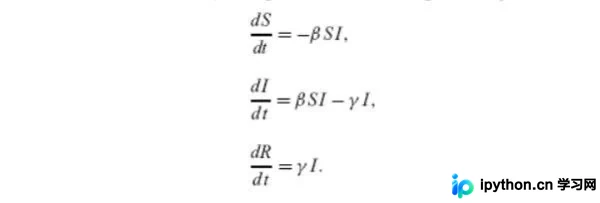
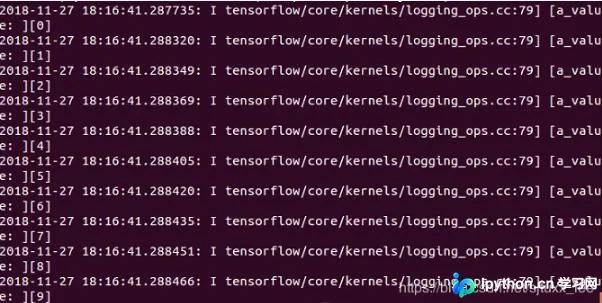
TensorFlow基于静态图机制,直接print无法查看张量数值。本文详解tfPrint函数的参数用法,重点解析如何在未返回主函数的内部函数中利用数据流机制输出中间变量。通过对比不同代码结构,阐明tfPrint节点被触发执行的条件:只有当数据流经该节点时才会打印,且受first_n和summarize参数限制。
本文介绍如何使用Python拼接FLV视频。首先解析FLV文件头与Tag结构,包括Header的9字节定义及Script、Audio、Video Tag的组成。接着通过Python代码实现读取、修改时间戳并写入新文件,最终完成多个FLV文件的合并,并测试了拼接性能与潜在问题。
本文详细介绍 TensorFlow 2.0 中张量的合并与分割操作。通过 tf.concat 实现沿指定轴合并张量,利用 tf.stack 创建新维度进行数据堆叠,并借助 tf.unstack 和 tf.split 执行解堆叠与分割。文章结合具体代码示例,解析各函数的参数设置、形状变化及适用场景,帮助开发者高效处理多维数据。
本文详细解析使用Docker部署Python爬虫项目的完整步骤。内容涵盖Docker环境安装、基础镜像拉取、Python运行环境编译、依赖库处理、Dockerfile编写规范、镜像构建命令及容器启动参数配置,帮助开发者实现爬虫项目的标准化与自动化部署。