

Python实现按逗号分隔列表的方法
本文介绍Python中将列表元素转换为以逗号分隔的字符串的两种常用方法。第一种通过手动遍历列表并逐个拼接字符串实现;第二种利用内置的join函数结合生成器表达式,代码更简洁高效。文章还简要提及了字符串替换的相关注意事项,供开发者参考。
2026-10-13
20

本文介绍Python中将列表元素转换为以逗号分隔的字符串的两种常用方法。第一种通过手动遍历列表并逐个拼接字符串实现;第二种利用内置的join函数结合生成器表达式,代码更简洁高效。文章还简要提及了字符串替换的相关注意事项,供开发者参考。
本文介绍在Python中如何高效拼接文件路径。通过导入os模块,利用os.path.join函数将基础目录与文件名组合,生成正确的文件路径。该方法适用于获取当前文件所在目录及拼接子文件路径的场景,是Python文件操作中的常用技巧。
本文介绍在Windows系统中运行Python脚本时隐藏DOS窗口的两种方法。一是直接调用pythonw.exe执行脚本,二是将文件后缀改为.pyw以关联pythonw解析器。需注意pythonw会屏蔽标准输入输出,且.pyw格式仅适用于Windows版Python。
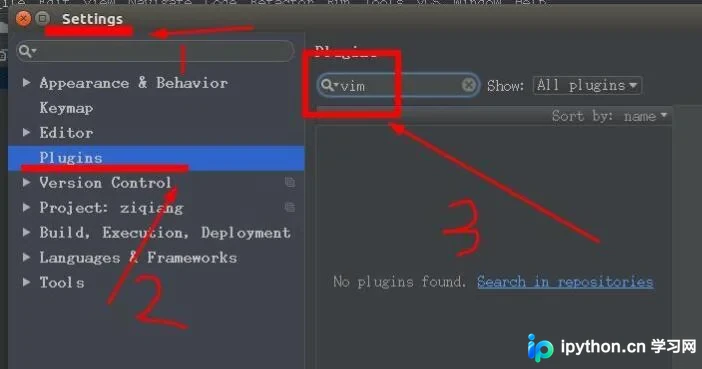
本文介绍如何解决PyCharm中因安装Vim插件导致的快捷键失效问题。当Ctrl+X和Backspace无法使用时,可通过检查Insert键状态或直接在设置中卸载Vim插件并重启软件来恢复快捷键功能。
本文介绍在 Python 3.6 环境下如何使用 pickle 模块对 Class 对象进行序列化和反序列化操作。通过具体代码示例,展示了从导入模块到执行 dumps 和 loads 函数的完整流程,帮助开发者掌握对象持久化的基本技巧。
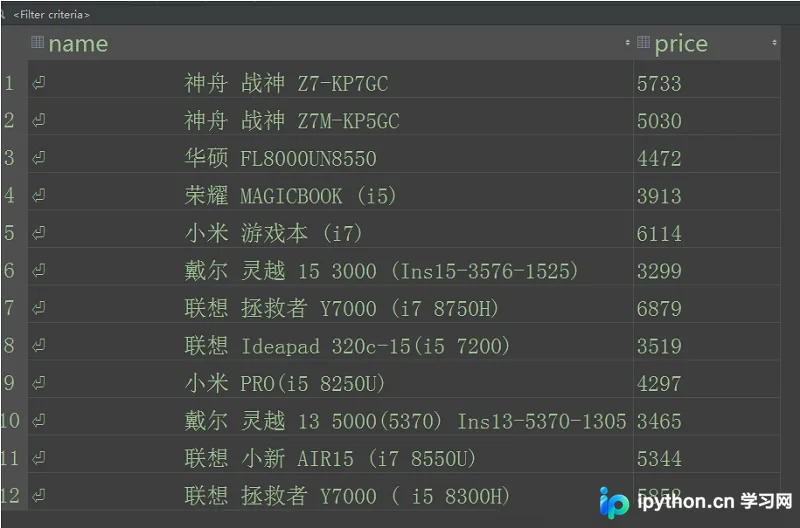
本文介绍如何使用Scrapy框架结合PhantomJS处理动态加载网页数据。通过配置Selenium中间件拦截请求,利用JavaScript渲染页面源码,并在Spider中解析HTML提取商品信息。随后通过Item定义数据结构,利用Pipeline将数据写入SQLite数据库,完整演示从配置到入库的技术流程。
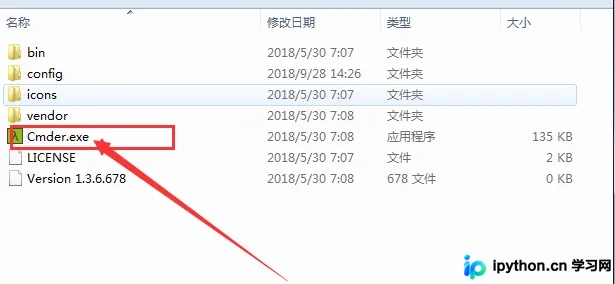
本文详细介绍如何在Windows下的Cmder终端中创建Python虚拟环境,并通过pip安装IPython。同时演示了如何进入MySQL服务器目录,使用命令行工具连接数据库,为Python开发环境配置提供参考。
本文详细解析Python中psutil库的核心用法,涵盖CPU、内存、磁盘IO、网络流量及系统登录用户等关键指标获取方法。同时深入讲解进程管理,包括PID列表获取、进程对象实例化及popen类对子进程的控制与通信,助力运维开发高效实现系统资源监控。
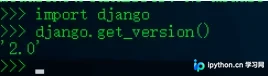
本文详细讲解在Windows系统中使用Python安装Django的两种主要方式。首先介绍如何下载Python3.6并配置环境变量,随后通过Git克隆Django源码进行编译安装,最后提供使用pip直接安装的便捷方案。内容涵盖环境依赖、具体操作步骤及版本验证方法,帮助开发者顺利完成Django开发环境的搭建。
本文介绍基于前作完善的Python学生信息管理系统完整版。新增输入错误及无数据查询等异常处理机制,并实现文件读写功能,重点解析文本字符串的拆解与重组逻辑。系统提供添加、显示、删除、修改及按成绩/年龄排序等十项核心功能,支持信息保存至students.txt及从文件读取,适合Python初学者参考。
本文详细介绍Python中os模块处理目录的核心方法。涵盖使用os.mkdir创建单级目录、os.makedirs创建多级目录,以及利用os.rmdir和os.removedirs删除目录的区别。同时解析os.walk遍历目录结构及os.path判断路径类型的用法,提供具体代码示例与注意事项,帮助开发者高效管理文件系统。
本文介绍在 Django 中将 Model 序列化为 JSON 的自定义方法。针对官方序列化器格式复杂、对 List 和外键支持不佳等问题,通过继承 django.db.models.Model 并声明为 abstract,实现 getDict 和 toJSON 方法。该方法利用反射处理基本类型、日期及 ManyToMany 字段,生成简洁的 JSON 结构,并提供完整代码示例与使用指南。