

Python 公共方法汇总解析
本文系统梳理 Python 中的公共方法,涵盖计算长度、索引取值、切片操作、元素删除与修改,以及连续数字生成和字符串连接。通过具体代码示例,解析各方法的适用场景与不可变类型的限制,帮助开发者高效掌握 Python 基础操作。
2026-10-12
21

本文系统梳理 Python 中的公共方法,涵盖计算长度、索引取值、切片操作、元素删除与修改,以及连续数字生成和字符串连接。通过具体代码示例,解析各方法的适用场景与不可变类型的限制,帮助开发者高效掌握 Python 基础操作。
在Python数据分析中,快速定位包含空值(NaN)的行是数据清洗的关键步骤。本文介绍利用pandas库的.isnull()结合.any()方法,通过转置操作高效筛选出含有缺失值的DataFrame行,并附带完整的代码示例与结果解析。
本文详细介绍 Python 中两种主要的测试实现方法:doctest 和 unittest。doctest 通过文档字符串嵌入测试,适合简单函数验证;unittest 基于 TestCase 和 TestSuite,支持更复杂的测试流程,包括 setUp/teardown 预处理及断言方法。通过具体代码示例,展示如何构造测试集并执行测试,帮助开发者快速掌握 Python 单元测试的核心技巧。
本文详细介绍Python内置测试框架Unittest的使用流程。涵盖环境配置、测试类与方法的编写规范,解析setUp等生命周期方法的作用,并深入讲解TestCase、TestSuite、TestLoader及TestRunner等核心组件。此外,提供通过TextTestRunner生成TXT报告和使用HTMLTestRunner生成HTML报告的完整示例,帮助开发者快速掌握自动化测试实践。
本文介绍如何在Django项目中利用itsdangerous库生成加密的激活链接,并通过SMTP服务发送验证邮件。通过配置settings.py及编写RegisterView视图类,实现用户注册后发送包含加密Token的邮件,用户点击链接后系统解密验证并激活账户,确保链接安全与时效性。
在Django项目中调用基于TensorFlow的Keras模型时,常遇到Tensor不在当前图的ValueError。本文介绍通过导入keras模块并在加载模型后执行clear_session()及预测测试来重置计算图,从而解决该错误。
本文详解Python中两种主流数据归一化方法:Min-Max标准化与Z-Score标准化。通过sklearn.preprocessing库的MinMaxScaler实现[0,1]区间缩放,以及基于均值和标准差的Z-Score转换。文章提供完整代码示例,解析公式原理及适用场景,帮助开发者高效进行数据预处理。
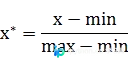
本文探讨Django中解决高并发下单导致库存异常的方案。通过对比悲观锁(select_for_update)与乐观锁(版本号或库存条件更新)机制,并结合Celery任务队列串行化处理,提供具体的代码实现与操作建议,帮助开发者有效管理资源竞争。
本文介绍如何使用Python Pandas库对数据集进行随机抽样。通过DataFrame.sample()方法,可以指定抽取行数(n)、比例(frac)、是否放回(replace)及权重(weights)。此外,还探讨了利用Numpy进行索引抽样的替代方案,适用于不同场景下的数据采样需求。
本文介绍在Python中利用正则表达式过滤中英文标点符号的方法。通过定义不同的正则规则r1至r4,演示如何去除文本中的特殊字符、括号及内容。代码示例展示了针对混合中英文标点及符号的过滤策略,适用于文本预处理场景。
本文详细介绍在Mac OS环境下使用Python3和Anaconda进行LBP(局部二值模式)特征提取的完整步骤。内容涵盖环境配置、图像读取、灰度转换、LBP算法处理及边缘提取,通过OpenCV与Skimage库配合,展示从原图到特征图的转换过程,为纹理特征研究提供实用代码示例。
本文介绍在Python中处理多层嵌套字典时,如何高效获取指定Key对应的Value。由于标准字典方法无法直接应对复杂嵌套结构,文章提供了一段自定义递归函数代码,通过遍历字典项并判断值类型是否为字典,实现深层Key的精准定位与返回。