

利用Streamlit与Python构建交互式Web数据可视化应用
本文详细介绍如何使用Python的Streamlit库快速构建交互式Web可视化页面。通过结合pandas处理Excel数据、plotly绘制动态图表,实现了基于滑动条和复选框的数据过滤与实时展示。教程涵盖环境配置、代码实现及本地部署步骤,帮助开发者轻松创建无需前端知识的数据应用。
2026-10-14
21

本文详细介绍如何使用Python的Streamlit库快速构建交互式Web可视化页面。通过结合pandas处理Excel数据、plotly绘制动态图表,实现了基于滑动条和复选框的数据过滤与实时展示。教程涵盖环境配置、代码实现及本地部署步骤,帮助开发者轻松创建无需前端知识的数据应用。
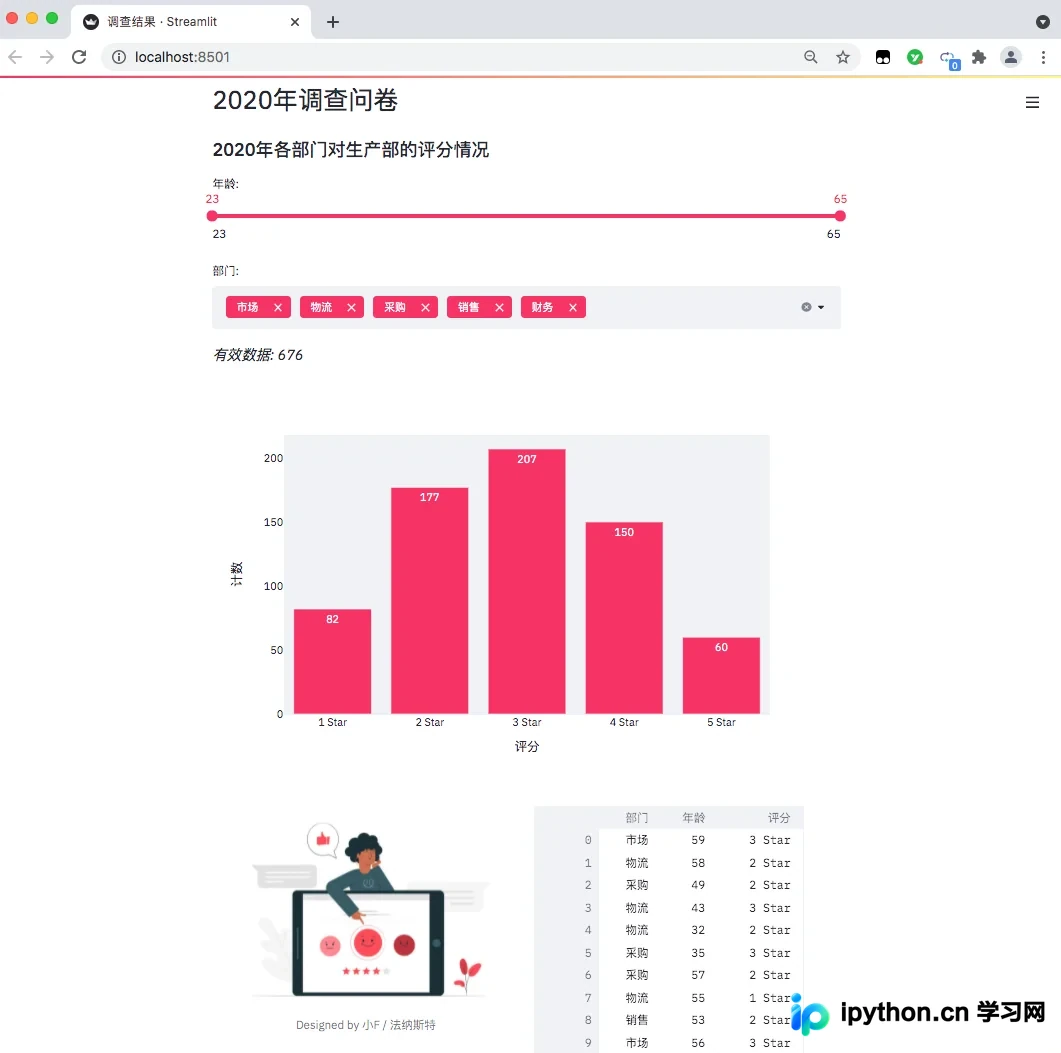
本文深入探讨Python3中读取文件指定行的三种主流方案。针对大文件场景,对比了基于readline的逐行遍历、linecache模块以及调用系统sed命令的执行效率。测试显示,读取5000万行时,sed方案耗时仅约2.5秒,显著优于纯Python实现的10秒以上耗时,为高性能数据处理提供了实用参考。
本文详细解析Python Pandas中duplicated()与drop_duplicates()函数的核心区别。通过生成测试数据,演示如何判断行重复及删除重复值。重点说明duplicated()返回重复出现的行(仅显示n-1条),而drop_duplicates()直接返回去重后的完整数据框,默认保留第一条记录。
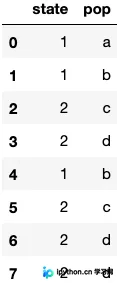
本文基于 Python 3.6 及 Anaconda 环境,详细解析 matplotlib 库中 plt.bar() 函数的各项参数。通过加载 pandas 数据并逐步设置颜色、宽度、标签及字体等属性,展示如何绘制专业的柱状图。内容涵盖基础库导入、数据预处理及图表美化技巧,适合需要掌握数据可视化基础的用户参考。
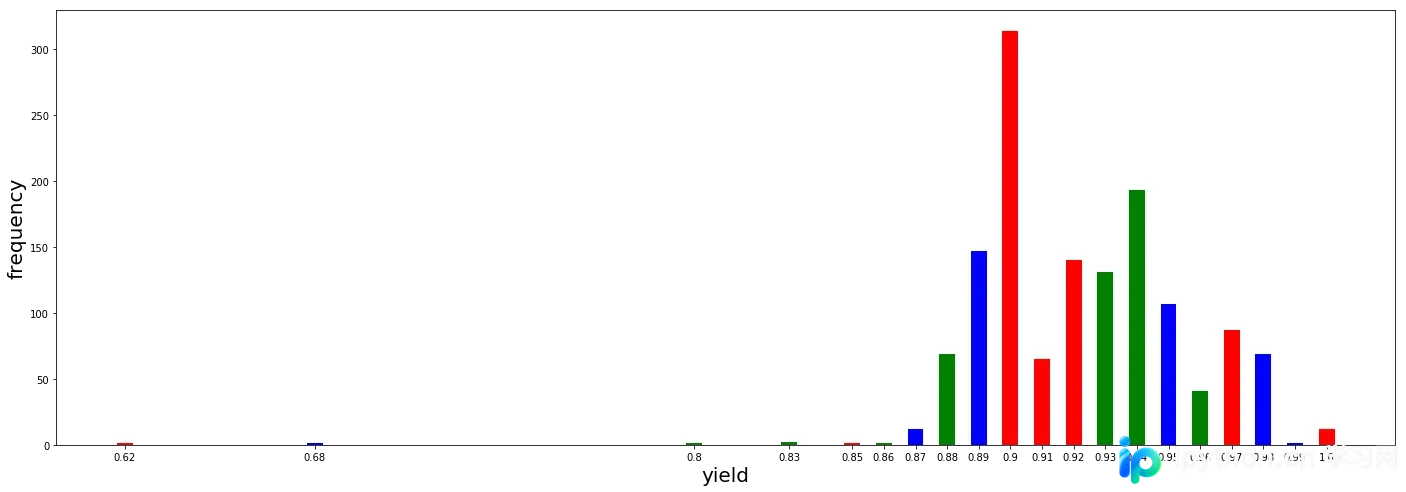
本文介绍Python中判断集合超集的两种主要方式:使用>=运算符和调用issuperset()方法。通过具体代码实例,演示如何验证一个集合是否包含另一个集合的所有元素,并扩展讲解了集合的交集、并集、差集及对称差集等常见运算操作,帮助开发者高效处理集合比较逻辑。
本文系统梳理Python机器学习的基础知识,涵盖其作为人工智能核心学科的定义与跨学科属性。详细解析了监督、半监督、无监督及强化学习等分类方式,并列举回归、聚类、决策树等主流算法。同时探讨了面向任务、认知模型与理论分析三大研究方向,为初学者构建完整的知识框架。
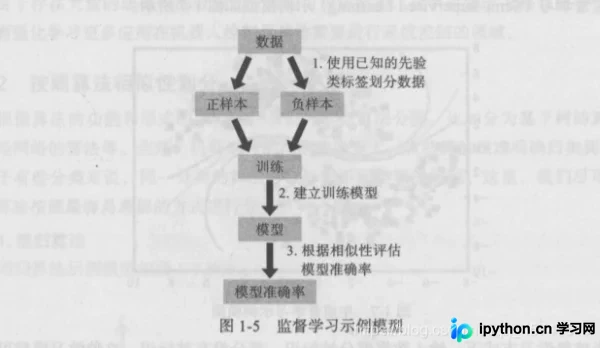
本文详细介绍如何在matplotlib中使用subplots函数实现子图间的坐标轴共享。通过解析sharex和sharey参数,演示如何创建共享X轴、Y轴或同时共享两者的多子图图表,并包含调整子图间距及混合绘图类型的实际代码示例。
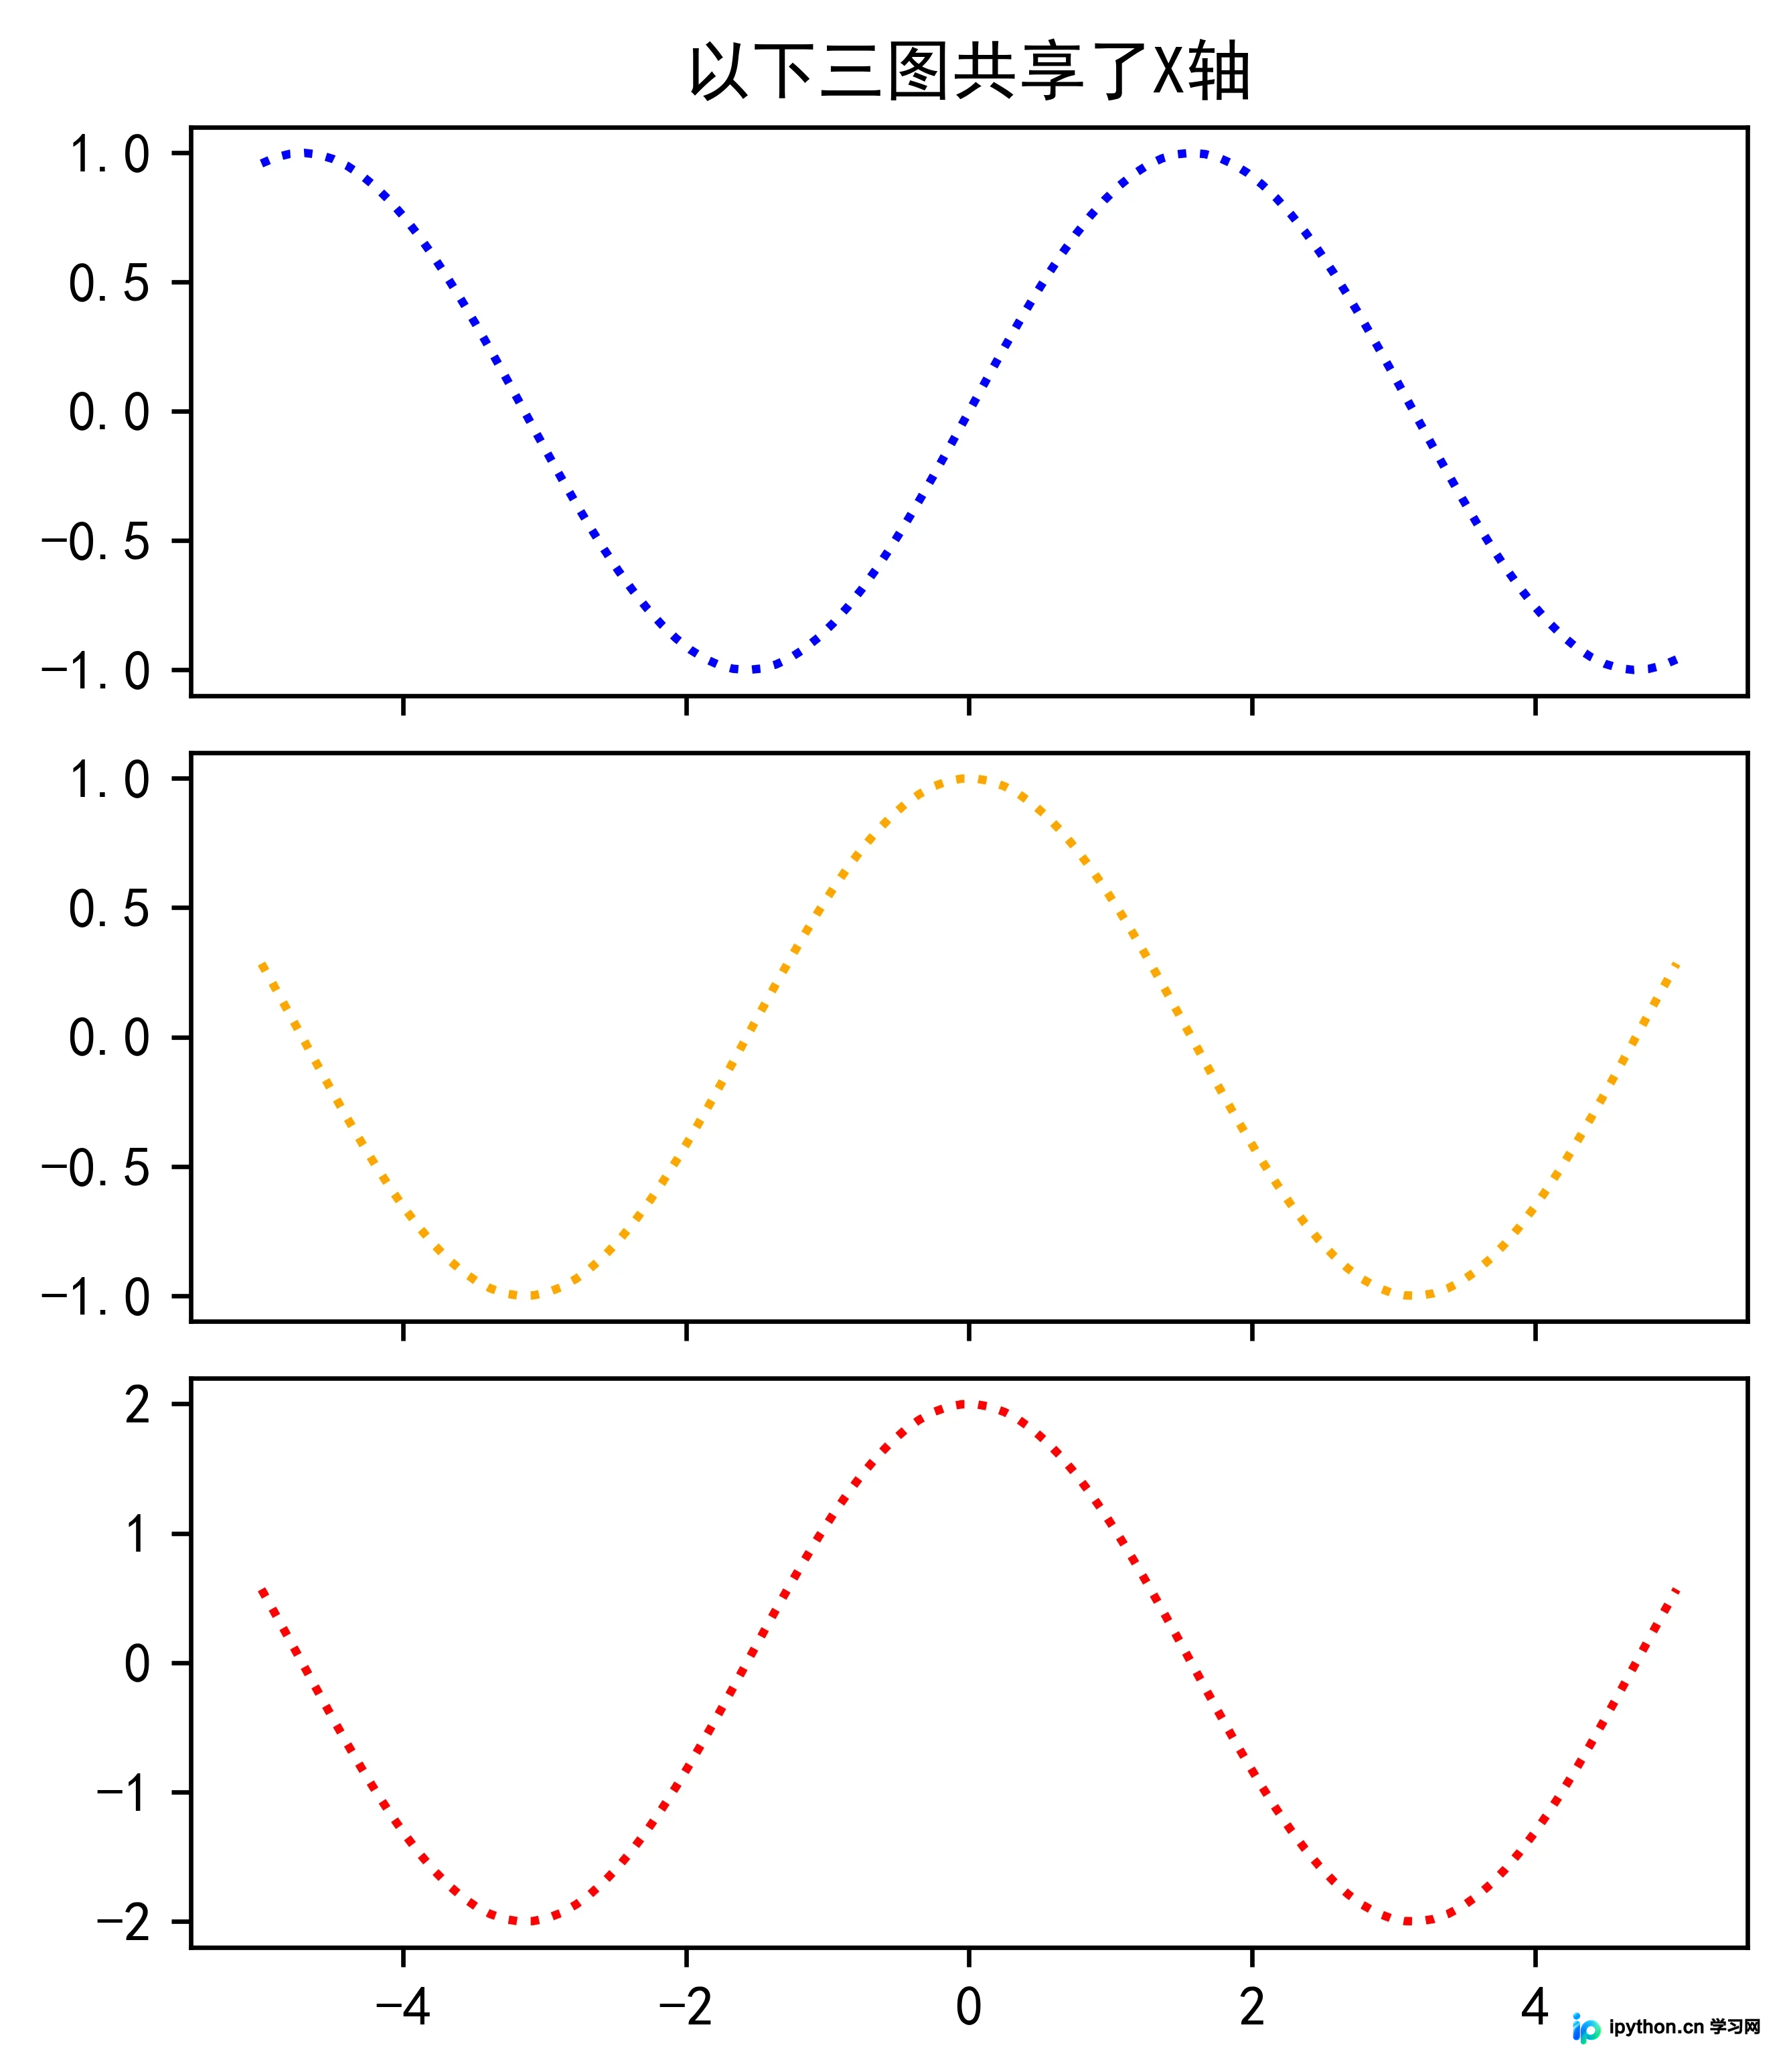
本文深入解析NumPy数组的移动窗口技术。首先对比循环与向量化方法的性能差异,展示如何利用切片偏移实现高效计算。随后重点介绍as_strided函数的底层机制,通过控制shape和strides生成数据视图,实现十万倍的速度提升,同时警示内存越界风险。
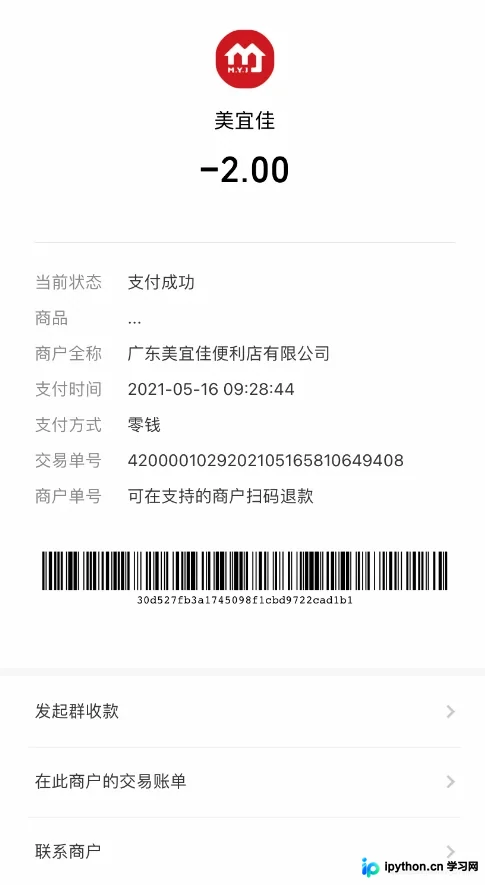
本文介绍如何使用Python的OpenCV库进行图像局部截取,并结合百度AI开放平台的文字识别API,实现从收据或发票图片中自动提取时间、商家、商品、价格及单号等关键信息。通过代码示例展示图像预处理、API调用及Pandas数据导出至Excel的完整流程,旨在提升财务或行政工作的数据处理效率。
本文详解Python中multiprocessing模块的Process类用法,涵盖进程创建、target与args参数传递、多进程并发启动及join同步阻塞机制。重点解析start异步与join同步的区别,以及Windows平台下必须使用if __name__ == '__main__':避免无限递归创建进程的原理与最佳实践。
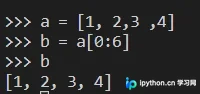
本文详细解析Python列表切片操作中索引超出范围的安全处理方法,通过添加条件判断避免IndexError报错。同时系统介绍切片的基本语法,包括首尾索引省略规则及遍历方式,并结合分页显示实例说明实际应用。
本文详细讲解如何使用Django框架从零开始构建一个最简Web应用程序。内容涵盖使用django-admin创建项目、通过startapp生成应用模块、配置views视图函数与URL路由、设置模板路径以及最终运行调试的全过程。适合Python初学者快速掌握Django基础开发流程。