

Python神经网络入门:使用Keras进行回归分析
本文介绍如何利用Python中的Keras库构建神经网络进行回归运算。Keras作为Tensorflow的高阶API,通过Sequential序贯模型和Dense全连接层简化模型构建。文章详细解析了model.compile中loss函数(如mse)与优化器(如sgd)的配置,并提供了一元线性回归的完整代码示例及运行结果分析。
2026-10-16
13

本文介绍如何利用Python中的Keras库构建神经网络进行回归运算。Keras作为Tensorflow的高阶API,通过Sequential序贯模型和Dense全连接层简化模型构建。文章详细解析了model.compile中loss函数(如mse)与优化器(如sgd)的配置,并提供了一元线性回归的完整代码示例及运行结果分析。
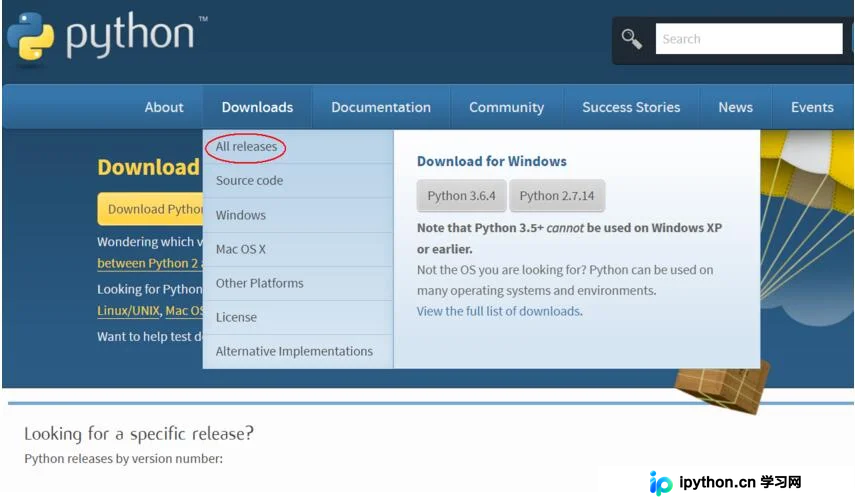
本文详细介绍在Windows系统中安装Python 3.6.4的完整流程,涵盖从下载安装包、指定安装路径到配置系统环境变量的关键步骤。重点讲解如何解决命令行无法识别python命令的问题,通过添加Path和Scripts路径确保Python可执行文件全局可用,最后通过cmd测试验证安装是否成功,为后续开发环境搭建奠定基础。
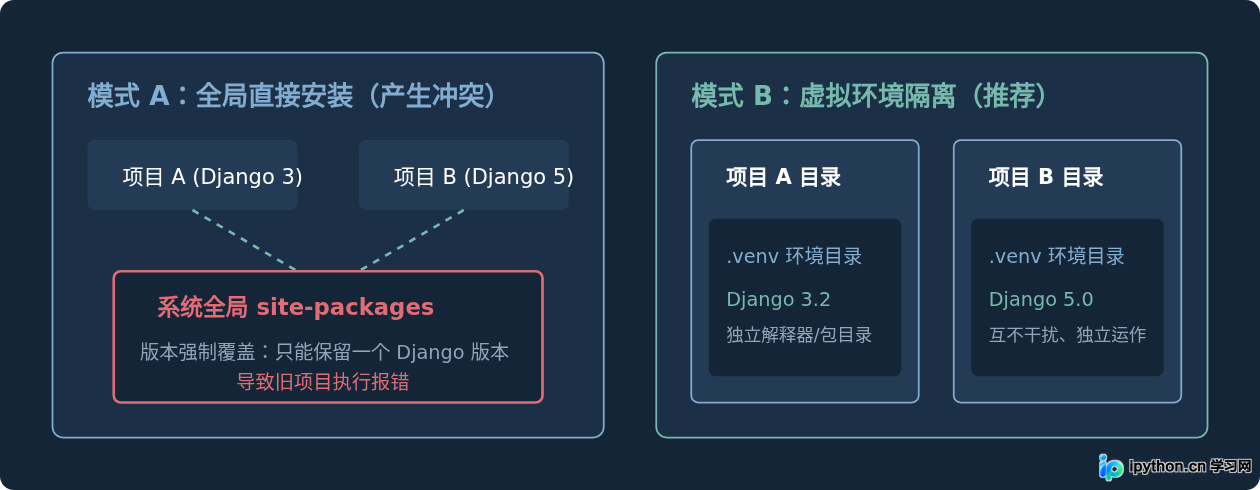
针对初学者的实用指南:系统讲解Python虚拟环境原理、venv生命周期管理、pip依赖安装与导出技巧,彻底解决依赖冲突与多项目管理难题。
本文详解使用PyInstaller将Python脚本打包为EXE文件并隐藏CMD命令窗口的方法。针对打包后隐藏窗口执行CMD命令报错的问题,推荐使用subprocess模块替代os.system。同时提供解决打包后程序一闪而过、文件体积过大、图标不显示等常见问题的具体解决方案,包括修改导入方式和路径处理技巧。

本文深入解析Python Num库中数组形状调整的核心方法,涵盖reshape、resize、flatten、ravel及squeeze函数的具体用法与区别。同时讲解transpose和swapaxes对坐标轴的变换操作,并通过图像质心计算实例展示高效张量运算技巧。
本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
本文详解在Python中读取Word文档内嵌Excel文件的两种方案。第一种利用Windows COM接口调用宏,依赖Office或WPS环境;第二种通过解析Word ZIP结构中的OLE二进制文件,结合olefile与openpyxl实现跨平台快速读取。
本文详细介绍如何利用Flask框架与Ajax技术实现高效的前后端数据通信。内容涵盖字符串传输、JSON格式数据处理以及携带Token的安全交互场景,通过前端JavaScript与后端Python代码的完整示例,展示如何在无需刷新页面的情况下快速响应用户操作,适用于Web应用开发中的数据异步交互需求。
本文解析Python神经网络中特征金字塔(FPN)的核心原理。针对小目标在深层网络中特征易丢失的问题,FPN通过自顶向下的上采样与横向连接,融合高低层语义信息,有效增强小目标检测能力。结合YOLO3等结构示例,阐述其下采样与上采样机制,为模型优化提供理论参考。
本文详细介绍 TensorFlow 中常用的四种激活函数:Sigmoid、Tanh、ReLU 和 Softplus。分析各自的数学特性、优缺点(如梯度消失、计算速度、零均值等),并提供对应的 TensorFlow API 调用示例,帮助开发者根据模型需求选择合适的非线性激活方式。
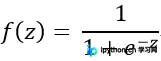
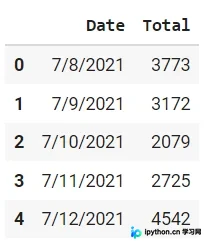
PyCaret最新推出的时间序列模块以低代码方式简化机器学习工作流。通过几行代码即可完成从数据预处理、统计测试、探索性分析到30多种算法模型训练、超参数调优及云部署的全流程。本文详解setup、compare_models、plot_model等核心函数的使用方法,展示如何利用PyCaret加速实验周期并提升预测效率。
本文深入解析Python中subprocess模块的核心原理,指出其本质是通过shell或命令行启动外部程序而非直接调用Python函数。通过具体代码示例,演示了如何利用subprocess.run和Popen进行进程创建、参数传递,并详细讲解了处理二进制输出、解码字符串以及将标准输出重定向至文件的方法,帮助开发者掌握跨语言进程调用的关键技术。