

Selenium与XPath获取指定元素属性的差异解析
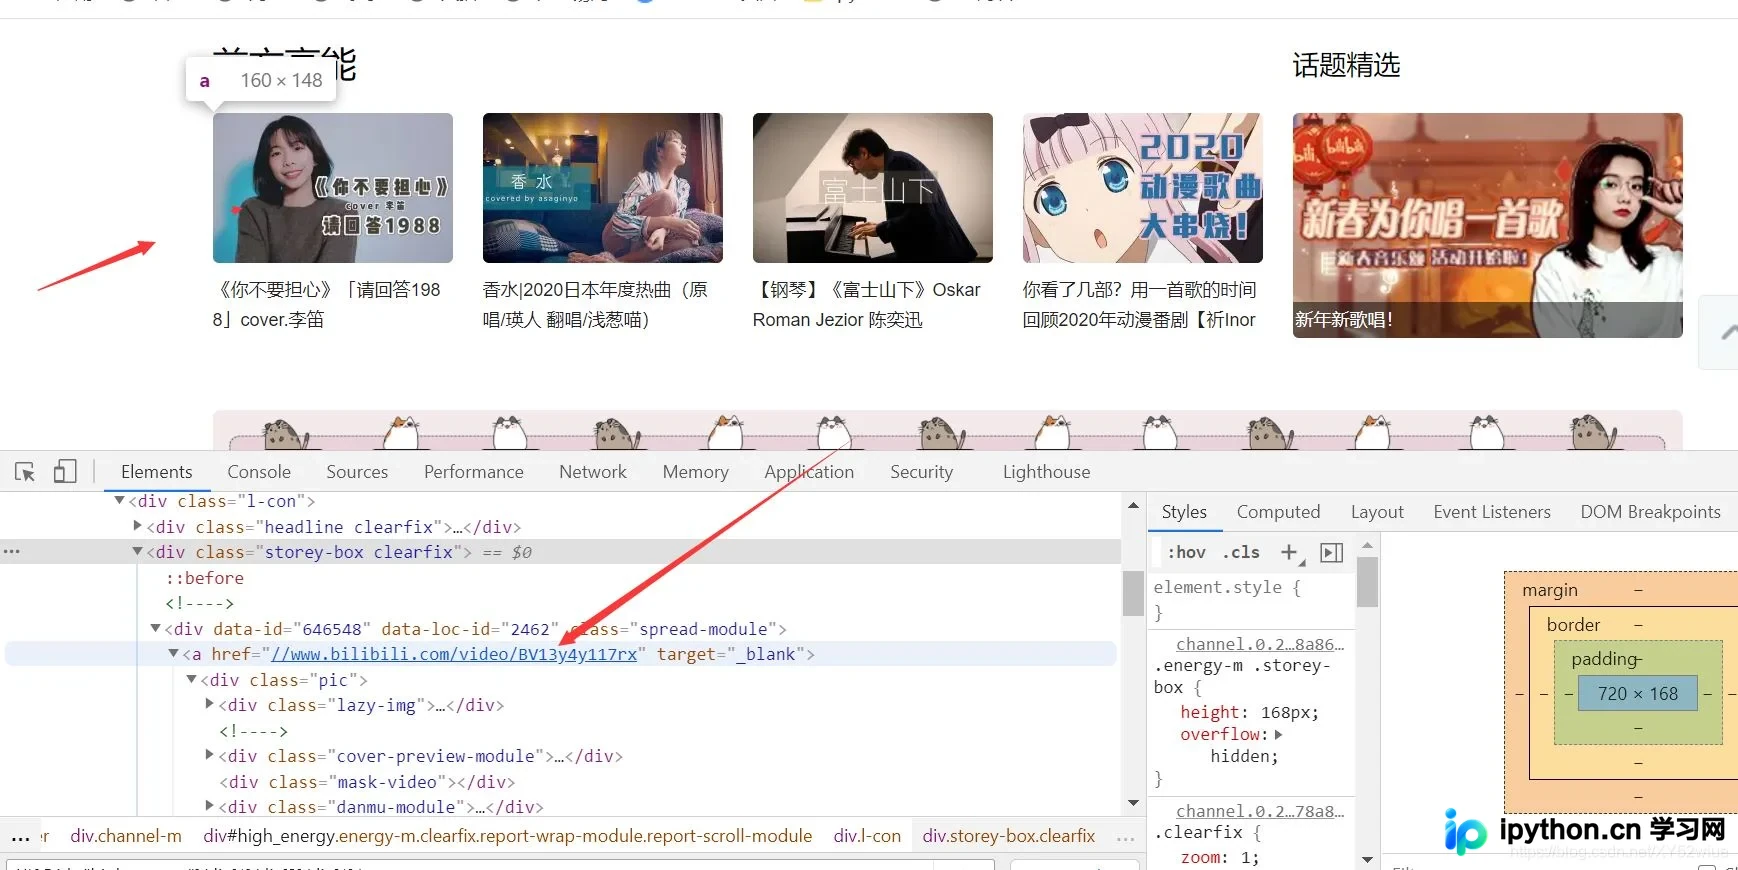
本文通过B站爬虫案例,指出Selenium中使用XPath直接获取属性(如./a/@href)会报错,正确做法是先定位元素节点再调用get_attribute()方法。文章提供了完整的Python代码示例,展示了如何在无头浏览器环境下解析网页数据并提取链接与标题。
2026-10-14
9

本文通过B站爬虫案例,指出Selenium中使用XPath直接获取属性(如./a/@href)会报错,正确做法是先定位元素节点再调用get_attribute()方法。文章提供了完整的Python代码示例,展示了如何在无头浏览器环境下解析网页数据并提取链接与标题。
本文详解Python中利用multiprocessing模块的Process类创建新进程的两种方法:直接实例化与继承子类。重点解析构造参数、run方法重写及__main__判断的必要性,对比两种方式的优劣,推荐直接使用Process类实例化方式。
本文深入解析matplotlib中pyplot命令式绘图与面向对象绘图的内在联系。通过源码分析揭示pyplot如何隐式调用Figure、Axes等对象,并重点介绍_gcf_helpers模块中Gcf单例类在追踪当前活动图像中的作用,阐明pyplot实为面向对象模式的便捷封装。
本文介绍如何使用 Python 生成无限级分类的树状结构。通过递归算法处理数据库中的 parent 字段,构建层级关系。针对递归可能带来的性能问题,引入缓存机制优化执行效率,避免重复计算。文章包含完整代码示例及优化前后的逻辑对比,适用于权限管理、栏目分级等场景。
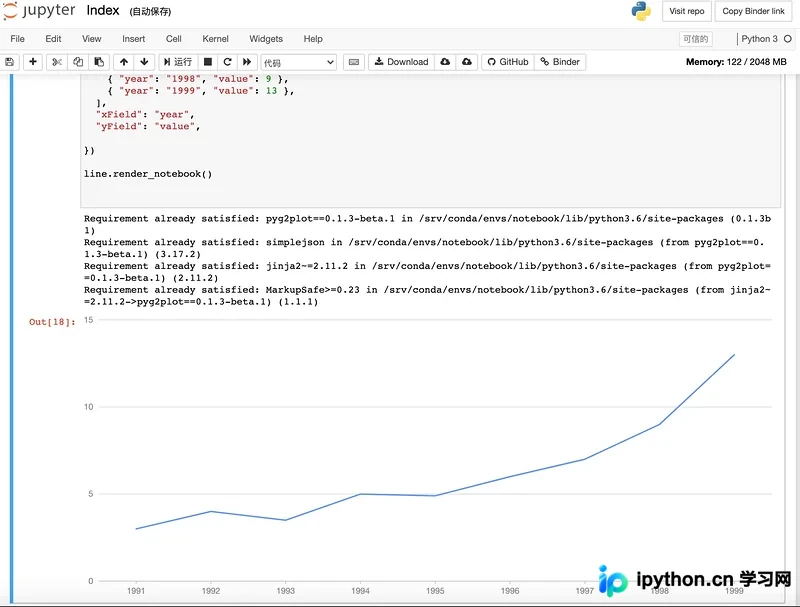
本文介绍 PyG2Plot,一个基于蚂蚁金服 G2Plot 封装的 Python 可视化库。通过该库,开发者可以在 Python 环境中轻松生成高质量统计图表。文章涵盖两种主要使用方式:生成完整 HTML 文件用于服务端直出或嵌入 Excel,以及在 Jupyter Notebook 中直接预览交互图表。核心原理涉及 plot.py 提供 API,engine.py 基于 Jinja2 渲染 HTML。
本文介绍在Python爬虫开发中,如何获取HTTP重定向后的最终URL。通过urllib库的urlopen方法和requests库的get方法,分别展示了两种获取重定向地址的代码实现。重点解析了如何从响应对象中提取最终跳转后的网址,并提供了包含User-Agent请求头设置的示例,帮助开发者解决爬虫追踪真实链接的问题。
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。
本文详解如何在PyCharm中禁用双击Shift触发全局搜索的功能,通过Registry修改ide.suppress.double.click.handler实现。同时提供两种解决Ctrl+Shift+F快捷键失效的方法:关闭输入法冲突快捷键或重新映射Find in Path命令,确保开发效率。
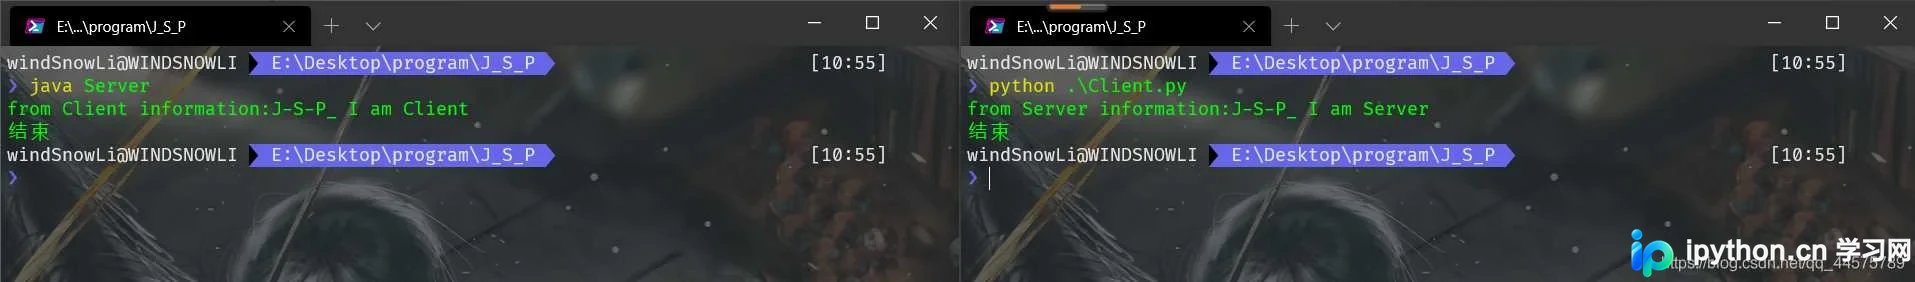
本文详细演示了Python客户端与Java服务端通过Socket进行单线程通信的完整实现。涵盖Java服务端监听端口2580、接收数据并返回响应的代码,以及Python客户端连接、发送消息并接收结果的示例。通过具体代码片段,帮助开发者快速掌握跨语言Socket通信的基本流程与关键参数设置。
本文介绍如何使用Python连接MySQL数据库,从题库中随机抽取选择题、填空题等试题,并利用python-docx库自动生成包含答案的Word格式试卷。文章涵盖环境准备、数据库结构示例及完整核心代码,支持生成多份不重复的试卷。
本文详解Python jieba库的三种核心分词模式:精确模式、全模式及搜索引擎模式,并通过代码实例展示jieba.cut()、jieba.lcut()及jieba.cut_for_search()的具体用法与输出差异。此外,文章还介绍了利用jieba.posseg模块进行词性标注及动词提取的实操方法,帮助开发者掌握中文文本处理的关键技术。