

Python网络爬虫入门:三种抓取方式对比与Lxml实战
本文介绍Python网络爬虫的三种常见网页抓取方法:正则表达式、Beautiful Soup和Lxml。重点对比了各模块的性能与适用场景,指出Lxml因基于C语言实现而兼具速度与健壮性。文章提供了Lxml及其依赖模块cssselect的详细安装命令,并附带完整的Python代码示例,演示如何利用urllib和lxml下载网页、解析HTML并批量保存图片。
2026-10-13
22

本文介绍Python网络爬虫的三种常见网页抓取方法:正则表达式、Beautiful Soup和Lxml。重点对比了各模块的性能与适用场景,指出Lxml因基于C语言实现而兼具速度与健壮性。文章提供了Lxml及其依赖模块cssselect的详细安装命令,并附带完整的Python代码示例,演示如何利用urllib和lxml下载网页、解析HTML并批量保存图片。
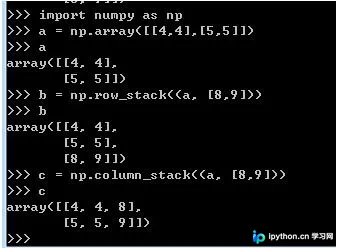
本文介绍在Python中使用NumPy库向现有矩阵增加行或列的具体方法。通过np.row_stack()函数可实现垂直方向追加新行,而np.column_stack()则用于水平方向追加新列。文章提供了基于二维数组的基础代码示例,展示如何构造输入矩阵及目标向量,并生成包含新增行或列的新矩阵结果,供开发者参考应用。
本文详细介绍如何使用Python开发一个灵活的代码行数统计工具。通过逐行解析文件,利用状态标识处理单行与多行注释,并抽象配置常量以支持Python、PHP、Java等多种编程语言。文章涵盖从简化版单文件统计到递归遍历目录、支持命令行参数指定语言类型的完整实现过程,帮助开发者快速掌握项目代码规模分析方法。
本文介绍在Python图像处理场景中遍历NumPy数组的两种方法。首先通过获取数组形状确定行列数,利用双重循环遍历元素;其次介绍使用np.nditer进行高效遍历。文章提供了具体代码示例,帮助开发者理解不同遍历方式的实现细节与适用场景。
本文详解Python中利用Numpy构建二维数组及进行数据取值的方法,重点演示Matplotlib库在数据可视化中的应用。内容涵盖线图、散点图及直方图的代码实现与参数解析,帮助开发者快速掌握基础数据处理与可视化技能。
本文针对Python 2.7安装后缺失scripts文件夹导致pip无法使用的问题,提供了一套排查与修复方案。若更换安装包无效,可通过下载ez_setup.py脚本生成scripts目录,并利用easy_install手动安装pip,最后配置环境变量即可完成修复。
本文详解在NumPy中如何准确提取数组的特定行和列。指出直接通过索引列表提取会导致获取对角线元素而非子矩阵的常见误区,并给出正确的两步切片法:先按行索引筛选,再按列索引筛选,确保获得预期的子数组结果。
本文通过定义包含__del__方法的特殊类,演示Python中浅复制对对象生存周期的影响。实验表明,浅复制生成的列表仅持有原对象的引用,删除原列表不会立即触发对象销毁。当所有对象引用被清除后,垃圾回收机制才会调用__del__释放资源。文章对比了直接赋值与浅复制的行为差异,帮助开发者理解Python内存管理机制。
本文介绍使用Python将指定目录下的图片批量读取并通过GridFS存入MongoDB数据库的方法。核心步骤包括建立数据库连接、遍历图片文件、利用StringIO和bson.binary处理二进制数据,最后通过GridFS的put方法存储。文中附带完整代码示例,涵盖图片显示与存储逻辑,供开发者参考实现。
本文介绍使用Python socket模块构建简单聊天室的方法。服务端利用select模块监控多个socket连接,实现非阻塞I/O;客户端在Windows环境下因select限制,采用多线程分别处理用户输入与socket通信。代码包含完整的服务器与客户端实现,支持消息广播与离线处理,适合学习网络编程基础。
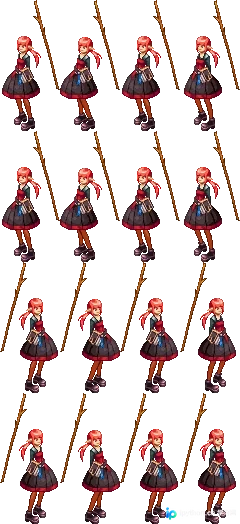
本文介绍在Ubuntu系统中使用Python结合PIL库自动化处理游戏角色行走素材的方法。通过将整张角色图切分为多个小图,解决直接导入TexturePacker的问题,提升游戏加载效率并便于资源管理。
本文介绍如何在Python中实现读取Properties配置文件的功能。虽然Python标准库未直接提供该操作,但通过自定义类可轻松实现。文章包含完整代码示例及调用方法,帮助开发者快速掌握相关技巧。