

Python统计数组元素频次:从暴力排序到桶计数法
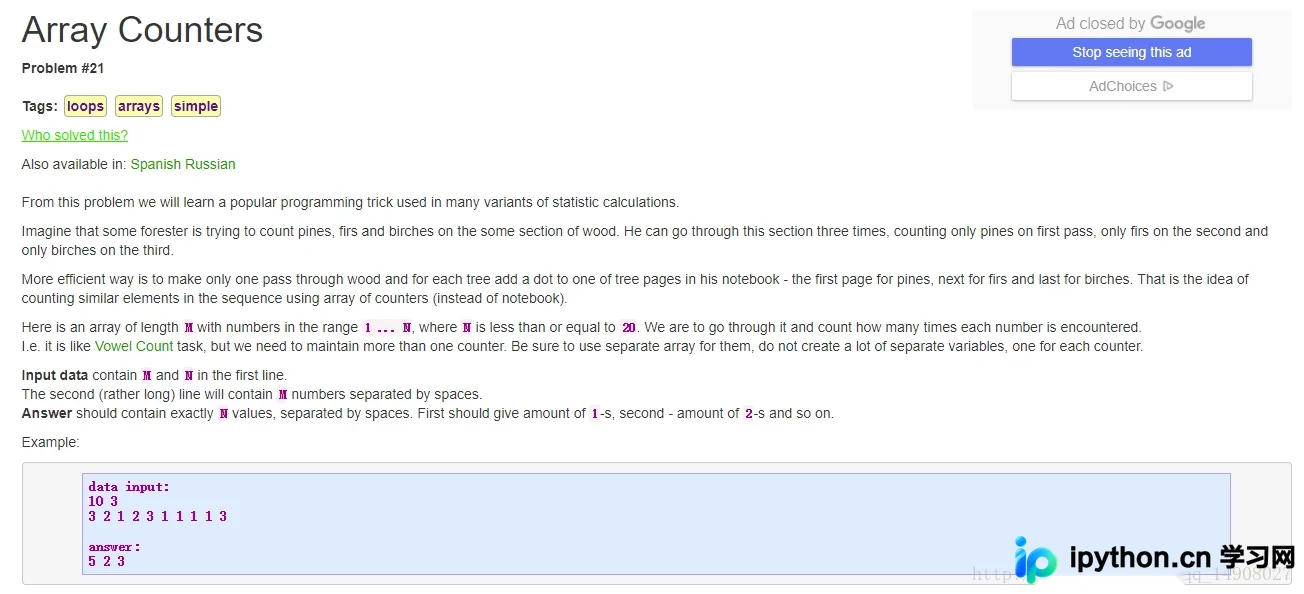
本文介绍在Python中统计数组元素出现次数的两种方法。首先分析基于排序的暴力解法,指出其逻辑复杂且效率较低。随后重点讲解利用“桶”思想的优化方案,通过固定长度数组直接映射元素频次,实现O(N)时间复杂度。最后延伸介绍基于桶统计结果的桶排序实现,展示如何将频次统计与排序结合,适用于元素范围有限的场景。
2026-10-13
22

本文介绍在Python中统计数组元素出现次数的两种方法。首先分析基于排序的暴力解法,指出其逻辑复杂且效率较低。随后重点讲解利用“桶”思想的优化方案,通过固定长度数组直接映射元素频次,实现O(N)时间复杂度。最后延伸介绍基于桶统计结果的桶排序实现,展示如何将频次统计与排序结合,适用于元素范围有限的场景。
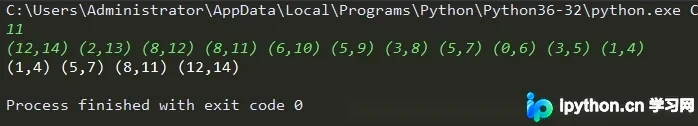
本文深入解析Python中贪心算法在解决活动安排问题中的应用。通过按结束时间排序并迭代选择相容活动,实现最大活动数量计算。文章提供完整的冒泡排序与贪心选择代码示例,详细阐述局部最优到全局最优的转化逻辑及代码执行流程,帮助开发者掌握区间调度算法的核心实现。
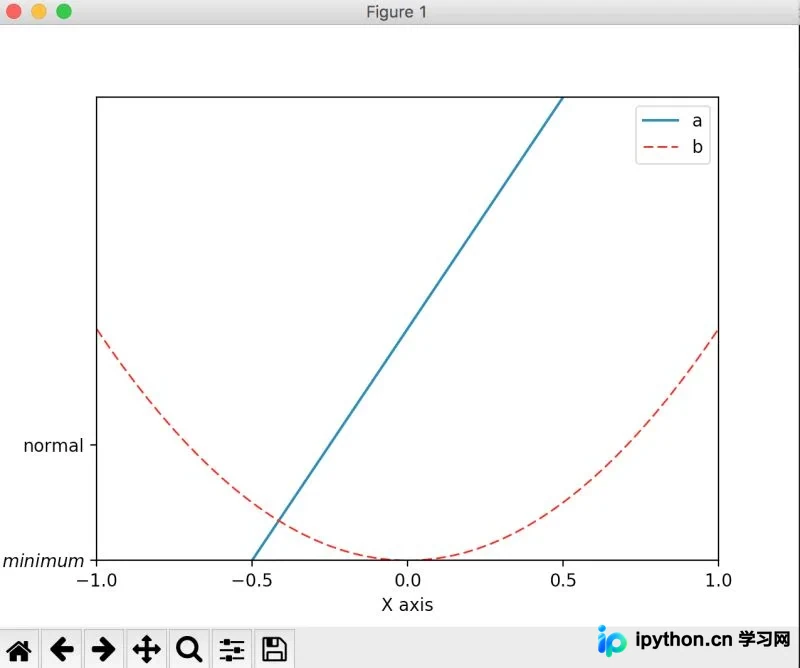
本文介绍Matplotlib中设置图例(legend)的基本用法。通过示例代码展示如何在绘制曲线时添加标签,并使用plt.legend()函数自定义图例的句柄、标签文本及显示位置。包含完整的坐标轴设置与刻度调整代码,帮助开发者快速掌握图例配置技巧。
本文深入探讨Python中矩阵加法和乘法的实现方式。通过对比传统循环实现的“反例”与利用列表推导式的简洁写法,展示了Python处理二维数组的高效技巧。文章提供了矩阵加法及乘法(含标量乘矩阵)的具体代码示例,帮助开发者掌握更Pythonic的编程风格。
本文介绍在Python中如何结合*解包技巧与itertools.product()函数来计算两个列表的笛卡尔积。通过eval()解析字符串后,利用*操作符将元组参数解包传入product函数,从而解决直接传参报错的问题,并总结相关核心技巧。
本文详解Python中CSV文件的读取与写入方法。通过鸢尾花数据集示例,演示如何将CSV直接转换为Dict列表或DataFrame对象。针对大数据量场景,提供逐条处理并写入的建议,以及使用writerows批量写入的技巧。此外,还涵盖从Zip压缩包中直接读取CSV、DataFrame导出CSV以及TXT文件转换等实用代码片段,帮助开发者高效处理结构化数据。
本文探讨Python中处理大文件解压与读取的常见问题,重点解决因编码格式不一致导致的解压失败。通过引入'ignore'参数规避严格编码检查,并对比不同读取方式的性能,验证了逐行读取处理百万级数据行的可行性与效率,为大数据文件操作提供参考。
本文深入解析Python中的分配排序法,重点介绍桶排序与基数排序的实现原理。桶排序通过划分区间将数据均匀分布至各桶,适用于特定范围的数据;基数排序则利用多关键字特性,分别采用最高位优先(MSD)与最低位优先(LSD)策略进行排序。文章提供了完整的Python代码示例,展示如何利用字典高效实现桶排序,并详细解析基数排序中按位分配与收集的核心逻辑,帮助读者掌握这两种高效排序算法的应用。
本文分析Python使用numpy.loadtxt读取CSV文件时出现的SyntaxError错误,主要原因为Windows路径中的反斜杠引发Unicode转义问题。通过原始字符串、双反斜线或正斜径修复路径后,对比了原生列表解析、numpy及pandas三种读取方式,提供实用代码示例与性能参考。
本文介绍利用Python生成均匀分布在任意三角形内的随机点的方法。通过结合贝塔分布与线性插值,确保点在三角形内均匀分布,并推广至任意多边形。提供完整代码示例及可视化效果,适用于机器学习数据增强等场景。
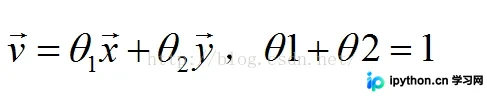
本文详解在 Ubuntu 16.04 系统中为 PyCharm 创建桌面快捷启动的方法。通过修改 /usr/share/applications 下的 .desktop 文件,配置 Exec 和 Icon 路径,并赋予执行权限,实现双击桌面图标直接运行 PyCharm,避免每次手动执行脚本的繁琐操作。
本文介绍使用Python定期清理本地目录下创建时间超过一年的文件。首先通过os模块遍历目录手动删除,随后利用shutil模块简化操作。重点讲解如何结合datetime和os.path.getctime判断文件创建时间,实现仅删除过期文件而保留文件夹结构的自动化脚本。