

Python使用python-docx在Word中插入本地图片及格式异常处理
本文介绍如何使用Python的python-docx库在Word文档中插入本地图片。通过示例代码展示基础插入方法,并针对插入特定格式图片时可能出现的异常问题,提供基于PIL库进行格式转换的解决方案,确保图片能正确嵌入Word文档。
2026-10-15
18

本文介绍如何使用Python的python-docx库在Word文档中插入本地图片。通过示例代码展示基础插入方法,并针对插入特定格式图片时可能出现的异常问题,提供基于PIL库进行格式转换的解决方案,确保图片能正确嵌入Word文档。
本文详细解析Python3中使用sqlite3进行数据库连接、建表、数据插入及查询的完整流程。重点讲解如何正确使用参数化查询防止SQL注入,并针对自增字段起始位置重置提供具体解决方案。文章通过代码示例展示了从基础连接到高级查询的实战技巧,帮助开发者规避常见语法陷阱。
本文详细介绍如何使用Python实现高效的遗传算法。内容涵盖算法核心概念如适应度计算、二进制编码策略、交叉变异操作及种群淘汰机制。通过具体代码示例,展示如何初始化种群、计算染色体长度并迭代优化,适用于函数优化及模型训练场景。
本文深入解析Python解决“小明种苹果”问题的多种实现方式,重点探讨环形数组中连续三棵树掉落情况的统计方法。通过对比索引取余、列表拼接及直接遍历等策略,提供一种从列表尾部开始读取的简洁代码方案,并附带其他常见解法供参考,旨在帮助开发者更高效地处理此类边界条件复杂的算法题。
本文详细介绍Python中Num库对文本文件、CSV格式及二进制文件的读写操作。通过savetxt与loadtxt函数实现TXT/CSV数据的存取,利用save、savez及load函数处理.npy与.npz二进制格式,涵盖参数配置、编码设置及多数组存储等核心功能。
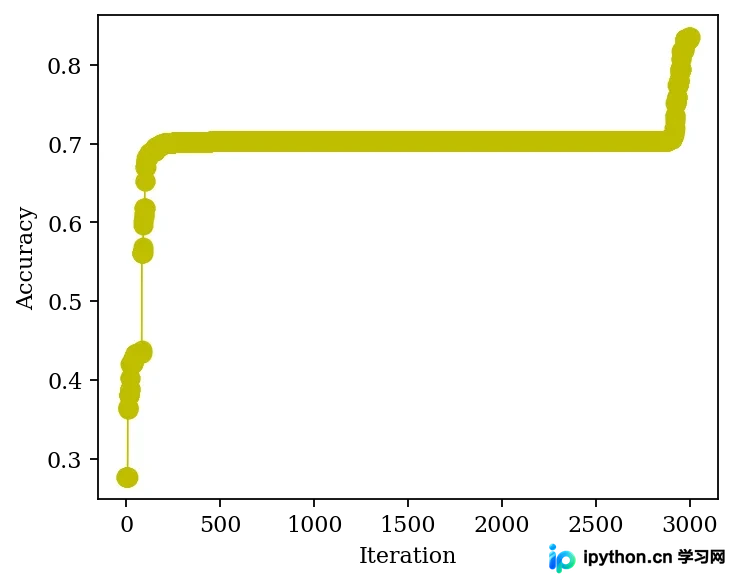
本文通过Python代码实验,探讨共轭梯度法(CG)在求解线性方程组时,迭代次数与矩阵特征值分布的关系。实验对比了特征值完全聚堆、分散及不同精度下的聚堆情况,结果表明:当特征值差异小于迭代精度时,可视为聚堆,迭代次数近似等于独立特征值簇的数量。
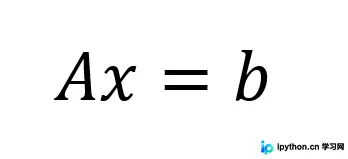
本文详细介绍Python标准库timeit模块的三种核心用法:timeit()函数、repeat()函数以及Timer类。重点解析各函数的参数含义,包括stmt、setup、number及repeat等关键字参数的配置方法,并通过代码示例展示如何准确测量代码片段的执行时间,帮助开发者进行高效的Python性能分析。
本文介绍如何使用Python的Pandas库对CSV文件进行行列删除操作。通过read_csv读取数据,利用drop函数指定axis参数删除指定列或行,并设置inplace参数控制是否修改原数据。最后通过to_csv保存结果,支持指定编码和索引显示。
本文深入解析Python中property装饰器的使用方法,对比传统get/set函数与property的实现差异。通过年龄验证示例,展示如何利用@property和@age.setter实现简洁的属性访问与赋值控制,并详细列出只读属性设置、私有成员修饰及循环错误等关键注意事项,帮助开发者提升代码安全性与可读性。
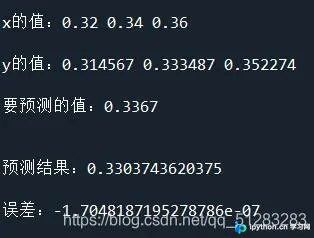
本文介绍如何使用Python实现拉格朗日插值算法,并通过Matplotlib库进行结果可视化。代码包含输入处理、基函数计算、预测值求解及误差分析,同时绘制理论曲线与预测曲线对比图,帮助读者理解插值原理及编程实现细节。
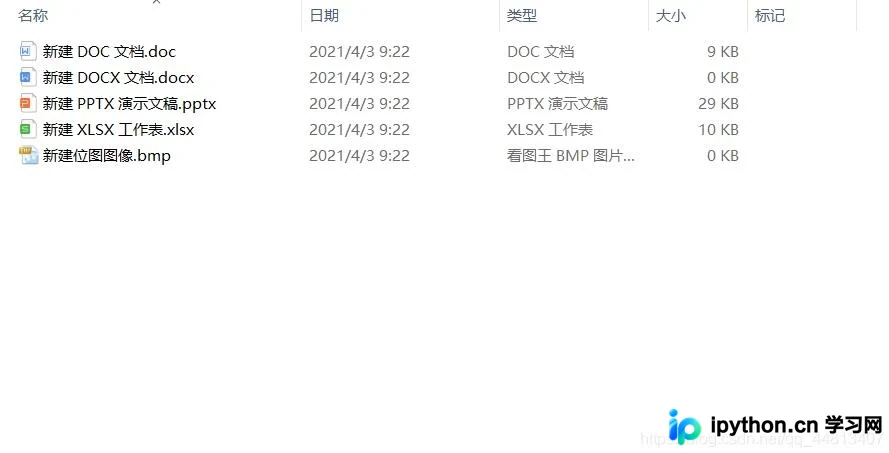
本文介绍使用Python批量提取指定文件夹内同类型文件的实现方法。通过实例代码展示如何遍历文件夹、判断文件后缀并复制到目标路径,帮助读者快速掌握文件批量处理技巧。
本文介绍如何利用Python的xlrd和xlwt模块合并多个Excel文件中的多个Sheet。核心思路是将不同文件的相同Sheet内容视为列合并,再将不同Sheet内容视为行合并。通过遍历列表一次性写入数据,避免追加写入限制,最终生成包含所有源文件内容的单一Excel文件。